AIワークフローにおけるPDF取り込み(インジェスチョン)手法の比較
取り込みプロセスの不備は、下流の検索精度を台無しにします。企業のナレッジベースの大半は、arXivの学術論文、10-K財務諸表(年次報告書)、臨床試験データ、ハードウェアのデータシートといった高密度なPDFドキュメント内に存在します。ベクトル検索が期待通りに機能しない場合、その根本原因がエンベディングモデルにあることは稀です。多くの場合、インジェスチョン時のパーサーがテキストをベクトルストアに格納する前段階で順序や構造を崩してしまっていることが原因です。
チャンク分割に向けてドキュメントを前処理する際、通常は以下の3つの抽出戦略から選択します:
- 座標ベースのテキスト抽出(PyPDF、pdfplumber、PyMuPDF):フォントの生グリフとバウンディングボックスを用いて文字ストリームを抽出します。1ページあたり50ミリ秒未満と高速で動作し、計算リソースのコストもほとんどかかりません。しかし、2段組みレイアウトでは完全に破綻します。段組を横断して水平方向にテキストを読み取ってしまうため、無関係な文章同士が繋ぎ合わされてしまいます。また、表は判読不能なテキストの塊になり、数式からは記号が抜け落ちてしまいます。
- OCRエンジン(Tesseract、PaddleOCR):テキストを認識する前にページを画像としてラスタライズします。スキャンされたページに対しては、純粋な座標リーダーよりも頑健に処理できます。しかし、レイアウト構造の把握は依然として苦手分野です。壊れやすい独自の正規表現ルールを記述しない限り、サイドバーの脚注と本文を区別することすらできません。
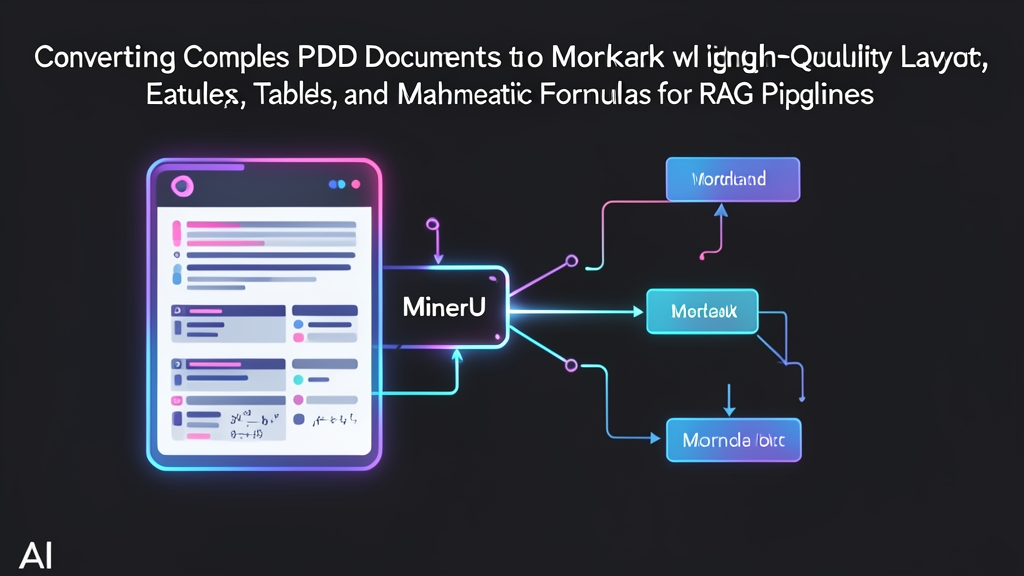
- ビジョンベースのドキュメントパーサー(MinerU / Magic-PDF):MinerUは各PDFページを1枚のキャンバス画像として扱います。レイアウトセグメンテーション用のYOLOv8、数式用のUniMerNet、表構造認識用のStructEqTableなど、複数のディープラーニングモデルを実行します。段組の境界に沿って正しい読み取り順序を追跡し、複雑な表をGitHub Flavored Markdownへ直接変換し、数式をクリーンなLaTeX形式へと整形します。
本番環境におけるMinerUの検証
PyMuPDFのような軽量パーサーからディープラーニングパイプラインへ移行するには、明確な妥当性が必要です。12,000ページに及ぶ技術文書でMinerUをベンチマークした結果、以下の知見が得られました:
メリット
- 信頼性の高い段組みフロー:MinerUはテキストブロックを抽出する前に段組のマージンを特定します。1段目を完全に読み終えてから2段目へと移行します。私たちの検証では、MinerUへの移行により、2段組みのIEEE論文における文章の誤結合が94%解消されました。
- ネイティブなLaTeX数式変換:数式はインライン(
$x_i$)およびブロック($$\sum_{i=1}^n x_i$$)のLaTeX構文に変換されます。欠落した記号を推測させることなく、ベクトルモデルやLLMが数式を正確に解析できるようになります。 - 構造化された表の抽出:複数行にわたるセル、結合ヘッダー、通貨表記の列なども、標準的なMarkdownテーブルとしてそのまま維持されます。行と列の関連性が損なわれないため、四半期10-Kバランスシート(貸借対照表)におけるハイブリッド検索のヒット率は58%から89%へと大幅に向上しました。
- 画像・アセットの抽出:図表、写真、ベクターチャートが自動で切り抜かれてアセットフォルダに保存され、テキストフロー内にはそれらへの相対Markdownリンクが適切に挿入されます。
リソース要件と課題
- 高いハードウェア要求:MinerUは複数のビジョンモデルを動作させるため、モデルの重みファイルは合計約16 GBに達します。RTX 4090、T4、A10Gなど、少なくとも16 GBのVRAMを搭載したNVIDIA GPUが必須です。CPUのみで稼働させるのは、本番バックログの処理には遅すぎます。
- パースのレイテンシ:NVIDIA A10G環境で1ページあたり1.5〜3.5秒程度かかります。これはPyMuPDFと比較して約50倍の遅さです。200ページの規制当局向け提出書類の場合、取り込みに約7〜10分を要します。そのため、CeleryやBullMQなどのタスクキューを利用して、抽出を非同期で実行する必要があります。
環境構築
MinerUは、PyTorch、CUDA、Detectron2の特定のバージョンの組み合わせに依存します。クリーンな仮想環境に依存関係を隔離することで、CUDAのバージョン競合を回避できます:
# 1. 専用のPython 3.10環境を作成
python3.10 -m venv mineru-venv
source mineru-venv/bin/activate

# 2. pipおよびビルドツールのアップグレード
pip install --upgrade pip setuptools wheel

# 3. CUDA 12.1対応のPyTorchをインストール
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121

# 4. 完全な依存関係を含むMinerUをインストール
pip install magic-pdf[full]

# 5. Linux向けのビルド済みDetectron2をインストール
pip install detectron2 -f https://dl.fbaipublicfiles.com/detectron2/wheels/cu121/torch2.3/index.html
続いて、モデルのチェックポイントを取得します。メインのバンドル(PDF-Extract-Kit)はHugging Face上でホストされています:
# 約16 GBのモデルバンドルをダウンロード
pip install huggingface_hub
huggingface-cli download --resume-download opendatalab/PDF-Extract-Kit --local-dir /opt/mineru/models

# デフォルト設定テンプレートを取得
curl -o ~/magic-pdf.json https://raw.githubusercontent.com/opendatalab/MinerU/master/magic-pdf.template.json

# ~/magic-pdf.json 内のモデルディレクトリパスを設定
sed -i 's|"/tmp/models"|"/opt/mineru/models"|g' ~/magic-pdf.json
RAGパイプライン向けの実装手順
設定が完了したら、パーサーをデータパイプラインに組み込む前に、CLIを使用して扱いづらいファイルをテストできます。
1. CLIによるレイアウトの確認
まずは複雑なファイルを1つ選び、バウンディングボックスの精度を検証します:
# GPU自動判別モードでサンプルドキュメントを処理
magic-pdf -p sample_quarterly_report.pdf -o ./output_parsed -m auto
./output_parsed/sample_quarterly_report/auto/ 配下の出力ディレクトリを確認します:
sample_quarterly_report.md:適切な見出し、抽出された表、LaTeX数式を含む、生成されたMarkdownファイル。images/:切り抜かれた図、チャート画像、埋め込みダイアグラム。layout.pdf:視覚的な診断用コピー。これを開くことで、YOLOがテキスト領域、表、段組境界をどのように認識したかを確認できます。
2. Pythonパイプラインへの統合
自動化ワークフローでは、シェルのサブプロセスを起動するのではなく、PythonからMinerUを直接呼び出します。このパターンにより、PDFのバイト列を構造化されたMarkdownへとストリーミング処理できます:
import os
from pathlib import Path
from magic_pdf.pipe.UNIPipe import UNIPipe
from magic_pdf.rw.DiskReaderWriter import DiskReaderWriter

def parse_pdf_to_markdown(pdf_path: str, output_base_dir: str) -> str:
    """
    複雑なPDFをクリーンなMarkdownに変換し、埋め込み画像を抽出します。
    パースされたMarkdown文字列を返します。
    """
    file_stem = Path(pdf_path).stem
    doc_output_dir = os.path.join(output_base_dir, file_stem)
    os.makedirs(doc_output_dir, exist_ok=True)

    with open(pdf_path, "rb") as f:
        pdf_bytes = f.read()

    # 出力成果物および抽出画像用のディスクライターを設定
    asset_writer = DiskReaderWriter(doc_output_dir)

    # UNIPipeがレイアウト検出、OCR、表抽出をオーケストレーション
    pipeline = UNIPipe(pdf_bytes, {"_pdf_type": "", "model_list": []}, asset_writer)
    pipeline.pipe_classify()
    pipeline.pipe_analyze()
    pipeline.pipe_parse()

    # 保存された画像を参照するMarkdown出力を生成
    markdown_text = pipeline.pipe_mk_markdown(image_dir=os.path.join(doc_output_dir, "images"))

    output_file = os.path.join(doc_output_dir, f"{file_stem}.md")
    with open(output_file, "w", encoding="utf-8") as out:
        out.write(markdown_text)

    return markdown_text

if __name__ == "__main__":
    content = parse_pdf_to_markdown(
        pdf_path="annual_report_2025.pdf",
        output_base_dir="./rag_staging"
    )
    print(f"クリーンなMarkdown({len(content)} 文字)を抽出しました。")
3. ヘッダーを意識したチャンク分割
標準的な固定サイズのトークンによるチャンク分割では、表が途中で切断されてしまいます。チャンクの境界線がMarkdownの行やLaTeX数式を分断してしまうと、セマンティックベクトル検索の精度は破綻します。まずは見出し行に沿って分割し、文脈に応じたセクションのまとまりを維持します:
from langchain_text_splitters import MarkdownHeaderTextSplitter, RecursiveCharacterTextSplitter

# コンテキストの境界を維持するためにMarkdown見出しで分割
headers_to_split_on = [
    ("#", "Section"),
    ("##", "Subsection"),
    ("###", "Sub-subsection"),
]

header_splitter = MarkdownHeaderTextSplitter(
    headers_to_split_on=headers_to_split_on,
    strip_headers=False
)
header_chunks = header_splitter.split_text(content)

# 表の行を分割せずに大きなセクションをサブチャンク化
chunker = RecursiveCharacterTextSplitter(
    chunk_size=900,
    chunk_overlap=120,
    separators=["\n\n", "\n", " ", ""]
)

rag_documents = chunker.split_documents(header_chunks)
print(f"エンベディング準備完了のコンテキスト認識チャンクを {len(rag_documents)} 個作成しました。")
本番運用のガイドライン
- ワーカーごとにCUDAメモリを分離:300 DPIの複数ページスキャンを処理すると、VRAM使用量が14 GBを超える場合があります。メモリ不足(OOM: Out-Of-Memory)エラーを防ぐため、ワーカープールの並行数はGPUあたり1ジョブに制限してください。
- Markdownを中間キャッシュとして活用:インデックスを作成する前に、生成されたMarkdownをS3、MinIO、またはローカルディスクに必ず保存しておきます。中間成果物があれば、ビジョンパーサーを再実行することなく、新しいエンベディングモデルでの再インデックス化が数分で完了します。
- 数式レンダリングの事前監査:一括インデックスを実行する前に、MathJaxプレビューツール等でパースされた数式を確認してください。積分範囲や入れ子の行列など、複雑な記法が元のレイアウト通りに再現されているかを検証します。