背景と導入の理由
午前2時14分、役員向けレポーティングボットのアラート急増によってPagerDutyに叩き起こされました。経営陣が第3四半期の収益に関する基本的な質問をしたところ、システムが根拠のないデタラメな数値をでっち上げていたのです。トレースログを確認すると、原因は一目瞭然でした。
OCRワーカーが、ネストされた脚注を含む3列構成の財務表をズタズタに解釈していました。すべてを支離滅裂な生のテキスト文字列へと平坦化し、既存パイプラインがそれを盲目的にチャンク分割してpgvectorに埋め込んでいたのです。LLMには完全にゴミ同然のコンテキストが渡され、当然ながら確信に満ちたハルシネーションを引き起こしました。
多くの本番RAGスタックは、未だにこのような脆弱なパイプラインに依存しています。PDFの生ストリームを抽出するかPaddleOCRを実行し、マークダウンを整形し、テキストを機械的に500トークン単位で分割し、dense embeddingを計算してベクトル検索を実行する——。複雑なレイアウトに遭遇するまでは、すべて順調に動いているように見えます。しかし、貸借対照表の列座標は失われ、2段組のホワイトペーパーは縦ではなく横方向に誤読され、グラフやインフォグラフィックスは跡形もなく消え去ります。
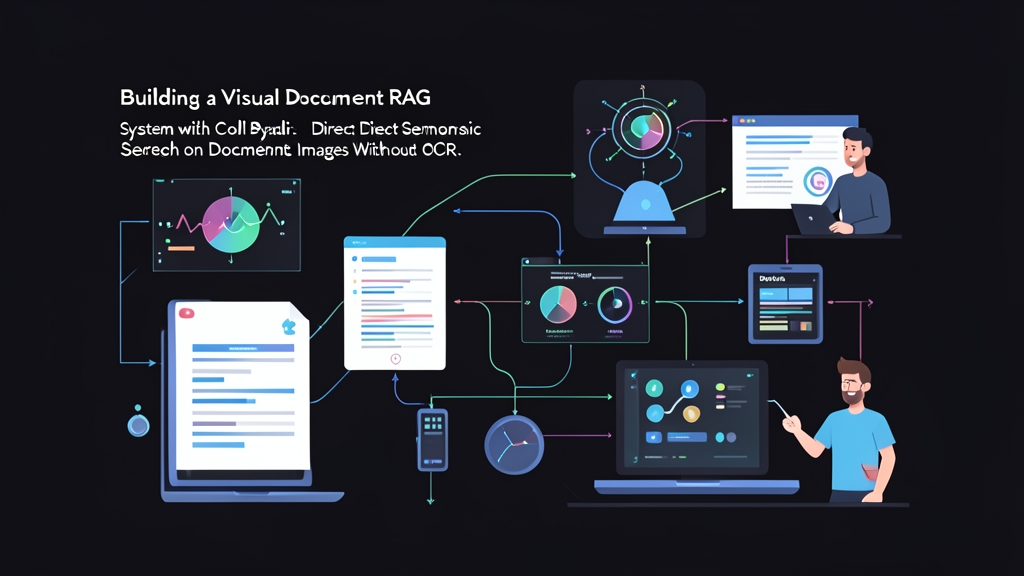
ColPaliは、テキスト抽出プロセスを完全にバイパスします。レイアウトの流れを推測する代わりに、各PDFページを448×448の画像としてラスタライズし、Vision-Language Model(PaliGemma-3Bベース)へ直接入力します。
このモデルは、ColBERTスタイルのlate interaction(MaxSim)を用いて、画像パッチごとのマルチベクトル埋め込み(1ページあたり128次元のベクトルが約1,030個)を出力します。Byaldiは、このColPaliをわずか数行のコードで実行可能なインデクサーとしてパッケージ化したPythonラッパーです。表、タイポグラフィ、見出し、スパークラインが、本来あるべき視覚的な位置関係を保ったまま保持されます。
テキスト抽出器を捨てて視覚的late-interactionに移行したことで、Form 10-K(年次報告書)や複雑な技術マニュアルにおけるドキュメント解析バグはゼロになりました。自社インフラ上でこれを稼働させる手順を以下に解説します。
インストール
ColPaliは画像パッチ全体にわたってトークン表現を計算します。推論自体は比較的軽量ですが、インデックスの構築には十分なGPUメモリが必要です。少なくとも16GBのVRAMを搭載したNVIDIAカード(RTX 4090、A5000、またはクラウドのA10Gインスタンスなど)を用意してください。
まず、システムレベルのPDFレンダリングパッケージをインストールします。Byaldiは内部でpdf2imageを使用してページを画像に変換するため、poppler-utilsが必要です。
# Ubuntu / Debian のセットアップ
sudo apt-get update && sudo apt-get install -y poppler-utils libgl1-mesa-glx

# poppler バイナリの存在を確認
pdftoppm -v
PyTorchとCUDAを備えた独立した仮想環境を構築します。テンソル演算中の予期せぬセグメンテーション違反を防ぐため、CUDAランタイムとPyTorchホイールのバージョンを必ず一致させてください。
# 仮想環境の作成とアクティベート
python3 -m venv venv-byaldi
source venv-byaldi/bin/activate

# CUDA 12.1 対応の PyTorch をインストール
pip install --upgrade pip
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121

# 順伝播を高速化するため Byaldi と Flash Attention 2 をインストール
pip install byaldi
pip install flash-attn --no-build-isolationflash-attnのコンパイルエラーが発生する場合は、CUDA_HOMEパスが完全なCUDAツールキット(例: /usr/local/cuda)を指しているか確認してください。ビルドツールがない環境で実行する場合は、flash-attnをスキップしても構いません。PyTorchネイティブのSDPAがフォールバックとして機能します。
設定と実装
Byaldiは、ドキュメントの読み込み、埋め込み生成、およびインデックスの永続化を標準で処理します。ベースチェックポイントであるvidore/colpali-v1.2は、多言語ドキュメント、スキャン画像、高密度なレポート全体で優れたゼロショット精度を発揮します。
以下のスクリプトをindexer.pyとして保存し、PDFのディレクトリ全体を一括インデックス化します:
import os
from byaldi import RAGMultiModalModel

INDEX_NAME = "financial_reports_index"
DOCS_DIR = "/var/data/pdf_vault"

def build_document_index():
    print("[INIT] ColPali モデルを VRAM にロード中...")
    RAG = RAGMultiModalModel.from_pretrained(
        "vidore/colpali-v1.2",
        verbose=1
    )

    print(f"[INDEX] {DOCS_DIR} をスキャンしてページをインデックス化中...")
    RAG.index(
        input_path=DOCS_DIR,
        index_name=INDEX_NAME,
        store_collection_with_index=True,
        overwrite=True
    )
    print(f"[SUCCESS] インデックスが .byaldi/{INDEX_NAME} に書き込まれました")

if __name__ == "__main__":
    os.makedirs(DOCS_DIR, exist_ok=True)
build_document_index()インデックスを構築したら、検索サービス(search.py)を作成します。このステップでは、元のPDFドキュメントをメモリに再ロードすることなく、事前に計算されたベクトルをクエリします。マッチ度の高いページ番号、ファイルID、およびページ全体の画像スナップショットが返されます。
from byaldi import RAGMultiModalModel

INDEX_NAME = "financial_reports_index"

def query_visual_rag(query_text: str, top_k: int = 3):
    # シリアライズされたインデックスをロード
    RAG = RAGMultiModalModel.from_index(INDEX_NAME)

    # late-interaction MaxSim 検索を実行
    results = RAG.search(query=query_text, k=top_k)

    print(f"\nクエリ: '{query_text}'")
    print(f"{len(results)} 件の一致を返しました:\n" + "-" * 45)

    for rank, hit in enumerate(results, start=1):
        doc_id = hit.doc_id
        page_num = hit.page_num
        score = hit.score
        print(f"#{rank} | ドキュメント: {doc_id} | ページ: {page_num} | スコア: {score:.3f}")

        # ヒント: hit.base64 を Claude 3.5 Sonnet や GPT-4o などのマルチモーダルモデルに直接送信可能
        # page_base64 = hit.base64

    return results

if __name__ == "__main__":
    # ネストされた表データに対するテストクエリ
    query_visual_rag("2024年第3四半期のヨーロッパ全域における営業利益率はいくらでしたか?")
検証とモニタリング
ベースラインとなるベンチマークを測定せずに、ビジュアル検索を本番環境へ投入してはいけません。検索の関連性と、実トラフィック下におけるGPUの安定性の両方を検証する必要があります。
1. レイアウト検索精度の検証
標準的なテキストパーサーが頻繁に誤認するようなクエリを用いて結合テストを作成します。枠線のないテーブル深部のセル値、脚注、グラフ内の凡例ラベルなどが最適な検証対象です。
# クエリ実行レイテンシの測定
python -m timeit -n 10 -s "from search import query_visual_rag" "query_visual_rag('2024年度 EBITDAマージン')"実際の運用において、ColPaliのMaxSim類似度スコアは12.0から28.0の範囲に収まります。19.5を超えるスコアは、セマンティックおよび視覚的な一致度が高いことを確実に示しています。上位ヒットのスコアが14.0未満に留まる場合、そのドキュメントに答えが含まれていないか、クエリの言い換えが必要です。
2. GPU VRAMとバッチサイズのモニタリング
高解像度PDF(300〜600 DPIのスキャンなど)のラスタライズは、バッチ取り込み中に膨大なGPUメモリを消費します。放置すると即座にCUDA OOM(メモリ不足)パニックに直結します。
取り込み中はターミナルを開いたままにして、VRAMの消費量を監視してください:
watch -n 1 nvidia-smi --query-gpu=timestamp,utilization.gpu,memory.used,memory.total --format=csv16GB GPUでメモリ使用率が85%を超えた場合は、取り込み前にPDFアセットをダウンサンプリングします。Ghostscriptを軽く適用するだけで、PaliGemmaの視認性を維持しながらファイル容量を削減できます:
# 重い 600 DPI スキャンを 150 DPI スクリーン解像度にダウンサンプリング
gs -sDEVICE=pdfwrite -dCompatibilityLevel=1.4 -dPDFSETTINGS=/ebook \
   -dNOPAUSE -dQUIET -dBATCH -sOutputFile=optimized_doc.pdf raw_input.pdf
3. 本番環境のレイテンシとキャパシティプランニング
ビジュアル検索を採用すると、インフラのボトルネックとなる箇所が変化します。以下の本番ベンチマークを意識してください:
- クエリレイテンシ: 単一のA10G上で、クエリは120ms〜280ms以内で完了することが期待されます。600msを超えるレイテンシの急増は、通常、行列乗算中のCPUスレッド競合を示唆しています。
- ストレージフットプリント: 1ページあたり約3KBを消費する単一ベクトル埋め込みとは異なり、ColPaliはマルチベクトル表現を保存します。Byaldiのバイナリ/PLAID圧縮を使用した場合、インデックス化された100ページあたり約25MB〜40MBのディスク容量を見込んでください。
- グレースフルデグラデーション(優雅な縮退):
RAG.search()をtorch.cuda.OutOfMemoryErrorのtry/exceptブロックでラップしてください。VRAMが枯渇した場合は、ユーザーリクエストをエラーで落とすのではなく、torch.cuda.empty_cache()でPyTorchキャッシュを解放し、既存のBM25キーワードインデックスにフォールバックさせます。
ビジュアルドキュメント検索は、現代のRAGにおける最大の弱点を解決します。ページを平坦なテキスト文字列ではなく視覚的なキャンバスとして扱うことで、ColPaliとByaldiは壊れやすい正規表現や不安定なOCR処理に頼ることなく、複雑なレイアウトから信頼性の高い回答を提供します。