So sánh các phương pháp nạp PDF cho quy trình làm việc AI
Dữ liệu đầu vào kém chất lượng sẽ phá hỏng toàn bộ hiệu quả truy xuất phía sau. Hầu hết cơ sở tri thức của doanh nghiệp đều nằm trong các tài liệu PDF dày đặc thông tin: bài báo nghiên cứu arXiv, báo cáo tài chính 10-K, hồ sơ thử nghiệm lâm sàng và tài liệu thông số phần cứng. Khi tìm kiếm vector (vector search) thất bại, nguyên nhân hiếm khi nằm ở mô hình embedding. Thủ phạm thực sự là do bộ phân tích (parser) đã làm xáo trộn văn bản gốc trước cả khi nó kịp lưu vào vector store.
Các nhóm phát triển thường cân nhắc giữa ba chiến lược trích xuất sau khi chuẩn bị tài liệu cho bước phân đoạn (chunking):
- Trích xuất văn bản dựa trên tọa độ (PyPDF, pdfplumber, PyMuPDF): Các công cụ này đọc chuỗi ký tự dựa trên glyph font chữ và bounding box thô. Tốc độ xử lý rất nhanh—thường dưới 50ms mỗi trang—và hầu như không tốn tài nguyên tính toán. Tuy nhiên, bố cục hai cột sẽ khiến chúng hoàn toàn mất phương hướng. Chúng đọc tràn ngang qua các cột, ghép nối những câu rời rạc lại với nhau. Bảng biểu bị dồn nén thành những khối văn bản hỗn độn, còn công thức toán học thì mất sạch ký hiệu.
- Công cụ OCR (Tesseract, PaddleOCR): Các giải pháp này raster hóa trang tài liệu thành hình ảnh trước khi nhận diện ký tự. Chúng xử lý các trang scan tốt hơn bộ đọc tọa độ thuần túy. Dẫu vậy, việc hiểu cấu trúc bố cục vẫn là điểm yếu cố hữu. Chúng không thể phân biệt được chú thích lề với nội dung bài viết chính nếu thiếu các quy tắc regex tùy biến phức tạp và dễ gãy vỡ.
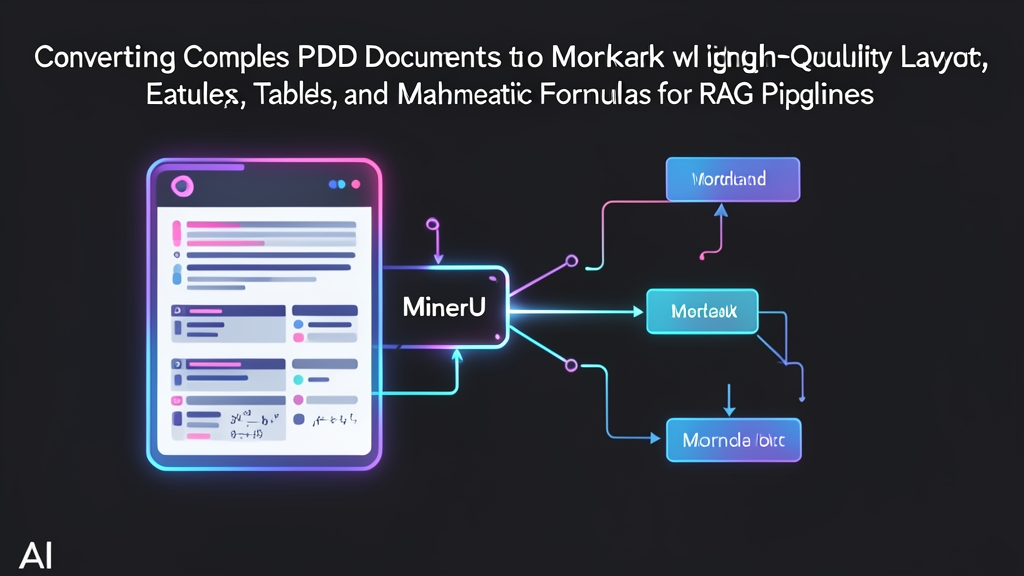
- Bộ phân tích tài liệu dựa trên thị giác máy tính (MinerU / Magic-PDF): MinerU xử lý mỗi trang PDF như một khung hình ảnh. Công cụ này chạy các mô hình học sâu—bao gồm YOLOv8 để phân đoạn bố cục, UniMerNet cho công thức toán và StructEqTable cho bảng biểu. Nó lần theo thứ tự đọc dọc theo ranh giới cột, chuyển đổi các bảng phức tạp trực tiếp sang GitHub-flavored Markdown và định dạng công thức toán thành cú pháp LaTeX chuẩn xác.
Đánh giá MinerU trong môi trường Production
Việc chuyển đổi từ một bộ phân tích siêu nhẹ như PyMuPDF sang một pipeline học sâu đòi hỏi những lý do thực sự thuyết phục. Dưới đây là kết quả đánh giá thực tế của chúng tôi sau khi benchmark MinerU trên 12.000 trang tài liệu kỹ thuật:
Ưu điểm
- Xử lý luồng văn bản nhiều cột chuẩn xác: MinerU cô lập lề của từng cột trước khi trích xuất các khối văn bản. Nó đọc trọn vẹn cột thứ nhất rồi mới chuyển sang cột thứ hai. Trong các thử nghiệm của chúng tôi, việc chuyển sang MinerU đã loại bỏ 94% lỗi ghép nhầm câu trên các bài báo IEEE hai cột.
- Chuyển đổi công thức toán sang LaTeX gốc: Các công thức toán học được chuyển đổi mượt mà thành cú pháp LaTeX nội dòng (
$x_i$) và khối ($$\sum_{i=1}^n x_i$$). Mô hình vector và LLM của bạn có thể hiểu đúng bản chất toán học thay vì phải đoán mò các ký hiệu bị thiếu. - Trích xuất bảng biểu có cấu trúc: Các ô nhiều dòng, tiêu đề phân nhánh và cột tiền tệ đều được giữ nguyên vẹn dưới dạng bảng Markdown tiêu chuẩn. Tỷ lệ khớp (hit-rate) của tìm kiếm lai (hybrid search) trên các bảng cân đối kế toán 10-K theo quý đã tăng vọt từ 58% lên 89% đơn giản nhờ mối quan hệ giữa hàng và cột được bảo toàn.
- Trích xuất tài nguyên hình ảnh: Biểu đồ, ảnh chụp và đồ họa vector được tự động cắt, lưu vào thư mục assets, đồng thời chèn sẵn các đường dẫn tương đối markdown tương ứng vào mạch văn bản.
Yêu cầu tài nguyên
- Đòi hỏi phần cứng mạnh: MinerU vận hành cùng lúc nhiều mô hình thị giác với tổng dung lượng trọng số khoảng 16 GB. Bạn cần một GPU NVIDIA có tối thiểu 16 GB VRAM—chẳng hạn như RTX 4090, T4 hoặc A10G. Việc chạy thuần trên CPU sẽ quá chậm để đáp ứng hàng đợi xử lý trong thực tế.
- Độ trễ khi phân tích: Dự kiến mất từ 1,5 đến 3,5 giây cho mỗi trang trên GPU NVIDIA A10G. Con số này chậm hơn khoảng 50 lần so với PyMuPDF. Với một bộ hồ sơ pháp lý dài 200 trang, quá trình nạp dữ liệu sẽ mất khoảng 7 đến 10 phút. Bạn bắt buộc phải thực hiện trích xuất bất đồng bộ thông qua các hàng đợi tác vụ như Celery hoặc BullMQ.
Thiết lập môi trường
MinerU yêu cầu sự tương thích chính xác giữa các phiên bản PyTorch, CUDA và Detectron2. Việc cô lập các dependency này trong một môi trường ảo riêng biệt sẽ ngăn ngừa nguy cơ xung đột phiên bản CUDA:
# 1. Tạo môi trường Python 3.10 riêng biệt
python3.10 -m venv mineru-venv
source mineru-venv/bin/activate

# 2. Nâng cấp pip và các công cụ build
pip install --upgrade pip setuptools wheel

# 3. Cài đặt PyTorch hỗ trợ CUDA 12.1
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121

# 4. Cài đặt MinerU với đầy đủ thư viện phụ thuộc
pip install magic-pdf[full]

# 5. Cài đặt Detectron2 đã biên dịch sẵn cho Linux
pip install detectron2 -f https://dl.fbaipublicfiles.com/detectron2/wheels/cu121/torch2.3/index.html
Tiếp theo, hãy tải về các checkpoint mô hình. Gói mô hình chính (PDF-Extract-Kit) được lưu trữ trên Hugging Face:
# Tải gói mô hình dung lượng khoảng 16 GB
pip install huggingface_hub
huggingface-cli download --resume-download opendatalab/PDF-Extract-Kit --local-dir /opt/mineru/models

# Lấy file cấu hình mẫu mặc định
curl -o ~/magic-pdf.json https://raw.githubusercontent.com/opendatalab/MinerU/master/magic-pdf.template.json

# Cấu hình đường dẫn thư mục mô hình bên trong ~/magic-pdf.json
sed -i 's|"/tmp/models"|"/opt/mineru/models"|g' ~/magic-pdf.json
Các bước triển khai chi tiết cho RAG Pipeline
Sau khi cấu hình xong, bạn có thể kiểm tra trước các tệp phức tạp bằng CLI trước khi tích hợp bộ phân tích vào pipeline dữ liệu của mình.
1. Kiểm tra bố cục bằng CLI
Bắt đầu với một tệp phức tạp để xác minh độ chính xác của bounding-box:
# Xử lý tài liệu mẫu bằng chế độ tự động nhận diện trên GPU
magic-pdf -p sample_quarterly_report.pdf -o ./output_parsed -m auto
Kiểm tra thư mục đầu ra tại ./output_parsed/sample_quarterly_report/auto/:
sample_quarterly_report.md: Tệp Markdown hoàn chỉnh chứa các tiêu đề rõ ràng, bảng biểu được trích xuất chuẩn và công thức LaTeX.images/: Các hình minh họa, biểu đồ và sơ đồ nhúng đã được cắt riêng.layout.pdf: Bản sao trực quan phục vụ việc chẩn đoán. Mở tệp này để xem cách YOLO phân chia vùng văn bản, bảng biểu và đường ranh giới các cột.
2. Tích hợp Pipeline bằng Python
Đối với quy trình tự động hóa, hãy gọi trực tiếp MinerU từ Python thay vì khởi tạo tiến trình con qua shell. Mô hình này truyền trực tiếp dữ liệu byte của PDF thành markdown có cấu trúc:
import os
from pathlib import Path
from magic_pdf.pipe.UNIPipe import UNIPipe
from magic_pdf.rw.DiskReaderWriter import DiskReaderWriter

def parse_pdf_to_markdown(pdf_path: str, output_base_dir: str) -> str:
    """
    Chuyển đổi file PDF phức tạp sang Markdown chuẩn và trích xuất hình ảnh nhúng.
    Trả về chuỗi văn bản Markdown đã phân tích.
    """
    file_stem = Path(pdf_path).stem
    doc_output_dir = os.path.join(output_base_dir, file_stem)
    os.makedirs(doc_output_dir, exist_ok=True)

    with open(pdf_path, "rb") as f:
        pdf_bytes = f.read()

    # Thiết lập bộ ghi ổ đĩa cho các tệp kết quả và hình ảnh trích xuất
    asset_writer = DiskReaderWriter(doc_output_dir)

    # UNIPipe điều phối việc nhận diện bố cục, OCR và trích xuất bảng
    pipeline = UNIPipe(pdf_bytes, {"_pdf_type": "", "model_list": []}, asset_writer)
    pipeline.pipe_classify()
    pipeline.pipe_analyze()
    pipeline.pipe_parse()

    # Khởi tạo nội dung markdown liên kết đến các ảnh đã lưu
    markdown_text = pipeline.pipe_mk_markdown(image_dir=os.path.join(doc_output_dir, "images"))

    output_file = os.path.join(doc_output_dir, f"{file_stem}.md")
    with open(output_file, "w", encoding="utf-8") as out:
        out.write(markdown_text)

    return markdown_text

if __name__ == "__main__":
    content = parse_pdf_to_markdown(
        pdf_path="annual_report_2025.pdf",
        output_base_dir="./rag_staging"
    )
    print(f"Đã trích xuất {len(content)} ký tự Markdown chuẩn sạch.")
3. Phân đoạn văn bản dựa trên Header
Phương pháp phân đoạn token cố định thông thường rất dễ cắt đôi các bảng dữ liệu. Khi ranh giới phân đoạn cắt ngang các hàng Markdown hoặc công thức LaTeX, việc tìm kiếm ngữ nghĩa bằng vector sẽ bị sai lệch hoàn toàn. Hãy chia tách theo các dòng tiêu đề trước để bảo toàn tính toàn vẹn của từng phân đoạn ngữ cảnh:
from langchain_text_splitters import MarkdownHeaderTextSplitter, RecursiveCharacterTextSplitter

# Chia tách theo tiêu đề markdown để giữ nguyên ranh giới chủ đề
headers_to_split_on = [
    ("#", "Section"),
    ("##", "Subsection"),
    ("###", "Sub-subsection"),
]

header_splitter = MarkdownHeaderTextSplitter(
    headers_to_split_on=headers_to_split_on,
    strip_headers=False
)
header_chunks = header_splitter.split_text(content)

# Tiếp tục chia nhỏ các phần dài mà không làm đứt gãy hàng trong bảng
chunker = RecursiveCharacterTextSplitter(
    chunk_size=900,
    chunk_overlap=120,
    separators=["\n\n", "\n", " ", ""]
)

rag_documents = chunker.split_documents(header_chunks)
print(f"Đã tạo {len(rag_documents)} đoạn ngữ cảnh hoàn chỉnh sẵn sàng cho việc embedding.")
Nguyên tắc triển khai trên Production
- Cô lập bộ nhớ CUDA cho từng worker: Xử lý một bản scan nhiều trang độ phân giải 300 DPI có thể đẩy mức tiêu thụ VRAM vượt quá 14 GB. Hãy giới hạn mức độ đồng thời của worker pool ở mức một tác vụ trên mỗi GPU để tránh lỗi quá tải bộ nhớ (OOM).
- Sử dụng Markdown làm tầng cache trung gian: Luôn lưu trữ tệp Markdown đã tạo vào S3, MinIO hoặc đĩa cứng cục bộ trước khi lập chỉ mục (index). Việc re-index lại với một mô hình embedding mới chỉ mất vài phút nếu bạn không phải chạy lại toàn bộ mô hình thị giác từ đầu.
- Kiểm tra hiển thị công thức toán học: Xem lại các công thức đã phân tích bằng công cụ MathJax preview trước khi lập chỉ mục hàng loạt. Đảm bảo những ký hiệu phức tạp—như tích phân có cận hay ma trận lồng nhau—khớp hoàn toàn với bố cục nguyên bản.