Bối cảnh & Lý do
Code review thường nhanh chóng trở thành nút thắt cổ chai khi quy mô đội ngũ mở rộng. Khi một nhóm kỹ sư 15 người tạo ra tới 40 pull request (PR) mỗi tuần, hàng đợi review sẽ bị quá tải rất nhanh.
Các senior engineer phải tiêu tốn từ sáu đến tám tiếng mỗi tuần chỉ để rà soát diff tìm các lỗi cú pháp thông thường. Trong khi đó, những lỗ hổng bảo mật thực sự—như không kiểm tra input người dùng, rò rỉ token hay các truy vấn SQL không an toàn—lại âm thầm lọt vào nhánh staging. Những công cụ SAST truyền thống như SonarQube hay Semgrep chỉ bắt được các mẫu cú pháp tiêu chuẩn, nhưng tỷ lệ dương tính giả cao (thường trên 30%) khiến lập trình viên dần phớt lờ cảnh báo của chúng.
Các mô hình ngôn ngữ lớn (LLM) hiểu ngữ nghĩa mã nguồn, logic ngữ cảnh và chủ đích của lập trình viên tốt hơn nhiều so với các quy tắc regex tĩnh. Tuy nhiên, việc gửi mã nguồn độc quyền lên các dịch vụ AI review lưu trữ trên cloud lại kéo theo những rào cản tuân thủ nghiêm ngặt.
Các đội ngũ chịu sự ràng buộc bởi các tiêu chuẩn SOC 2, ISO 27001 hay HIPAA không thể chuyển codebase nội bộ, thuật toán độc quyền hoặc schema API riêng sang các nhà cung cấp bên thứ ba như OpenAI hay Anthropic. Một khi mã nguồn rời khỏi mạng nội bộ (subnet), bạn sẽ mất quyền kiểm soát đối với nhật ký kiểm toán (audit trail) và chính sách lưu trữ dữ liệu.
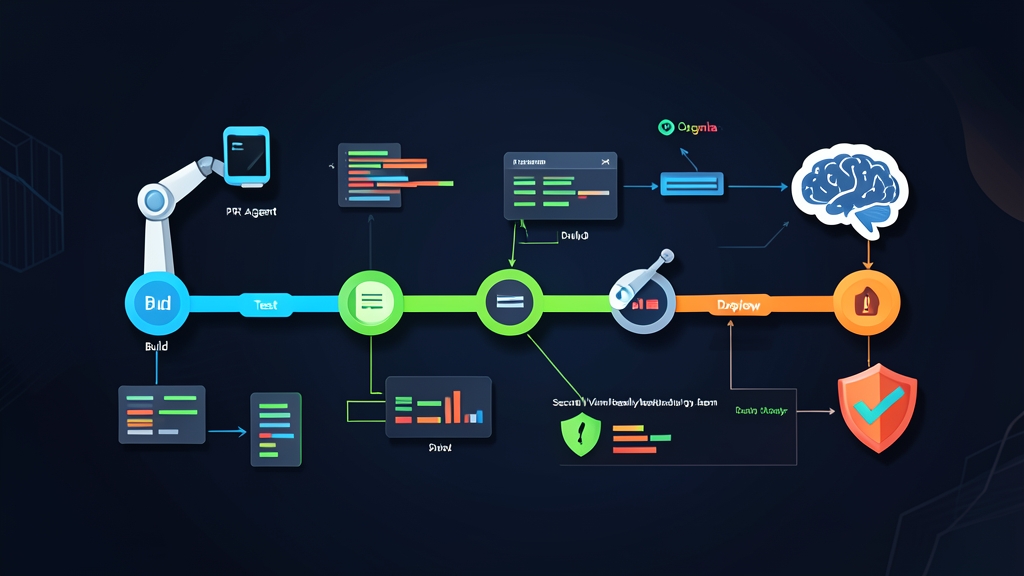
Triển khai quy trình review ngay trong hạ tầng nội bộ sẽ giải quyết triệt để bài toán này. Việc kết hợp PR-Agent (agent review Git mã nguồn mở) với Ollama (công cụ chạy LLM cục bộ gọn nhẹ) cho phép bạn tự vận hành một reviewer tự động ngay trên chính các runner CI/CD tự lưu trữ (self-hosted). Mã nguồn không bao giờ rời khỏi VPC. Chi phí token hàng tháng giảm về 0. Tuyệt vời hơn cả, các kỹ sư nhận được phản hồi bảo mật bám sát ngữ cảnh cho pull request chỉ sau 60 đến 90 giây.
Chúng tôi đã áp dụng mô hình này trên các dịch vụ staging nội bộ. Hệ thống đóng vai trò như chốt chặn đầu tiên trên mọi PR mới mở, phát hiện các trường hợp biên và thiếu sót trong kiểm tra điều kiện trước khi reviewer là con người chạm vào nhánh code.
Cài đặt
Để quá trình suy luận (inference) diễn ra mượt mà mà không kéo dài thời gian chờ của CI, hãy chạy Ollama trên một instance có GPU chuyên dụng. Một card NVIDIA RTX 3060 (12 GB), T4 (16 GB) hoặc A10 có thể thoải mái xử lý từ 30 đến 50 token mỗi giây. Nếu bắt buộc phải dùng server vật lý chỉ có CPU, một model lượng tử hóa (Q4_K_M) vẫn xử lý tốt các diff dưới 200 dòng, dù độ trễ sẽ tăng từ vài giây lên khoảng hai phút.
Bước 1: Cài đặt và khởi chạy Ollama
Cài đặt Ollama trên runner Linux bằng script chính thức:
curl -fsSL https://ollama.com/install.sh | shTheo mặc định, daemon Ollama chỉ lắng nghe trên 127.0.0.1:11434. Nếu PR-Agent chạy trong container Docker qua mạng bridge, Ollama phải lắng nghe trên tất cả interface mạng cục bộ. Hãy cấu hình ghi đè systemd service:
sudo mkdir -p /etc/systemd/system/ollama.service.d
echo -e '[Service]\nEnvironment="OLLAMA_HOST=0.0.0.0:11434"' | sudo tee /etc/systemd/system/ollama.service.d/override.conf
sudo systemctl daemon-reload
sudo systemctl restart ollama
Bước 2: Tải model chuyên biệt cho lập trình
Các mô hình nền tảng đa năng thường gặp khó khăn với các đánh giá code đòi hỏi sự tinh tế. Thay vào đó, hãy sử dụng model instruction-tuned được thiết kế riêng cho công việc kỹ thuật phần mềm. Qwen2.5-Coder (7B) mang lại khả năng suy luận code hàng đầu trong khi chỉ yêu cầu chưa đầy 5 GB VRAM:
# Tải model 7B tham số (~4.7 GB dung lượng tải về)
ollama pull qwen2.5-coder:7b

# Chạy kiểm tra nhanh qua CLI
ollama run qwen2.5-coder:7b "Xác định các lỗ hổng tiềm ẩn trong: query = f\"SELECT * FROM users WHERE id = {user_input}\""
Bước 3: Lấy PR-Agent
PR-Agent được đóng gói dưới dạng image Docker độc lập chứa đầy đủ tích hợp với các Git provider và pipeline prompt. Hãy pull image về máy host runner:
docker pull codiumai/pr-agent:latestCấu hình
Ollama cung cấp API tương thích với OpenAI tại http://<host>:11434/v1. PR-Agent có thể giao tiếp trực tiếp với endpoint cục bộ này bằng cách ghi đè URL gốc (base URL) và thiết lập model.
Bước 1: Tạo cấu hình cho PR-Agent
Thêm một file cấu hình có tên .pr_agent.toml vào thư mục gốc của repository hoặc thư mục triển khai CI:
[config]
model = "qwen2.5-coder:7b"
fallback_models = ["qwen2.5-coder:7b"]
git_provider = "github"

[openai]
api_base = "http://127.0.0.1:11434/v1"
key = "none"

[pr_reviewer]
require_score_review = false
require_tests_review = true
require_security_review = true
num_code_suggestions = 4
inline_code_comments = true

[pr_description]
publish_labels = false
add_original_user_description = true
Bước 2: Tự động hóa với GitHub Actions trên Self-Hosted Runner
Tạo file workflow GitHub tại .github/workflows/pr-review.yml. Điều hướng job đến nhóm runner self-hosted nơi Ollama đang chạy:
name: Tự động review code cục bộ

on:
  pull_request:
    types: [opened, synchronize, reopened]

jobs:
  local-pr-agent:
    runs-on: self-hosted
    permissions:
      contents: read
      pull-requests: write
      issues: write
    steps:
      - name: Checkout mã nguồn
        uses: actions/checkout@v4

      - name: Chạy PR-Agent Reviewer qua Docker
        env:
          OPENAI_KEY: "none"
          OPENAI_API_BASE: "http://127.0.0.1:11434/v1"
          CONFIG_MODEL: "qwen2.5-coder:7b"
          GITHUB_TOKEN: ${{ secrets.GITHUB_TOKEN }}
          github_action_config.auto_review: "true"
          github_action_config.auto_describe: "false"
          github_action_config.auto_improve: "false"
        run: |
          docker run --rm \
            --net="host" \
            -e OPENAI_KEY="$OPENAI_KEY" \
            -e OPENAI.API_BASE="$OPENAI_API_BASE" \
            -e CONFIG.MODEL="$CONFIG_MODEL" \
            -e GITHUB.USER_TOKEN="$GITHUB_TOKEN" \
            -e GITHUB.DEPLOYMENT_TYPE="app" \
            -v $(pwd)/.pr_agent.toml:/app/.pr_agent.toml \
            codiumai/pr-agent:latest \
            --pr_url="${{ github.event.pull_request.html_url }}" \
            review
Việc dùng --net="host" cho phép container giao tiếp trực tiếp với Ollama tại 127.0.0.1:11434 mà không cần đi qua NAT của mạng Docker bridge. Do Ollama không yêu cầu xác thực, giá trị giữ chỗ "none" đã đủ để thỏa mãn điều kiện phía client của PR-Agent.
Kiểm thử & Giám sát
Sau khi push file workflow lên, hãy kiểm tra pipeline tự động hóa bằng một pull request cố tình chứa lỗi.
Bước 1: Kiểm thử với một Pull Request chứa lỗ hổng
Tạo một nhánh mới từ main và đưa vào một truy vấn không an toàn trong file test, chẳng hạn như auth.py:
import sqlite3

def get_user_records(user_id):
    conn = sqlite3.connect("users.db")
    cursor = conn.cursor()
    # Lỗi nghiêm trọng: định dạng chuỗi trực tiếp tạo ra lỗ hổng SQL injection
    query = f"SELECT * FROM accounts WHERE id = '{user_id}'"
    cursor.execute(query)
    return cursor.fetchall()
Push nhánh lên và mở một PR. Trong vòng hai phút, runner sẽ phân tích git diff, truy vấn Ollama và gửi một comment có cấu trúc trực tiếp vào cuộc thảo luận trên PR:
- Cảnh báo lỗ hổng: Đánh dấu
get_user_recordsvì chèn trực tiếp tham số SQL mà không escape. - Checklist bảo mật: Đánh dấu các input người dùng chưa được làm sạch là kiểm tra thất bại.
- Bản vá cụ thể: Đề xuất dùng parameterized binding:
cursor.execute("SELECT * FROM accounts WHERE id = ?", (user_id,)).
Bước 2: Giám sát hiệu năng và mức tiêu thụ tài nguyên
Theo dõi tải suy luận giúp ngăn runner CI bị cạn kiệt bộ nhớ. Trong khi quá trình review đang chạy, hãy kiểm tra mức phân bổ bộ nhớ GPU và nhiệt độ theo thời gian thực:
watch -n 1 nvidia-smiĐể kiểm tra thông lượng token đang xử lý hoặc gỡ lỗi kết nối HTTP, bạn có thể xem trực tiếp log của service Ollama:
journalctl -u ollama -f --no-tailBước 3: Xử lý giới hạn token với các Diff lớn
Mặc định, Ollama khởi tạo model với context window là 2.048 token (num_ctx). Các diff lớn chứa file schema tự động sinh hoặc file lock dependency sẽ bị cắt cụt (truncate) nếu vượt quá giới hạn này. Qwen2.5-Coder hỗ trợ context lớn hơn nhiều một cách tự nhiên. Bạn có thể mở rộng cửa sổ ngữ cảnh hoạt động của Ollama lên 8.192 token bằng cách định nghĩa một Modelfile tùy chỉnh:
FROM qwen2.5-coder:7b
PARAMETER num_ctx 8192
PARAMETER temperature 0.1
Hãy lưu ý rằng việc mở rộng num_ctx từ 2.048 lên 8.192 sẽ chiếm thêm khoảng 1.5 GB VRAM cho bộ nhớ đệm KV cache. Đăng ký biến thể tùy chỉnh này:
ollama create qwen2.5-coder-8k -f ./ModelfileCập nhật model = "qwen2.5-coder-8k" trong file .pr_agent.toml của bạn. Việc hạ thấp temperature xuống 0.1 giúp reviewer đưa ra kết quả nhất quán, hạn chế hiện tượng ảo giác (hallucination) và tập trung nhận xét hoàn toàn vào các lỗi chức năng và bảo mật thực sự.
Pipeline tự lưu trữ này mang lại khả năng rà soát bảo mật tự động trên từng commit. Đội ngũ kỹ sư của bạn sẽ phát hiện lỗi hồi quy sớm hơn, trong khi mã nguồn độc quyền vẫn được bảo vệ tuyệt đối trên chính các server của bạn.