背景と目的
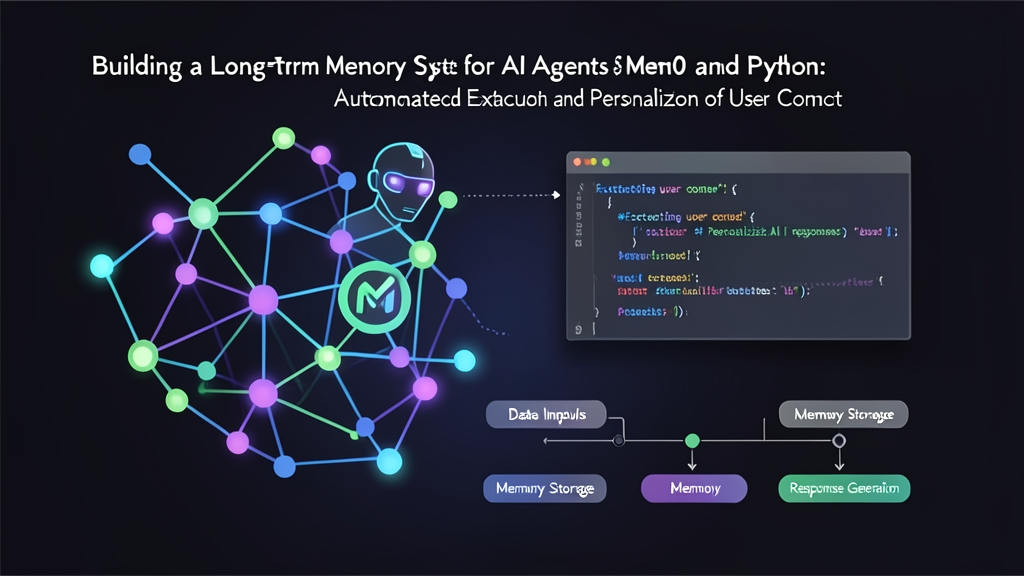
対話型LLMアプリケーションの多くは、「短期的な記憶喪失」という課題を抱えています。従来のチャットボットは、直近のメッセージのスライディングウィンドウをモデルに再送することで状態を保持しています。しかし、ユーザーセッションが終了したり、会話履歴がトークン上限を超えたりすると、あらゆるコンテキストが失われてしまいます。その結果、モデルは好みのフレームワーク、アーキテクチャのルール、プロジェクト名などを忘れてしまいます。
標準的なドキュメントベースのRAG(検索拡張生成)では、この問題を解決できません。RAGはチームのWikiやAPIマニュアルのような静的な外部ナレッジベースを対象としており、状態の変化やユーザーの行動パターンの追跡は行いません。たとえば、開発者が月曜日に「FlaskよりもFastAPIを好む」と伝え、木曜日に「クリーンなAPIテンプレート」を求めたとしても、標準的なRAGではこれら2つのやり取りを結びつけることができません。
チャットログ全体を毎回プロンプトに再注入するのも同様に非効率的です。プロンプトへの詰め込み(Prompt Stuffing)は、コンテキストの上限を急速に消費します。リクエストごとに12,000トークンもの生の履歴を渡すと、レイテンシが400ms〜700ms増加し、APIコストも跳ね上がります。Mem0は、永続的な事実を動的に抽出し、矛盾する記述を解決して、ユーザーごとにコンパクトなプロファイルへと更新することで、この課題をスマートに解決します。エージェントは回答生成時、関連する150〜300トークン程度のコンテキストのみを取得すれば済みます。
インストール
LangChain、Pydantic、LlamaIndexなどのパッケージとの依存関係の衝突を防ぐため、まずは独立したPython仮想環境を用意します。
# 独立した仮想環境を作成してアクティベート
python3 -m venv .venv
source .venv/bin/activate

# QdrantおよびOpenAIドライバとともにMem0ライブラリをインストール
pip install mem0ai qdrant-client openai
Mem0は責務を2つのレイヤーに分割しています。事実の抽出はLLMとEmbeddingモデルが担当し、セマンティック検索のためのインデックス作成はベクトルデータベースが担います。ここでは、抽出にOpenAIのgpt-4o-mini、ベクトル化にtext-embedding-3-small、そしてローカルディスク上で動作する組み込み型Qdrantインスタンスを使用します。
スクリプトを実行する前に、シェルでAPIキーを設定してください。
export OPENAI_API_KEY="sk-proj-yourActualKeyHere"設定
本番環境では、ライブラリの暗黙的なデフォルト設定に頼るのではなく、ベクトルインデックスや抽出パラメータを明示的に指定することが求められます。以下は、個別のDockerデーモンを実行することなく、ローカルディレクトリにベクトル埋め込みを直接永続化する無駄のないローカルセットアップです。
1. カスタムメモリ設定の初期化
import os
from mem0 import Memory

config = {
    "vector_store": {
        "provider": "qdrant",
        "config": {
            "path": "./mem0_storage",
            "collection_name": "agent_memory"
        }
    },
    "llm": {
        "provider": "openai",
        "config": {
            "model": "gpt-4o-mini",
            "temperature": 0.0
        }
    },
    "embedder": {
        "provider": "openai",
        "config": {
            "model": "text-embedding-3-small"
        }
    }
}

# メモリマネージャーを初期化
memory = Memory.from_config(config)
2. 会話の取り込みと事実の抽出
完了した会話ターンをMem0に直接渡します。Mem0のパイプラインが対話をスキャンし、長期的な好みを分離して、永続的なuser_idに関連付けてベクトルストアに書き込みます。
user_id = "usr_dev_4821"
conversation_turn = [
    {
        "role": "user",
        "content": "Pythonで在庫管理サービスを作成しています。生のSQLは避け、PostgreSQLとSQLAlchemy 2.0のみを使用します。"
    },
    {
        "role": "assistant",
        "content": "承知いたしました。すべてのデータベースコードで最新のSQLAlchemy 2.0 ORMパターンが使用されるように徹底します。"
    }
]

# 会話ターンを取り込み、事実を抽出
result = memory.add(conversation_turn, user_id=user_id)
print(result)
Mem0は、会話から抽出された永続的な情報のみを表す構造化オブジェクトを返します。
{
  "results": [
    {
      "id": "m0-9b3f4e12",
      "memory": "生のSQLを避け、SQLAlchemy 2.0とPostgreSQLのみを使用",
      "event": "ADD"
    },
    {
      "id": "m0-5a8c2d91",
      "memory": "Pythonで在庫管理サービスを開発中",
      "event": "ADD"
    }
  ]
}
この変換処理に注目してください。Mem0は挨拶や相槌のような会話の埋め草(フィラー)は保存しません。2つの簡潔な事実ステートメントのみを分離し、個別にインデックス化しています。
検証とモニタリング
事実を保存しても、推論時にエージェントがそれらをプロンプトスコープに引き戻せなければ意味がありません。また、時間の経過とともに古くなった事実を更新または削除するための明確なワークフローも必要です。
1. 推論時のコンテキスト取得
新しいユーザープロンプトを推論モデルにルーティングする前に、Mem0にクエリを実行します。ローカルストレージ環境であれば、保存されたメモリアイテムに対するセマンティック検索は10ms〜25msで完了します。
# 数日後にユーザーが簡潔なプロンプトを送信
user_query = "アクティブなすべての顧客レコードをクエリするエンドポイントを作成してください。"

# この開発者に関連する事実を最大3件取得
search_hits = memory.search(query=user_query, user_id=user_id, limit=3)

# 抽出された事実をプロンプトのコンテキストに整形
facts = [hit["memory"] for hit in search_hits.get("results", [])]
memory_context = "\n".join(f"- {fact}" for fact in facts)

system_prompt = f"""あなたはプリンシパルバックエンドエンジニアです。

ユーザーの制約事項:
{memory_context}

ユーザーの制約事項に従い、プロダクションレディで慣例に沿ったコードを記述してください。"""

print(system_prompt)
生成されたプロンプトに注入されるコンテキストは、わずか48トークンに抑えられます。
あなたはプリンシパルバックエンドエンジニアです。

ユーザーの制約事項:
- 生のSQLを避け、SQLAlchemy 2.0とPostgreSQLのみを使用
- Pythonで在庫管理サービスを開発中

ユーザーの制約事項に従い、プロダクションレディで慣例に沿ったコードを記述してください。
2. メモリのライフサイクル管理
ユーザーの好みは変化します。フレームワークのアップデートや技術スタックの移行が発生し、コンプライアンス要件によって顧客データの削除が求められることもあります。Mem0は、あらゆる状態変化を明示的に処理するためのCRUDヘルパーを提供しています。
# 監査やデバッグのためにすべてのアクティブな事実を確認
user_profile = memory.get_all(user_id=user_id)
for item in user_profile.get("results", []):
    print(f"[{item['id']}] {item['memory']}")

# ユーザーがライブラリを移行した際にレコードを更新
memory.update(
    memory_id="m0-9b3f4e12",
    data="SQLAlchemyからAsyncEngineを使用するSQLModelへ移行"
)

# GDPR第17条(削除権)のリクエストに応じてオンデマンドでレコードを削除
memory.delete(memory_id="m0-5a8c2d91")

# アカウント解約時にすべてのユーザーデータを完全に削除
# memory.delete_all(user_id=user_id)
3. 本番運用のチェックリスト
- サーバーサイドで厳格なテナント分離を徹底する:
user_idは必ず検証済みのJWTトークンやセッションCookieから導出してください。クライアント側のペイロードから任意のユーザー識別子を受け取ると、アカウント間でのメモリ漏洩リスクが生じます。 - 抽出時の温度(temperature)をゼロに固定する: 抽出モデルのtemperatureは
0.0に設定してください。求められるのは決定論的で正確な事実の抽出であり、ハルシネーションを伴う推論ではありません。 - スケールアウト前に組み込みストレージから移行する: 組み込みQdrantのディスクストレージは、ローカル実行や単一コンテナ環境には適しています。Kubernetesポッドに水平スケールさせる場合は、書き込みの競合を防ぐため、スタンドアロンのQdrantやMilvusクラスタを参照するように構成を変更してください。
アダプティブなメモリを生のチャットログから切り離すことで、コンテキストウィンドウをスリムに保ち、下流の推論コストを60%以上削減できるとともに、アシスタントにセッションをまたぐ真の継続性を持たせることができます。