2 Giờ Sáng và Database Của Bạn Vừa Bị Xóa Sạch
Điện thoại bạn rung liên tục. Cảnh báo on-call báo production đang “hoạt động bất thường.” Bạn SSH vào và tìm ra nguyên nhân: một junior dev vừa chạy migration script có câu lệnh DELETE FROM orders WHERE status = 'pending' — mệnh đề WHERE bị lỗi âm thầm do gõ nhầm, và nó đã xóa sạch toàn bộ bảng orders. 47.000 bản ghi. Mất sạch.
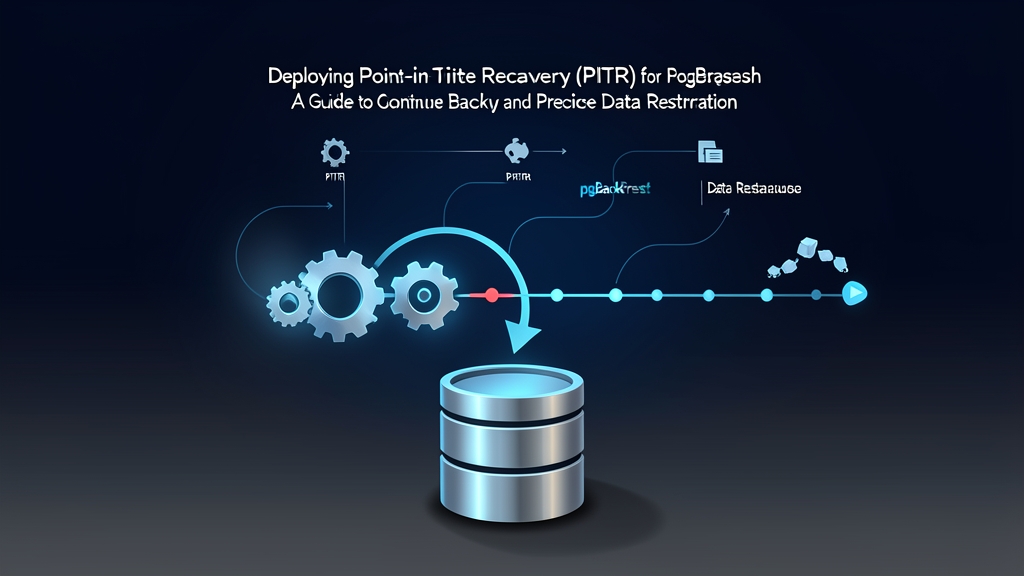
Đây chính xác là lúc backup bằng pg_dump không giúp được gì. Lần dump cuối cùng là 6 tiếng trước. Tức là 6 tiếng dữ liệu đơn hàng, thanh toán và thông tin khách hàng mà bạn không thể khôi phục từ một snapshot truyền thống. Nhưng nếu đã cài đặt Point-in-Time Recovery (PITR) qua pgBackRest, bạn sẽ hoạt động trở lại trong 20 phút — khôi phục về đúng một phút trước khi migration tệ đó chạy.
Đây là cách xây dựng hệ thống đó trước khi sự cố xảy ra.
Tại Sao pg_dump Không Đủ Cho Môi Trường Production
pg_dump truyền thống tạo ra một snapshot — một bản sao đầy đủ của database tại một thời điểm duy nhất. Nó hoạt động tốt cho database nhỏ hoặc môi trường dev. Trong production, nó có hai vấn đề nghiêm trọng:
- RPO cao (Recovery Point Objective): Bạn mất toàn bộ dữ liệu giữa lần dump cuối và thời điểm sự cố. Dump mỗi 6 tiếng, mất tối đa 6 tiếng dữ liệu.
- Không thể quay về quá khứ: Bạn chỉ có thể khôi phục về đúng thời điểm dump chạy. Không có chuyện “khôi phục về 5 phút trước câu query tệ hại đó.”
PITR giải quyết cả hai bằng cách lưu trữ liên tục các file WAL (Write-Ahead Log). PostgreSQL ghi mọi thay đổi vào WAL trước khi áp dụng vào data file. Giữ lại các file WAL đó và bạn có thể phát lại các transaction đến bất kỳ thời điểm cụ thể nào.
pgBackRest giúp điều này sẵn sàng cho production. Backup full, differential và incremental đều được tích hợp sẵn. WAL archiving chạy tự động ở nền. Khôi phục chạy song song — một database 300GB mất 25 phút khi chạy đơn luồng sẽ hoàn thành trong khoảng 8 phút với 4 worker. Mỗi file backup đều được gắn checksum, và storage có thể là ổ đĩa cục bộ, S3 hoặc Azure Blob Storage. Đây là tiêu chuẩn de-facto cho các triển khai PostgreSQL nghiêm túc.
Cài Đặt pgBackRest: Từng Bước Một
Các bước này dành cho Ubuntu 22.04 với PostgreSQL 15. Điều chỉnh đường dẫn phù hợp với phiên bản của bạn.
Cài đặt pgBackRest
sudo apt-get update
sudo apt-get install pgbackrest -y
pgbackrest version
Tạo File Cấu Hình
sudo mkdir -p /etc/pgbackrest
sudo nano /etc/pgbackrest/pgbackrest.conf
[global]
repo1-path=/var/lib/pgbackrest
repo1-retention-full=2
log-level-console=info
log-level-file=detail
[main]
pg1-path=/var/lib/postgresql/15/mainBật WAL Archiving trong PostgreSQL
Chỉnh sửa postgresql.conf:
sudo nano /etc/postgresql/15/main/postgresql.confThêm hoặc cập nhật các cài đặt sau:
wal_level = replica
archive_mode = on
archive_command = 'pgbackrest --stanza=main archive-push %p'
archive_timeout = 60
max_wal_senders = 3
Dòng archive_timeout = 60 rất quan trọng. Nếu không có nó, WAL segment chỉ được archive khi đầy đến 16MB — trên database ít traffic, khoảng cách giữa các lần archive có thể lên đến vài tiếng. Đặt 60 giây nghĩa là bạn archive ít nhất mỗi phút, cho bạn RPO tối đa 60 giây trong trường hợp xấu nhất.
sudo systemctl restart postgresqlKhởi tạo Stanza và Chạy Backup Đầu Tiên
sudo -u postgres pgbackrest --stanza=main stanza-create
sudo -u postgres pgbackrest --stanza=main --type=full backup
Sau khi backup full hoàn thành, pgBackRest sẽ tự động tiếp quản WAL archiving liên tục. RPO của bạn sẽ giảm xuống gần như bằng không từ đó trở đi. Lên lịch backup tự động trong cron:
# Backup full hàng ngày lúc 1 giờ sáng
0 1 * * * postgres pgbackrest --stanza=main --type=full backup

# Backup differential mỗi 6 tiếng
0 */6 * * * postgres pgbackrest --stanza=main --type=diff backup
Thực Hành Khôi Phục: Restore về Một Thời Điểm Cụ Thể
Đây là phần quan trọng nhất lúc 2 giờ sáng. Trước tiên, xác định thời điểm gần đúng khi sự cố xảy ra. Kiểm tra application log, PostgreSQL log, hoặc hỏi dev xem migration chạy lúc mấy giờ. Giả sử câu lệnh xóa tệ hại xảy ra lúc 2024-11-15 02:03:00 UTC.
Dừng PostgreSQL và Xóa Thư Mục Data
sudo systemctl stop postgresql
sudo -u postgres find /var/lib/postgresql/15/main -mindepth 1 -delete
Khôi Phục về Một Phút Trước Sự Cố
sudo -u postgres pgbackrest --stanza=main restore \
  --target="2024-11-15 02:02:00+00" \
  --target-action=promote \
  --type=time
Mốc thời gian là 02:02:00 — một phút trước câu query tệ hại. Đó chính là điểm mấu chốt của PITR. Bên dưới, pgBackRest tìm bản backup full gần nhất trước mốc thời gian mục tiêu, khôi phục các data file đó, rồi phát lại từng WAL segment một cho đến khi đạt mốc thời gian và dừng lại.
Khởi Động PostgreSQL và Kiểm Tra
sudo systemctl start postgresql
sudo -u postgres psql -c "SELECT count(*) FROM orders;"
Nếu bạn thấy 47.000 bản ghi, bạn vừa cứu được công ty. Tổng thời gian downtime: dưới 20 phút.
Giám Sát — Vì Archive Bị Hỏng Còn Tệ Hơn Không Có Archive
Đừng bao giờ giả định archive đang hoạt động tốt — hãy kiểm tra chủ động và thường xuyên:
sudo -u postgres pgbackrest --stanza=main infoTìm status: ok và xác nhận WAL archive min/max đang tăng dần theo thời gian. Nếu bạn thấy status: error, PITR của bạn đã bị hỏng âm thầm.
View thống kê tích hợp của PostgreSQL cũng cho thấy điều tương tự:
sudo -u postgres psql -c "SELECT last_archived_wal, last_failed_wal, failed_count FROM pg_stat_archiver;"Nếu failed_count đang tăng, archive command của bạn đang bị lỗi và bạn cần sửa ngay lập tức — không phải sáng mai, mà ngay bây giờ.
Mỗi tháng một lần, dựng staging server và chạy restore đầy đủ. Kiểm tra số lượng bản ghi, xem xét nhanh các bảng quan trọng nhất. Tôi đã từng bị thiệt hại khi tin tưởng vào một backup có hai tuần lỗ hổng archive — một thay đổi quyền truy cập đã làm hỏng archive_command âm thầm và không có gì cảnh báo về điều đó.
Một Số Điều Cần Lưu Ý
Một số điều tôi học được qua kinh nghiệm đau thương:
- Dung lượng đĩa: File WAL tích lũy rất nhanh trên database bận rộn. Đặt
repo1-retention-archive-type=incrđể tự động dọn sạch archive cũ theo retention policy của bạn. - Quyền truy cập: Chạy tất cả lệnh pgBackRest với user
postgres. Trộn lẫn quyền sở hữu của root và postgres gây ra các lỗi khó hiểu. - Kiểm tra trước khi cần dùng: Đừng bao giờ chạy restore lần đầu tiên trong một sự cố thực sự. Hãy thực hành quy trình restore trên staging ít nhất một lần để lúc 2 giờ sáng tay bạn tự làm được.
- Xác thực dữ liệu import trước khi vào database: Việc khôi phục tốt nhất là việc bạn không bao giờ cần dùng đến. Trước bất kỳ lần import dữ liệu lớn nào, hãy xác thực cấu trúc trước — nếu là CSV, hãy chạy qua toolcraft.app/vi/tools/data/csv-to-json để kiểm tra định dạng trước khi đưa vào Postgres (chỉ chạy trên trình duyệt, dữ liệu không rời máy bạn). Phát hiện import bị lỗi ở bước đó còn hơn phải restore PITR bất cứ lúc nào.
PITR Phù Hợp Ở Đâu Trong Chiến Lược Backup Hoàn Chỉnh
Point-in-Time Recovery xử lý tốt tình huống “ai đó xóa dữ liệu production.” Những gì nó không bao gồm:
- Lưu trữ offsite: Cấu hình
repo1-type=s3để đẩy backup lên S3. Ổ đĩa hỏng là chuyện xảy ra và chúng không quan tâm đến lịch backup của bạn. - Streaming replication: Bảo vệ khỏi lỗi phần cứng, nhưng không bảo vệ khỏi lỗi logic — một câu DELETE tệ sẽ được replicate ngay lập tức sang standby server.
- Xuất pg_dump định kỳ: Giữ logical backup hàng tuần để linh hoạt khi cần. Schema migration đôi khi yêu cầu một bản dump sạch, không phải restore cấp file.
Kết hợp cả ba — pgBackRest PITR, streaming replication, xuất pg_dump hàng tuần — và bạn đã bao phủ gần như mọi kiểu sự cố mà production có thể ném vào bạn. Mỗi lớp bắt được những gì các lớp khác bỏ sót.
Hãy vận hành nó trước khi bạn cần dùng. Thực hành restore đầy đủ trên staging ít nhất một lần, để khi thực sự là 2 giờ sáng và bạn đang nửa tỉnh nửa mê, các lệnh đó là phản xạ cơ bắp — không phải thứ bạn phải Google dưới áp lực.