Vì sao Streaming Replication tích hợp sẵn là chưa đủ?
Bất kỳ DBA nào cũng ngán ngẩm những hồi chuông báo động lúc 3 giờ sáng. Máy chủ primary đột ngột rớt mạng, các tiến trình ghi bị nghẽn và toàn bộ giao dịch thanh toán trên hệ thống tê liệt. Cơ chế physical streaming replication của PostgreSQL truyền các đoạn WAL rất đáng tin cậy. Tuy nhiên, bản thân nó không thể tự quản lý đồng thuận cluster, phát hiện phân vùng mạng (network partition) hay tự động định tuyến lại truy vấn từ client.
Khi sự cố xảy ra, bạn phải đối mặt với quy trình xử lý thủ công đầy căng thẳng: chạy lệnh pg_ctl promote trên standby, cập nhật chuỗi kết nối (connection string) của ứng dụng và cầu nguyện node primary cũ không bật lại. Nếu node primary bị cô lập trước đó sống lại và tiếp tục nhận dữ liệu ghi, hệ thống sẽ rơi vào tình trạng split-brain. Khi đó, timeline phân kỳ và transaction log bị xung đột—một cơn ác mộng đòi hỏi hàng giờ phẫu thuật WAL thủ công để cứu vãn.
Một hệ thống High Availability sẵn sàng cho môi trường production đòi hỏi ba yếu tố then chốt:
- Đồng thuận tin cậy (Reliable consensus): Một cơ chế phân tán đạt quorum nhằm cấp lease độc quyền, có thời hạn cho duy nhất một node primary tại một thời điểm.
- Tự động hóa vòng đời (Automated lifecycle orchestration): Một daemon an toàn có khả năng giáng cấp các primary bị cô lập, chạy
pg_basebackupđể clone lại các node hỏng, và thăng cấp ứng viên có độ trễ replication thấp nhất. - Định tuyến truy vấn linh hoạt (Dynamic query routing): Một reverse proxy thông minh theo dõi vai trò của database qua các health check, loại bỏ hoàn toàn việc phải cập nhật chuỗi kết nối hay khởi động lại dịch vụ.
Kiến trúc: Các thành phần phối hợp như thế nào?
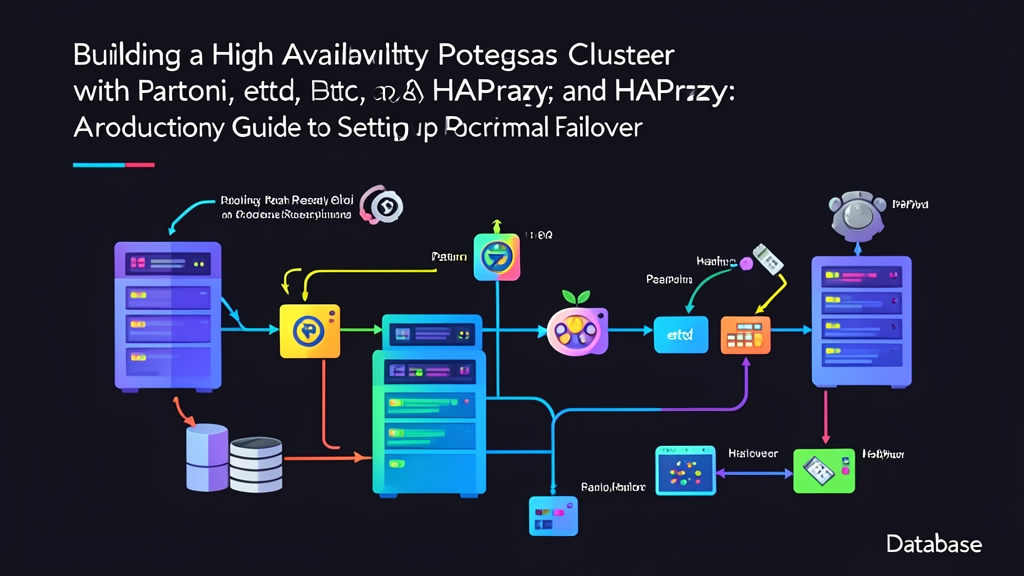
Để loại bỏ các điểm nghẽn đơn lẻ (single points of failure), mô hình chuẩn của chúng ta tách biệt các tầng đồng thuận, quản lý tiến trình và định tuyến kết nối thành ba lớp riêng biệt:
1. Kho lưu trữ đồng thuận phân tán (etcd)
Nằm ở trung tâm là etcd, kho lưu trữ key-value phân tán hoạt động dựa trên thuật toán Raft. Cluster etcd gồm 3 node cho phép chịu lỗi 1 node mà vẫn duy trì được đa số quorum. Patroni duy trì một distributed leader lock bên trong etcd với thời gian sống (TTL) là 30 giây. Chỉ node nào nắm giữ key hợp lệ này mới được phép tiếp nhận lưu lượng đọc-ghi.
2. Bộ điều phối cluster (Patroni)
Patroni là một daemon quản lý viết bằng Python trực tiếp điều khiển PostgreSQL. Thay vì giao việc giám sát tiến trình cho systemd, Patroni tự mình quản lý toàn bộ vòng đời của cơ sở dữ liệu. Cứ mỗi 10 giây, node Patroni leader sẽ gia hạn lease trên etcd. Nếu máy chủ bị treo hoặc ngắt kết nối mạng, lease sẽ hết hạn. Các node standby còn lại sẽ phát hiện lock đang trống, mở cuộc bầu cử và tự động thăng cấp replica có vị trí WAL LSN mới nhất.
3. Proxy định tuyến động (HAProxy)
Ứng dụng không bao giờ nên bận tâm đến việc cấu trúc database thay đổi ra sao. HAProxy giải quyết bài toán này bằng cách liên tục kiểm tra REST API của Patroni trên port 8008. Node primary đang hoạt động sẽ phản hồi HTTP 200 OK cho endpoint /primary, trong khi các standby trả về HTTP 503 Service Unavailable. Đối với các bản sao chỉ đọc (read replica), Patroni trả về HTTP 200 trên endpoint /replica. HAProxy kiểm tra các endpoint này mỗi 3 giây, điều hướng các truy vấn ghi tới port 5000 và cân bằng tải truy vấn đọc qua port 5001.
Xây dựng Cluster: Các bước triển khai chi tiết
Chúng ta triển khai kiến trúc này trên bốn instance trong subnet nội bộ:
- pg-node1: 10.0.0.11 (etcd + Patroni + PostgreSQL 16)
- pg-node2: 10.0.0.12 (etcd + Patroni + PostgreSQL 16)
- pg-node3: 10.0.0.13 (etcd + Patroni + PostgreSQL 16)
- haproxy-lb: 10.0.0.10 (Bộ cân bằng tải HAProxy)
Bước 1: Triển khai Quorum etcd
Cài đặt etcd trên cả ba máy chủ database:
sudo apt-get update
sudo apt-get install -y etcd-server etcd-client
Cấu hình etcd trên pg-node1 (10.0.0.11) bằng cách chỉnh sửa tệp /etc/default/etcd:
ETCD_NAME="node1"
ETCD_DATA_DIR="/var/lib/etcd/cluster.etcd"
ETCD_LISTEN_PEER_URLS="http://10.0.0.11:2380"
ETCD_LISTEN_CLIENT_URLS="http://10.0.0.11:2379,http://127.0.0.1:2379"
ETCD_INITIAL_ADVERTISE_PEER_URLS="http://10.0.0.11:2380"
ETCD_ADVERTISE_CLIENT_URLS="http://10.0.0.11:2379"
ETCD_INITIAL_CLUSTER="node1=http://10.0.0.11:2380,node2=http://10.0.0.12:2380,node3=http://10.0.0.13:2380"
ETCD_INITIAL_CLUSTER_TOKEN="pg-ha-token"
ETCD_INITIAL_CLUSTER_STATE="new"
Áp dụng cấu hình tương ứng trên node2 và node3, cập nhật địa chỉ IP và tên định danh host cho phù hợp. Khởi động và kiểm tra cluster:
sudo systemctl restart etcd
sudo systemctl enable etcd

# Kiểm tra danh sách thành viên và tình trạng cluster
ETCDCTL_API=3 etcdctl --endpoints=http://127.0.0.1:2379 endpoint health
ETCDCTL_API=3 etcdctl --endpoints=http://127.0.0.1:2379 member list
Bước 2: Cài đặt và cấu hình Patroni
Cài đặt PostgreSQL 16, Patroni cùng thư viện etcd3 cho Python:
sudo apt-get install -y postgresql-16 patroni python3-psycopg2 python3-etcd3Vô hiệu hóa việc quản lý tự động của systemd đối với PostgreSQL để Patroni toàn quyền kiểm soát quá trình khởi động và tắt dịch vụ:
sudo systemctl stop postgresql
sudo systemctl disable postgresql
Tạo tệp cấu hình cho Patroni tại /etc/patroni/patroni.yml trên pg-node1:
scope: postgres-prod
namespace: /service
name: pg-node1

restapi:
  listen: 10.0.0.11:8008
  connect_address: 10.0.0.11:8008

etcd3:
  hosts:
    - 10.0.0.11:2379
    - 10.0.0.12:2379
    - 10.0.0.13:2379

bootstrap:
  dcs:
    ttl: 30
    loop_wait: 10
    retry_timeout: 10
    maximum_lag_on_failover: 1048576  # Độ trễ WAL tối đa 1MB để đủ điều kiện thăng cấp
    postgresql:
      use_pg_rewind: true
      parameters:
        wal_level: replica
        max_wal_senders: 10
        max_replication_slots: 10
        hot_standby: "on"

  initdb:
    - encoding: UTF8
    - data-checksums

  pg_hba:
    - host replication replicator 10.0.0.0/24 md5
    - host all all 0.0.0.0/0 md5

postgresql:
  listen: 10.0.0.11:5432
  connect_address: 10.0.0.11:5432
  data_dir: /var/lib/postgresql/16/patroni
  bin_dir: /usr/lib/postgresql/16/bin
  pgpass: /var/lib/postgresql/.pgpass
  authentication:
    replication:
      username: replicator
      password: RepSecretPassword123
    superuser:
      username: postgres
      password: PostgresSuperSecret123

tags:
  nofailover: false
  noloadbalance: false
  clonefrom: false
Sao chép cấu hình này sang pg-node2 và pg-node3. Nhớ điều chỉnh lại IP nội bộ tương ứng cho name, restapi.listen và postgresql.listen trên từng node. Khởi động Patroni:
sudo systemctl start patroni
sudo systemctl enable patroni
Patroni sẽ tự động khởi tạo (bootstrap) cơ sở dữ liệu trên node đầu tiên giành được leader key. Các node standby sẽ clone thư mục dữ liệu của leader thông qua pg_basebackup. Chạy lệnh kiểm tra sau trên bất kỳ node nào:
sudo patronictl -c /etc/patroni/patroni.yml listKết quả hiển thị một cluster 3 node khỏe mạnh với một Leader được bầu và hai Replica đang streaming:
+ Cluster: postgres-prod (73491823901) ---+----+-----------+
| Member   | Host       | Role    | State   | TL | Lag in MB |
+----------+------------+---------+---------+----+-----------+
| pg-node1 | 10.0.0.11  | Leader  | running |  1 |           |
| pg-node2 | 10.0.0.12  | Replica | running |  1 |         0 |
| pg-node3 | 10.0.0.13  | Replica | running |  1 |         0 |
+----------+------------+---------+---------+----+-----------+
Bước 3: Cấu hình HAProxy để định tuyến lưu lượng minh bạch
Cài đặt HAProxy trên node load balancer chuyên dụng (10.0.0.10):
sudo apt-get install -y haproxyThêm backend cho tác vụ ghi và đọc vào tệp /etc/haproxy/haproxy.cfg:
global
    log /dev/log local0
    maxconn 4096

defaults
    log global
    mode tcp
    option tcplog
    timeout connect 3000ms
    timeout client 50000ms
    timeout server 50000ms

frontend pg_cluster_write
    bind 10.0.0.10:5000
    default_backend pg_cluster_primary_backend

backend pg_cluster_primary_backend
    mode tcp
    option httpchk GET /primary
    http-check expect status 200
    default-server inter 2s fall 2 rise 2 on-marked-down shutdown-sessions
    server pg-node1 10.0.0.11:5432 maxconn 250 check port 8008
    server pg-node2 10.0.0.12:5432 maxconn 250 check port 8008
    server pg-node3 10.0.0.13:5432 maxconn 250 check port 8008

frontend pg_cluster_read
    bind 10.0.0.10:5001
    default_backend pg_cluster_replica_backend

backend pg_cluster_replica_backend
    mode tcp
    balance roundrobin
    option httpchk GET /replica
    http-check expect status 200
    default-server inter 3s fall 3 rise 2
    server pg-node1 10.0.0.11:5432 maxconn 250 check port 8008
    server pg-node2 10.0.0.12:5432 maxconn 250 check port 8008
    server pg-node3 10.0.0.13:5432 maxconn 250 check port 8008
Áp dụng cấu hình:
sudo systemctl restart haproxyPort 5000 sẽ chỉ trỏ đến duy nhất node primary đang hoạt động. Trong khi đó, port 5001 phân bổ các yêu cầu đọc đều qua các standby khả dụng, tránh để các tác vụ phân tích, báo cáo làm quá tải node ghi chính.
Bước 4: Nạp dữ liệu mẫu và thử nghiệm Failover
Kiểm tra đường truyền ghi qua proxy endpoint trước khi giả lập tình huống sự cố thực tế:
psql -h 10.0.0.10 -p 5000 -U postgres -d postgres -c "CREATE TABLE ha_test (id serial primary key, inserted_at timestamp default now());"
psql -h 10.0.0.10 -p 5000 -U postgres -d postgres -c "INSERT INTO ha_test SELECT generate_series(1, 1000);"
Mô phỏng sự cố sập nhân đột ngột (kernel panic) bằng cách buộc dừng tiến trình Patroni và PostgreSQL trên pg-node1:
# Chạy trực tiếp trên node leader đang hoạt động
sudo killall -9 patroni postgres
Theo dõi tiến trình failover của cluster từ pg-node2:
watch -n 1 sudo patronictl -c /etc/patroni/patroni.yml listQuá trình failover diễn ra hoàn tất trong khoảng 20 đến 25 giây. Trình tự sự kiện diễn ra như sau:
- Giây thứ 0: pg-node1 ngừng gửi heartbeat tới etcd.
- Giây thứ 10: Patroni bỏ lỡ chu kỳ gia hạn lease định kỳ.
- Giây thứ 30: Leader key trên etcd chính thức hết hạn. Node 2 và Node 3 tiến hành tranh quyền lock; Node 2 giành quyền nhờ có vị trí WAL tương ứng tốt nhất.
- Giây thứ 31: Node 2 chuyển từ timeline 1 sang timeline 2 và tự thăng cấp lên Leader.
- Giây thứ 33: HTTP health check của HAProxy tới node1 thất bại 2 lần liên tiếp, loại node này khỏi pool 5000. Đồng thời nhận phản hồi
HTTP 200từ node 2 và nhanh chóng chuyển hướng toàn bộ kết nối ghi sang 10.0.0.12.
Thực hiện kiểm tra cổng ghi từ máy client:
psql -h 10.0.0.10 -p 5000 -U postgres -d postgres -c "INSERT INTO ha_test (inserted_at) VALUES (now()) RETURNING *;"Lệnh ghi dữ liệu thành công trơn tru mà không cần chỉnh sửa bất kỳ cấu hình kết nối nào phía ứng dụng.
Bây giờ, hãy khởi động lại Patroni trên node vừa gặp sự cố (pg-node1):
sudo systemctl start patroniNhờ cấu hình use_pg_rewind: true, Patroni không cần dựng lại toàn bộ dữ liệu từ đầu. Thay vào đó, nó chạy pg_rewind để loại bỏ các transaction cục bộ chưa được commit, đồng bộ WAL theo timeline 2 và tái gia nhập cluster với vai trò standby khỏe mạnh.
Lời kết
Đảm bảo tính sẵn sàng cao không phải là ngồi hy vọng máy chủ không bao giờ sập. Bản chất của nó nằm ở việc thiết kế một hệ thống có khả năng tự phục hồi nhanh chóng và đáng tin cậy mỗi khi phần cứng gặp sự cố. etcd duy trì sự đồng thuận quorum nghiêm ngặt. Patroni giám sát vòng đời cơ sở dữ liệu và tự động xử lý tua lại WAL. HAProxy thông minh định tuyến các truy vấn dựa trên health check theo thời gian thực. Sự phối hợp của bộ ba này tạo nên một cluster vững chắc, chuẩn production, vượt qua sự cố sập node chỉ dưới 30 giây—bảo vệ toàn vẹn dữ liệu và giúp bạn có những ngày cuối tuần hoàn toàn thảnh thơi.