なぜ標準のストリーミングレプリケーションだけでは不十分なのか
午前3時の緊急呼び出しは、あらゆるDBAにとって悪夢です。プライマリデータベースのホストがネットワークから切断され、書き込みが滞り、プラットフォーム全体の決済処理が停止します。PostgreSQLの物理ストリーミングレプリケーションはWALセグメントを確実に転送しますが、クラスタの合意形成、ネットワーク分断の検知、クライアントクエリの再ルーティングを自律的に行うことはできません。
障害が発生すると、ストレスの多い手動対応を迫られます。スタンバイ側でpg_ctl promoteを実行し、アプリケーションの接続文字列を修正し、旧プライマリが停止したままであることを祈るしかありません。もしネットワーク分断されたプライマリが復帰して書き込みを受け付けてしまうと、スプリットブレイン状態に陥ります。タイムラインが分岐してトランザクションログが破損し、修復には何時間もの過酷な手動WAL修復作業が必要になります。
本番環境の高可用性を担保するには、以下の3つの明確な保証が必要です:
- 信頼性の高い合意形成:単一のプライマリノードに対してのみ一時的な排他リースを付与する分散クォーラムエンジン。
- 自動化されたライフサイクルオーケストレーション:切り離されたプライマリを安全に降格させ、
pg_basebackupを実行して障害ノードを再クローンし、レプリケーション遅延が最も少ない候補を昇格させるデーモン。 - 動的なクエリル―ティング:ヘルスチェックを通じてデータベースのロールを追跡し、接続文字列の変更やサービス再起動を不要にするインテリジェントなリバースプロキシ。
アーキテクチャ:各コンポーネントの連携の仕組み
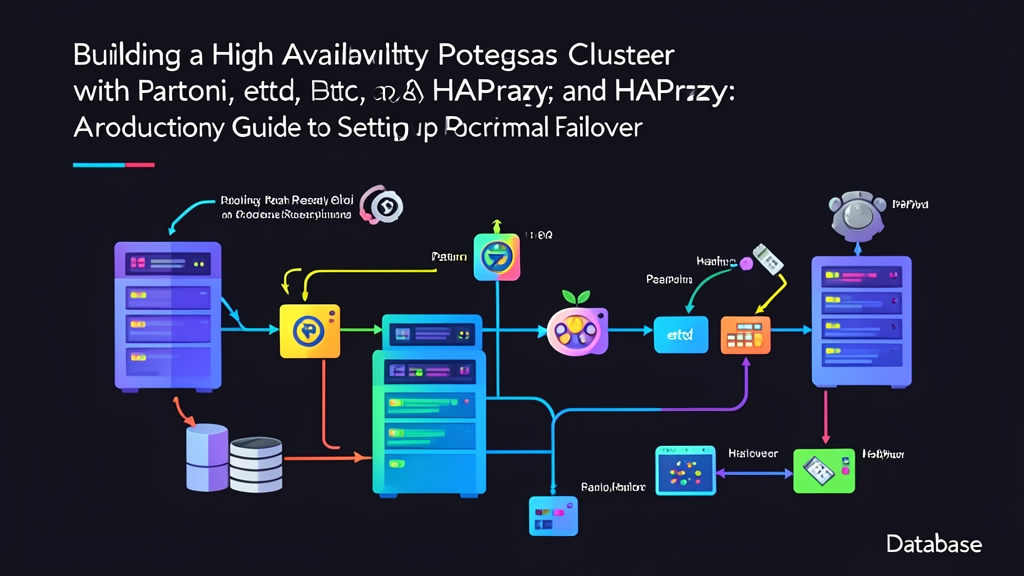
単一障害点(SPOF)を排除するため、本リファレンストポロジでは合意形成、プロセスマネジメント、接続ルーティングを3つの独立した層に分離しています:
1. 分散合意形成ストア(etcd)
中心に位置するのは、Raftアルゴリズムを採用した分散キーバリューストアのetcdです。3ノード構成のetcdクラスタは、過半数のクォーラムを維持しながら1ノードの障害を許容します。Patroniはetcd内に30秒の有効期限(TTL)を持つ分散リーダーロックを保持します。このアクティブなキーを保持しているノードのみが、読み書きトラフィックを受け付けることができます。
2. クラスタオーケストレータ(Patroni)
Patroniは、PostgreSQLを直接制御するPython製の管理デーモンです。プロセスの監視をsystemdに任せるのではなく、Patroni自身がデータベースプロセスのライフサイクルを管理します。アクティブなPatroniリーダーは10秒ごとにetcdのリースを更新します。ホストがフリーズしたりネットワークから切断されたりすると、リースは失効します。生き残ったスタンバイがロックの開放を検知して選挙を実施し、最も進んだWAL LSN位置を持つレプリカを自動的に昇格させます。
3. 動的プロキシ(HAProxy)
アプリケーション側で動的に変化するデータベーストポロジを追跡すべきではありません。HAProxyは、ポート8008で稼働するPatroniのRESTエンジンをポーリングすることでこれを解決します。アクティブなプライマリは/primaryに対してHTTP 200 OKを返し、スタンバイはHTTP 503 Service Unavailableを返します。読み取り専用レプリカに対しては、Patroniは/replicaでHTTP 200を応答します。HAProxyはこれらのエンドポイントを3秒ごとに確認し、ポート5000への書き込みをプライマリに、ポート5001への読み取りをレプリカ間で負荷分散します。
クラスタの構築:ステップ・バイ・ステップの実装手順
今回は、プライベートサブネット内の4つのインスタンスにこのアーキテクチャを展開します:
- pg-node1: 10.0.0.11(etcd + Patroni + PostgreSQL 16)
- pg-node2: 10.0.0.12(etcd + Patroni + PostgreSQL 16)
- pg-node3: 10.0.0.13(etcd + Patroni + PostgreSQL 16)
- haproxy-lb: 10.0.0.10(HAProxy ロードバランサ)
ステップ1:etcdクォーラムのデプロイ
3台のデータベースインスタンスすべてにetcdをインストールします:
sudo apt-get update
sudo apt-get install -y etcd-server etcd-client/etc/default/etcdを編集して、pg-node1 (10.0.0.11)上のetcdを設定します:
ETCD_NAME="node1"
ETCD_DATA_DIR="/var/lib/etcd/cluster.etcd"
ETCD_LISTEN_PEER_URLS="http://10.0.0.11:2380"
ETCD_LISTEN_CLIENT_URLS="http://10.0.0.11:2379,http://127.0.0.1:2379"
ETCD_INITIAL_ADVERTISE_PEER_URLS="http://10.0.0.11:2380"
ETCD_ADVERTISE_CLIENT_URLS="http://10.0.0.11:2379"
ETCD_INITIAL_CLUSTER="node1=http://10.0.0.11:2380,node2=http://10.0.0.12:2380,node3=http://10.0.0.13:2380"
ETCD_INITIAL_CLUSTER_TOKEN="pg-ha-token"
ETCD_INITIAL_CLUSTER_STATE="new"
node2およびnode3にも同様の設定を適用し、IPアドレスとホスト名を適宜変更します。合意形成クラスタを起動して動作確認を行います:
sudo systemctl restart etcd
sudo systemctl enable etcd

# クラスタのメンバーシップと健全性を確認
ETCDCTL_API=3 etcdctl --endpoints=http://127.0.0.1:2379 endpoint health
ETCDCTL_API=3 etcdctl --endpoints=http://127.0.0.1:2379 member list
ステップ2:Patroniのインストールと設定
PostgreSQL 16、Patroni、およびPython用のetcd3クライアントをインストールします:
sudo apt-get install -y postgresql-16 patroni python3-psycopg2 python3-etcd3Patroniが起動・停止シーケンスを排他的に制御できるように、systemdによるデフォルトのPostgreSQL管理を無効化します:
sudo systemctl stop postgresql
sudo systemctl disable postgresqlpg-node1上で/etc/patroni/patroni.ymlにPatroniの設定を作成します:
scope: postgres-prod
namespace: /service
name: pg-node1

restapi:
  listen: 10.0.0.11:8008
  connect_address: 10.0.0.11:8008

etcd3:
  hosts:
    - 10.0.0.11:2379
    - 10.0.0.12:2379
    - 10.0.0.13:2379

bootstrap:
  dcs:
    ttl: 30
    loop_wait: 10
    retry_timeout: 10
    maximum_lag_on_failover: 1048576  # 昇格資格を得るための最大WAL遅延(最大1MB)
    postgresql:
      use_pg_rewind: true
      parameters:
        wal_level: replica
        max_wal_senders: 10
        max_replication_slots: 10
        hot_standby: "on"

  initdb:
    - encoding: UTF8
    - data-checksums

  pg_hba:
    - host replication replicator 10.0.0.0/24 md5
    - host all all 0.0.0.0/0 md5

postgresql:
  listen: 10.0.0.11:5432
  connect_address: 10.0.0.11:5432
  data_dir: /var/lib/postgresql/16/patroni
  bin_dir: /usr/lib/postgresql/16/bin
  pgpass: /var/lib/postgresql/.pgpass
  authentication:
    replication:
      username: replicator
      password: RepSecretPassword123
    superuser:
      username: postgres
      password: PostgresSuperSecret123

tags:
  nofailover: false
  noloadbalance: false
clonefrom: falseこの設定をpg-node2とpg-node3にも複製します。それぞれのノードのローカルIPアドレスに合わせてname、restapi.listen、postgresql.listenを修正してください。Patroniを起動します:
sudo systemctl start patroni
sudo systemctl enable patroniPatroniは、最初にリーダーキーを取得したノード上で自動的にデータベースをブートストラップします。スタンバイノードはpg_basebackupを使用してリーダーのデータディレクトリをクローンします。いずれかのノードで以下の確認コマンドを実行します:
sudo patronictl -c /etc/patroni/patroni.yml list選出された1台のLeaderと2台のストリーミングReplicaからなる正常な3ノードクラスタが表示されます:
+ Cluster: postgres-prod (73491823901) ---+----+-----------+
| Member   | Host       | Role    | State   | TL | Lag in MB |
+----------+------------+---------+---------+----+-----------+
| pg-node1 | 10.0.0.11  | Leader  | running |  1 |           |
| pg-node2 | 10.0.0.12  | Replica | running |  1 |         0 |
| pg-node3 | 10.0.0.13  | Replica | running |  1 |         0 |
+----------+------------+---------+---------+----+-----------+
ステップ3:透過的なトラフィックルーティングのためのHAProxy設定
専用のバランサノード(10.0.0.10)にHAProxyをインストールします:
sudo apt-get install -y haproxy/etc/haproxy/haproxy.cfgに書き込み用および読み取り用のバックエンドを追加します:
global
    log /dev/log local0
    maxconn 4096

defaults
    log global
    mode tcp
    option tcplog
    timeout connect 3000ms
    timeout client 50000ms
    timeout server 50000ms

frontend pg_cluster_write
    bind 10.0.0.10:5000
    default_backend pg_cluster_primary_backend

backend pg_cluster_primary_backend
    mode tcp
    option httpchk GET /primary
    http-check expect status 200
    default-server inter 2s fall 2 rise 2 on-marked-down shutdown-sessions
    server pg-node1 10.0.0.11:5432 maxconn 250 check port 8008
    server pg-node2 10.0.0.12:5432 maxconn 250 check port 8008
    server pg-node3 10.0.0.13:5432 maxconn 250 check port 8008

frontend pg_cluster_read
    bind 10.0.0.10:5001
    default_backend pg_cluster_replica_backend

backend pg_cluster_replica_backend
    mode tcp
    balance roundrobin
    option httpchk GET /replica
    http-check expect status 200
    default-server inter 3s fall 3 rise 2
    server pg-node1 10.0.0.11:5432 maxconn 250 check port 8008
    server pg-node2 10.0.0.12:5432 maxconn 250 check port 8008
    server pg-node3 10.0.0.13:5432 maxconn 250 check port 8008
設定を反映します:
sudo systemctl restart haproxyポート5000はアクティブなプライマリノードのみをターゲットにします。ポート5001は利用可能なスタンバイ間で読み取りリクエストを分散し、分析クエリのワークロードが書き込みリーダーを圧迫するのを防ぎます。
ステップ4:テストデータの投入とフェイルオーバーの検証
本番障害をシミュレートする前に、プロキシエンドポイント経由の書き込みパスを検証します:
psql -h 10.0.0.10 -p 5000 -U postgres -d postgres -c "CREATE TABLE ha_test (id serial primary key, inserted_at timestamp default now());"
psql -h 10.0.0.10 -p 5000 -U postgres -d postgres -c "INSERT INTO ha_test SELECT generate_series(1, 1000);"pg-node1上でPatroniとPostgreSQLを強制終了し、突然のカーネルパニックをシミュレートします:
# アクティブなリーダー上で直接実行
sudo killall -9 patroni postgrespg-node2からクラスタのフェイルオーバーの様子を観察します:
watch -n 1 sudo patronictl -c /etc/patroni/patroni.yml listフェイルオーバーは約20〜25秒で完了します。一連の動作フローは以下の通りです:
- 0秒:pg-node1がetcdへのハートビート送信を停止。
- 10秒:Patroniが通常のリース更新ウィンドウを逃す。
- 30秒:etcdのリーダーキーが失効。Node 2とNode 3がロックを争奪し、WAL位置が一致しているNode 2がキーを獲得。
- 31秒:Node 2がタイムライン1をタイムライン2に進め、Leaderに昇格。
- 33秒:HAProxyからnode1へのHTTPヘルスチェックが2回連続で失敗し、プール5000から除外される。node2で
HTTP 200を検知し、書き込み接続先を10.0.0.12へと切り替える。
クライアントマシンから書き込みポートに対してクエリを実行してみます:
psql -h 10.0.0.10 -p 5000 -U postgres -d postgres -c "INSERT INTO ha_test (inserted_at) VALUES (now()) RETURNING *;"アプリケーション側の接続設定を変更することなく、書き込みが成功します。
次に、障害が発生したノード(pg-node1)でPatroniを再起動します:
sudo systemctl start patroniuse_pg_rewind: trueを設定しているため、Patroniはクラスタ全体の完全な再構築を必要としません。代わりにpg_rewindを実行してローカルの未コミットトランザクションを破棄し、WALをタイムライン2に同期させて健全なスタンバイとしてクラスタに再参加します。
まとめ
高可用性とは、サーバーが決してクラッシュしないことを祈ることではありません。ハードウェア障害が発生した際に、自律的かつ迅速・確実に自己修復するシステムを設計することです。etcdが厳格なクォーラム合意形成を維持し、Patroniがデータベースのライフサイクル管理とWALの巻き戻しを担当し、HAProxyがリアルタイムのヘルスチェックに基づいてクエリを振り分けます。これらのツールを組み合わせることで、ノード障害から30秒未満で復旧し、データを損なうことなく週末を平穏に過ごせる、堅牢な本番向けクラスタを実現できます。