現場の課題:MySQLクラスタがダウンした夜
6ヶ月前、私たちのEコマースAPIはフラッシュセールによる急激なトラフィック急増に見舞われ、データベース層のあらゆるアーキテクチャ上の弱点が浮き彫りになりました。Kubernetesクラスタはわずか3分間で20から120のアプリケーションPodへとスケールしました。その直後、プライマリのMySQLデータベースは悪名高いエラー ERROR 1040 (08004): Too many connections を返して新規トラフィックを拒否し始めました。
アプリケーションの応答レイテンシは45ミリ秒から8秒以上へと跳ね上がりました。さらに深刻なことに、受け取ったリクエストの85%が商品カタログやユーザープロファイルを取得する単純な読み取りクエリであったにもかかわらず、プライマリのWriterノードはCPU枯渇によりクラッシュしてしまったのです。
これまでさまざまなプロジェクトでMySQL、PostgreSQL、MongoDBを扱ってきましたが、それぞれに独自の強みがあるものの、MySQLのレプリケーションアーキテクチャでは、バックエンドの並行性が急増した際に計画的なトラフィック管理が不可欠になります。当時、プーリングされていない何百もの接続ハンドシェイクと読み書き混在のクエリ負荷によってプライマリノードが窒息状態に陥っていた一方で、3台のリードレプリカはほぼアイドル状態で放置されていました。
根本原因の分析:高並行下でMySQLがボトルネックに陥る理由
インシデント後のテレメトリをチームで分析した結果、MySQLクラスタに悪影響を及ぼしていた3つのアーキテクチャ上の欠陥が特定されました。
1. スレッド・パー・コネクションのコスト
MySQLは従来、クライアント接続ごとに1つのOSスレッドを割り当てます。各接続は、sort_buffer_size、read_buffer_size、接続スタックメモリなどの内部バッファ用のメモリを確保します。120個のコンテナレプリカがそれぞれ30個のコネクションプールを保持すると、MySQLは3,600個のアクティブスレッドを処理しなければなりません。Linuxカーネルは、MySQLがクエリを実行する時間よりも多くのCPUサイクルをコンテキストスイッチに費やすことになります。
2. 柔軟性に欠けるアプリケーション層のルーティング
当時のマイクロサービスは、Writerを指すデータソースと、リードレプリカのラウンドロビンDNSを指すデータソースの2つを持つ構成になっていました。しかし実際には、開発者が単純な読み取りクエリをトランザクションブロック内でラップしてしまったり、データベーストランザクションを読み取り専用としてマークし忘れたりすることが頻繁に発生していました。その結果、ORMはそれらのクエリをWriterノードに直接送信し、リードレプリカを完全にバイパスしてしまったのです。
3. クエリの重複とキャッシュスタンピード
フラッシュセール中、何万人ものユーザーが上位10個の同一のセール対象商品を閲覧していました。ページがロードされるたびに、データベースに対して新たな SELECT クエリが発行されました。アプリケーション層とMySQLの間に中間クエリキャッシュが存在しなかったため、全く同一のクエリがディスクI/Oに繰り返し負荷をかけ続けることになりました。
ソリューションの比較:最適なミドルウェアの選定
何千行ものアプリケーションコードを書き直すことなくこれらのボトルネックを解消するため、最終決定を下す前に3つのアーキテクチャ候補を比較検討しました。
選択肢1: コードレベルのルーティングとローカルプーリング(HikariCP / ORMプラグイン)
当初は、クライアント側のコネクションプールを調整し、コード内で厳格な読み書きのアノテーションを適用することを試みました。この方法ではインフラを追加する必要はありませんが、コンテナ環境では重大な制限が生じます。マイクロサービスが動的にスケールすると、全体のデータベース接続数が制御不能なほど増加します。さらに、ルーティングルールを変更するたびにコードのデプロイとPodの再起動が必要になります。
選択肢2: ネットワーク層のロードバランサー(HAProxy / AWS NLB)
HAProxyはレイヤー4(L4)TCPプロキシとして極めて優秀に機能します。しかし、L4バランサーはSQLペイロードの中身を認識できません。クエリテキストを検査できないため、同じポートに入ってくる SELECT と UPDATE を分離することが不可能です。書き込み用と読み取り用で2つの独立したアプリケーションエンドポイントを公開する必要があり、ルーティングの負担は完全にアプリケーション開発者に委ねられます。
選択肢3: レイヤー7 SQL対応プロキシ(ProxySQL)
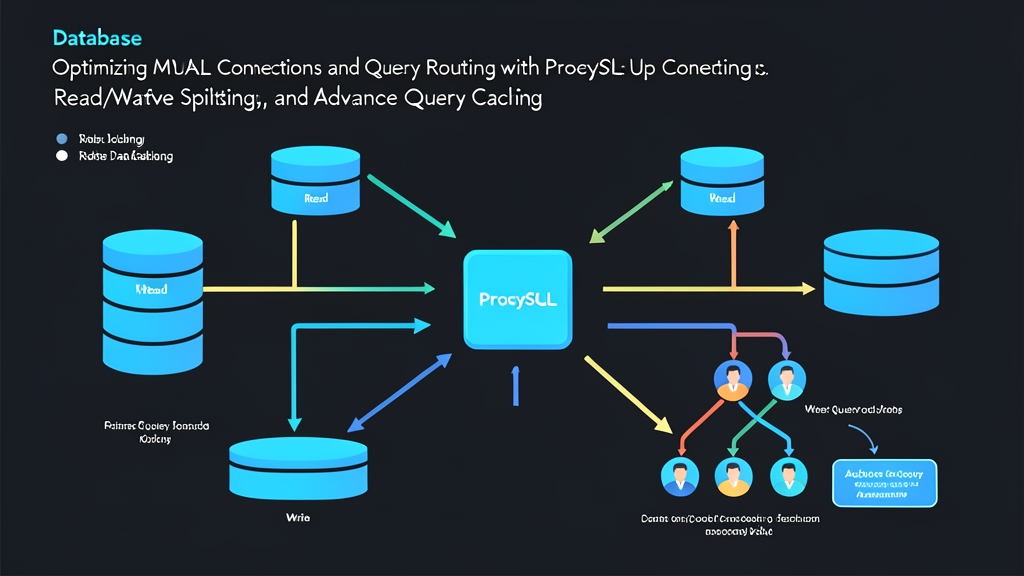
ProxySQLはアプリケーションプロトコル層(L7)で動作します。ネイティブのMySQLワイヤプロトコルを解釈し、バックエンドサーバーへの永続コネクションプールを維持し、正規表現パターンによってSQLステートメントを検査し、結果セットをメモリ内にキャッシュできます。マルチプレキシング(多重化)によってクライアント接続をバックエンドのデータベーススレッドから切り離すため、5,000のアプリケーション接続をわずか60の永続バックエンドMySQL接続で容易に処理できます。
最適なアプローチ:ProxySQLによる本番環境セットアップ
プライマリ・レプリカクラスタの前段でProxySQLを6ヶ月間稼働させた結果、データベースのメトリクスは完全に安定しました。ここでは、接続の多重化、高度な読み書き分離、高パフォーマンスなクエリキャッシュを実現するために採用した実際の設定戦略を紹介します。
ステップ1: ProxySQL Adminインターフェースへの接続
ProxySQLは独立したデーモンとして稼働します。アプリケーションからのSQLトラフィックを受け付けるポート 6033 と、標準的なMySQLクライアント構文で管理設定を行うためのポート 6032 の2つを公開します。
# ProxySQL Adminインターフェースへの接続
mysql -u admin -padmin -h 127.0.0.1 -P 6032 --prompt='ProxySQL Admin> '
ステップ2: バックエンドホストグループの定義
ProxySQLはデータベースサーバーをホストグループに分類します。私たちのトポロジでは、ホストグループ10をプライマリWriterノード用とし、ホストグループ20にリードレプリカを配置しています。
-- プライマリWriterの登録(ホストグループ 10)
INSERT INTO mysql_servers (hostgroup_id, hostname, port, max_connections, weight)
VALUES (10, '192.168.10.11', 3306, 100, 1000);

-- リードレプリカの登録(ホストグループ 20)
INSERT INTO mysql_servers (hostgroup_id, hostname, port, max_connections, weight)
VALUES
  (20, '192.168.10.12', 3306, 150, 100),
  (20, '192.168.10.13', 3306, 150, 100);

-- 設定を実行環境およびディスクへ保存
LOAD MYSQL SERVERS TO RUNTIME;
SAVE MYSQL SERVERS TO DISK;
ステップ3: ユーザーとコネクションプーリングの設定
ProxySQLは、受信したアプリケーショントラフィックを検証し、プーリングされたバックエンド接続を確立するための認証情報を必要とします。ProxySQLはマルチプレキシングエンジンを使用してコネクションプーリングを自動的に処理します。
-- デフォルトのホストグループをWriterに向けたアプリケーションユーザーを定義
INSERT INTO mysql_users (username, password, default_hostgroup, transaction_persistent)
VALUES ('app_user', 'SecurePassword123!', 10, 1);

LOAD MYSQL USERS TO RUNTIME;
SAVE MYSQL USERS TO DISK;
transaction_persistent=1 の設定により、トランザクションが開始された際(BEGIN または START TRANSACTION)、COMMIT または ROLLBACK が実行されるまで、そのセッション内の後続クエリはすべてWriterホストグループに固定され、書き込み直後の読み取り(Read-after-write)の整合性エラーを防ぎます。
ステップ4: クエリルールによる読み書きの自動分離
書き込みクエリ、明示的なロック、トランザクションはホストグループ10に転送し、一般的な読み取りクエリはホストグループ20にオフロードします。ProxySQLは rule_id に基づいてルールを順番に評価します。
-- ルール1: 書き込みクエリおよびロック確認をWriter(ホストグループ 10)へルーティング
INSERT INTO mysql_query_rules (rule_id, active, match_pattern, destination_hostgroup, apply)
VALUES
  (100, 1, '^SELECT.*FOR UPDATE', 10, 1),
  (101, 1, '^(INSERT|UPDATE|DELETE|REPLACE)', 10, 1);

-- ルール2: 一般的なSELECTクエリをすべてリードレプリカ(ホストグループ 20)へルーティング
INSERT INTO mysql_query_rules (rule_id, active, match_pattern, destination_hostgroup, apply)
VALUES (200, 1, '^SELECT', 20, 1);

LOAD MYSQL QUERY RULES TO RUNTIME;
SAVE MYSQL QUERY RULES TO DISK;
これら3つのルールを有効にすることで、開発者はどのデータベースホストにクエリを発行すべきかを意識する必要がなくなります。アプリケーションはポート 6033 経由でProxySQLに接続するだけで、クエリのルーティングはマイクロ秒単位で透過的に行われます。
ステップ5: 高頻度リード向けクエリキャッシュの実装
MySQLは、グローバルミューテックスの競合を理由にバージョン8.0でネイティブのクエリキャッシュを廃止しました。しかしProxySQLを使えば、ストレージエンジンの外部で安全にクエリキャッシュ機能を復活させることができます。キャッシュTTL(ミリ秒単位)を指定することで、負荷の高いクエリやアクセス頻度の高い読み取りクエリをProxySQLのメモリ内に直接キャッシュできます。
-- 商品カタログのクエリを5秒間(5000ミリ秒)キャッシュ
INSERT INTO mysql_query_rules (rule_id, active, match_pattern, destination_hostgroup, cache_ttl, apply)
VALUES (300, 1, '^SELECT.*FROM products WHERE status = .published.', 20, 5000, 1);

LOAD MYSQL QUERY RULES TO RUNTIME;
SAVE MYSQL QUERY RULES TO DISK;
直近のプロモーションキャンペーンでは、この単一ルールだけで毎秒12,000クエリをProxySQLのRAMから直接処理し、レプリカのCPU使用率を20%未満に抑えることができました。
ステップ6: トラフィックとメトリクスの検証
ProxySQLは、コネクションプーリングの効率やキャッシュヒット率をリアルタイムで確認できる充実したランタイム診断テーブルを提供しています。
-- ホストグループのコネクションプール使用状況を確認
SELECT hostgroup, srv_host, status, ConnUsed, ConnFree, ConnOK
FROM stats_mysql_connection_pool;

-- クエリルールのヒット数と実行回数を確認
SELECT rule_id, hits FROM stats_mysql_query_rules ORDER BY hits DESC;

-- クエリキャッシュのパフォーマンスを確認
SELECT * FROM stats_mysql_global WHERE Variable_Name LIKE 'Query_Cache%';
本番運用6ヶ月のレビュー:導入成果
過去2四半期にわたりProxySQLを本番環境で運用した結果、次のような具体的かつ大幅なパフォーマンス改善が得られました。
- バックエンド接続数: 3台のMySQLインスタンス全体で、予測不能だったピーク時の3,800の直接接続から、多重化によってわずか75接続へと削減されました。
- クエリレイテンシ: 接続の再利用とエッジでのクエリキャッシュにより、P95の読み取り応答時間が42ミリ秒から8ミリ秒へと短縮されました。
- ダウンタイムなしのメンテナンス: ProxySQL内で
status='OFFLINE_SOFT'を設定することでレプリカを正常に切り離し、実行中のトランザクションを安全に完了させてからデータベースのアップグレードを実施し、ユーザーリクエストを1件も落とすことなくオンラインに復帰できるようになりました。
高トラフィックのMySQLクラスタを運用しているエンジニアリングチームにとって、専用のプロキシ層としてProxySQLを導入することは、アプリケーション開発者にアーキテクチャの書き直しを強いることなく、接続の枯渇とリードスケーリングの課題を解決する極めて有効なアプローチとなります。