クイックスタート — Thanosを5分で動かす
複数のKubernetesクラスターでPrometheusを動かすこと自体は難しくない。だが、数ヶ月分の履歴データを保持しながら、全クラスターにまたがる単一のクエリエンドポイントを信頼性高く運用するとなると、ほとんどのチームが壁にぶつかる。Thanosはまさにこの問題を解決する。私が本番環境で使ったところ、メトリクスの保持期間がPrometheusのデフォルトである15日から13ヶ月以上に伸び、しかもいずれのクラスターのローカルストレージにも1GBも追加せずに済んだ。
まず前提として、クラスター内でPrometheusインスタンスがすでに稼働している必要がある。その状態であれば、Thanosの追加は驚くほど軽量だ。まずSidecarから始めよう――PrometheusポッドのすぐそばでRunするコンテナだ:
containers:
  - name: prometheus
    image: prom/prometheus:v2.47.0
    args:
      - --storage.tsdb.min-block-duration=2h
      - --storage.tsdb.max-block-duration=2h
      - --web.enable-lifecycle
  - name: thanos-sidecar
    image: quay.io/thanos/thanos:v0.35.0
    args:
      - sidecar
      - --tsdb.path=/prometheus
      - --prometheus.url=http://localhost:9090
      - --grpc-address=0.0.0.0:10901
      - --http-address=0.0.0.0:10902
      - --objstore.config-file=/etc/thanos/objstore.yaml
    volumeMounts:
      - name: prometheus-data
        mountPath: /prometheus
      - name: thanos-objstore-config
mountPath: /etc/thanosmin-block-durationとmax-block-durationの両方を2hに設定するのは意図的だ。これはPrometheusにブロックの自己圧縮をやめさせ、その役割をThanos Compactorに委ねるよう指示している。多くのガイドはこの設定を省略している。省略してはいけない。
詳細解説 — 本当に理解すべきThanosのアーキテクチャ
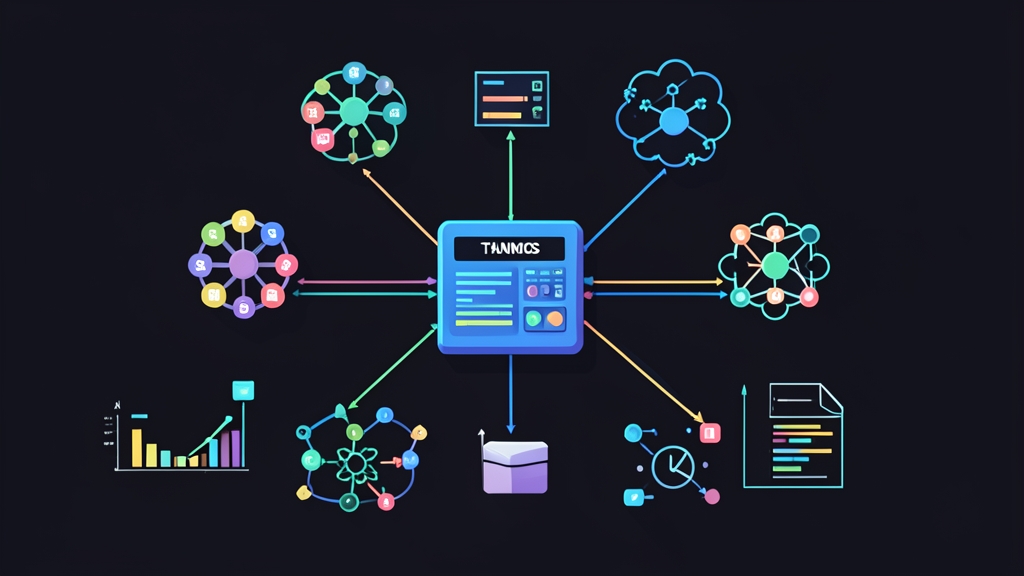
Thanosは単一のバイナリではなく、複数のコンポーネントで構成されている。それぞれに固有の役割がある。このメンタルモデルを把握しないと、原因ではなく症状のデバッグに何時間も費やすことになる。
Sidecar — オブジェクトストレージへの橋渡し
Sidecarは各Prometheusインスタンスの隣で動作する。役割は2つある。QuerierがアクセスできるようPrometheusデータをgRPC経由で公開すること、そして完成した2時間分のTSDBブロックをオブジェクトストレージバケットに転送することだ。オブジェクトストレージのバックエンドは別のSecretに設定しよう:
type: S3
config:
  bucket: my-thanos-metrics
  endpoint: s3.amazonaws.com
  region: ap-northeast-1
  access_key: AKIAIOSFODNN7EXAMPLE
  secret_key: wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY
ThanosはS3、GCS、Azure Blob、MinIOをサポートしている。セルフホスト環境ならMinIOが定番だ――S3 APIに対応しており、最小限のオーバーヘッドでKubernetes上で動作する。
Store Gateway — オブジェクトストレージからの読み取り
ブロックがオブジェクトストレージに格納されると、Store Gatewayが再びクエリ可能にする。別のDeploymentとしてデプロイしよう:
thanos store \
  --data-dir=/var/thanos/store \
  --grpc-address=0.0.0.0:10901 \
  --http-address=0.0.0.0:10902 \
  --objstore.config-file=/etc/thanos/objstore.yaml
Store Gatewayはブロックのインデックスファイルをローカルにダウンロードし、メトリクスデータをオンデマンドでストリーミングする。全データをメモリに読み込むのではなく、チャンクを遅延フェッチする仕組みだ。数年分のデータを持つ大きなバケットの場合、インデックスキャッシュ用にSSDバックのPVCを用意しよう。この一つの変更で、6ヶ月分のレンジクエリが12秒から2秒未満に短縮された。
Querier — 単一クエリエンドポイント
ユーザーが直接操作するコンポーネントだ。PrometheusのCompatible APIとして動作しながら、すべてのSidecarとStore Gatewayにクエリをファンアウトし、結果を重複排除する:
thanos query \
  --http-address=0.0.0.0:9090 \
  --grpc-address=0.0.0.0:10901 \
  --query.replica-label=prometheus_replica \
  --store=thanos-sidecar-cluster-a:10901 \
  --store=thanos-sidecar-cluster-b:10901 \
  --store=thanos-store-gateway:10901
GrafanaをQuerierのHTTPポートに向けよう。ダッシュボードは1つのURLで複数のクラスターとオブジェクトストレージからデータを取得できるようになる――クラスターの切り替えも、クラスターごとにデータソースを管理する煩わしさも不要だ。
Compactor — オブジェクトストレージの効率的な管理
Compactorがないと、オブジェクトストレージは数千もの小さな2時間ブロックでいっぱいになる。Compactorはそれらをより大きなブロック(6時間、2日、2週間)に統合し、古いデータにダウンサンプリングを適用する:
thanos compact \
  --data-dir=/var/thanos/compact \
  --objstore.config-file=/etc/thanos/objstore.yaml \
  --retention.resolution-raw=30d \
  --retention.resolution-5m=90d \
  --retention.resolution-1h=1y \
  --wait
単一レプリカのDeploymentとして実行しよう――同一バケットへの同時アクセスをサポートしていないため、スケールアップしてはいけない。上記のretentionフラグにより、生データは30日間、5分ダウンサンプルは90日間、1時間ダウンサンプルは1年間保持される。1時間解像度で1年分のデータをクエリするのは高速かつ低コストだ。
応用編 — スケールする複数クラスター連携
DNS SDによるサービスディスカバリ
QuerierにSidecarのアドレスをハードコーディングするのは2クラスターなら問題ない。5クラスター以上になったら、DNSベースのサービスディスカバリを使おう。SidecarにヘッドレスServiceを作成し、ThanosをDNS名に向ける:
thanos query \
  --store=dnssrv+_grpc._tcp.thanos-sidecar.monitoring.svc.cluster.local \
  --store=thanos-store-gateway.monitoring.svc.cluster.local:10901
クラスター間ディスカバリには、クラスターごとにThanos Querierを実行し、トップレベルのQuerierをそれら全てに向ける。これがQuery Frontendパターンだ。さらにキャッシュとクエリ分割が加わる:
thanos query-frontend \
  --http-address=0.0.0.0:9090 \
  --query-frontend.downstream-url=http://thanos-querier:9090 \
  --query-range.split-interval=24h \
  --query-range.max-retries-per-request=5 \
  --cache-compression-type=snappy
Query Frontendは長期間のクエリを24時間チャンクに分割し、各チャンクを独立してキャッシュする。30日分のデータをロードするダッシュボードが、1つの遅いクエリから30個の並列キャッシュ可能なクエリに変わる。
Ruler — クラスターをまたぐアラートと記録ルール
Prometheusがネイティブにできないことの一つが、2つの異なるクラスターのメトリクスを参照するRecording Ruleを評価することだ。Thanos Rulerなら可能だ:
apiVersion: v1
kind: ConfigMap
metadata:
  name: thanos-ruler-rules
data:
  rules.yaml: |
    groups:
      - name: cross-cluster
        interval: 1m
        rules:
          - record: job:http_requests:rate5m
            expr: sum(rate(http_requests_total[5m])) by (job, cluster)
Rulerは全クラスターを一度に把握するQuerierにクエリを投げ、結果を新しいTSDBブロックとしてオブジェクトストレージに書き戻す。各クラスターは他のクラスターの存在を知らないまま。グローバルビューはRulerの中だけに存在する。
現場から学ぶ実践的なヒント
クラスターにラベルを付ける — 全てはここから始まる
各Prometheusインスタンスに外部ラベルを追加しよう。これがないと重複排除が機能せず、クエリで重複した時系列が見えてしまう:
global:
  external_labels:
    cluster: production-ap-northeast-1
    region: ap-northeast-1
外部ラベルを省略したチームは、リクエスト数のグラフが実際の2倍を示す原因のデバッグに何日も費やす。3度のクラスター移行でこの光景を目の当たりにしてきた。
オブジェクトストレージのコストを監視する
Thanosは2時間ブロックごとにアップロードする。15秒間隔で10万件の時系列をスクレイプするクラスターでは、圧縮前で1日あたり約500MBになる。バケットレベルで圧縮を有効にしよう――S3はデフォルトでオブジェクトを圧縮しない。また、LIST APIコールにも注意が必要だ。Store Gatewayは起動時とクエリ中にLISTを多用するが、S3のLIST操作は無料ではない。
簡単なコスト確認として、バケットの構造を一覧してブロックの蓄積を確認しよう:
# ブロック数とサイズを確認する
aws s3 ls s3://my-thanos-metrics/ --recursive --human-readable | \
  awk '{print $3, $4}' | \
  tail -20

# ブロックの合計数を数える
aws s3 ls s3://my-thanos-metrics/ | wc -l
Store Gatewayのキャッシュをチューニングする
Store Gatewayのデフォルトのインメモリインデックスキャッシュは250MBだ。数ヶ月以上のデータを持つバケットでは、これを増やそう:
thanos store \
  --index-cache-size=1GB \
  --chunk-pool-size=2GB \
  --store.grpc.series-max-concurrency=20
あるいは、RedisやMemcachedインスタンスを共有キャッシュとして接続することもできる。複数のエンジニアが同じ時間範囲を同時にクエリする場合に大きな差が出る――これがないと、全ポッドがオブジェクトストレージから同じインデックスデータを個別にフェッチしてしまう。
Thanos自体を監視する
Thanosは各コンポーネントのHTTPポートの/metricsでPrometheusメトリクスを公開している。実際に監視すべきメトリクスはこれだ:
thanos_compact_group_compactions_total— 圧縮の健全性thanos_store_bucket_operations_total— オブジェクトストレージAPIコールレートthanos_query_concurrent_gate_queries_in_flight— Querierのクエリ負荷thanos_sidecar_prometheus_up— SidecarがPrometheusに到達可能か(常に1であるべき)
ブロックが正常に転送されているかの簡単な確認方法:
kubectl logs deployment/prometheus -c thanos-sidecar | grep -i "uploaded"
# 期待される出力:
# level=info msg="uploaded block" id=01HXYZ... duration=2.3s
アップロードのログが2時間ごとに表示されない場合は、まずTSDBのブロック期間設定を確認し、次にSidecarのオブジェクトストレージ認証情報を検証しよう。
クラスターが1つを超えるか、保持要件が数週間を超えたとき、Thanosはオーバーヘッドではなくなる。新しいクラスターを追加する?Sidecarをひとつ追加して--storeフラグをひとつ足すだけだ。読み取りスループットが必要?Store Gatewayを追加しよう。Querierは自動的にファンアウトする――他は何も触らなくていい。