問題:大規模クラスターでのイメージプルストーム
大規模なKubernetesクラスターを運用していると、必ず同じ壁にぶつかります:イメージプルストームです。新しいイメージタグをプッシュしてローリングアップデートをトリガーすると、突然40ノードが同時にコンテナレジストリを叩き始めます。レジストリは過負荷になり、ノードはレイヤーの待機でタイムアウトし、本来5分で終わるはずのデプロイが25分の消火作業に変わります。
よくある応急処置——レジストリのレプリカ数を増やす、インスタンスサイズを上げる、プレミアムアーティファクトレジストリに課金する——は効果はありますが、コストがかかる上に根本原因を解決しません。各ノードが同じレイヤーを同じソースから独立してプルしているのが問題です。これはクラスターが大きくなるほど悪化する、根本的に無駄なパターンです。
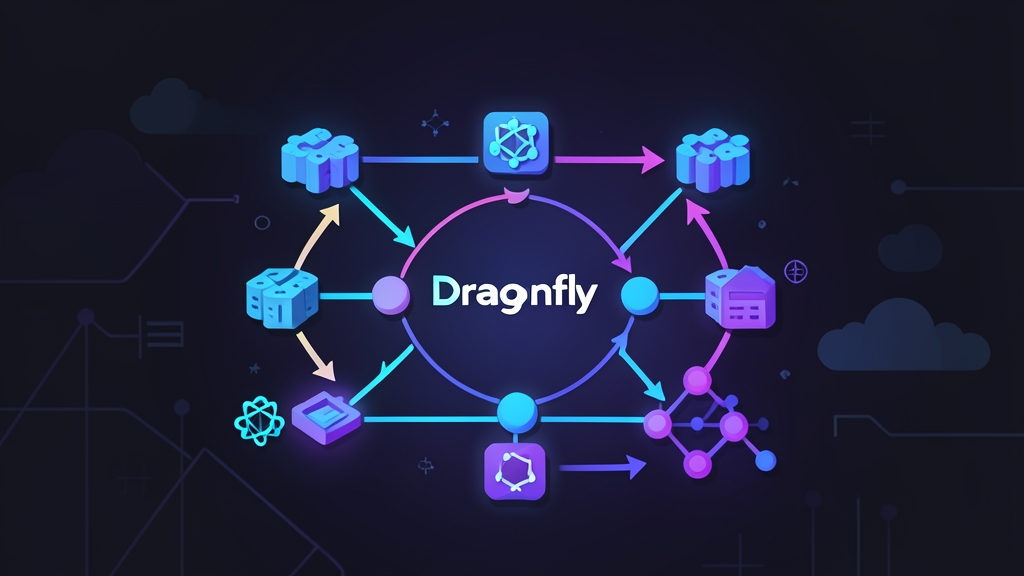
Dragonflyはこの問題をプロトコルレベルで解決します。Nノードがそれぞれレジストリから500MBのレイヤーをプルする代わりに、1つのノードがプルして残りはP2Pで取得します。レジストリはデータを一度だけ配信します——最初のシードピアにのみ。
Dragonflyの仕組み:コアコンセプト
DragonflyはAlibaba内部で、数万ノードへのデプロイのために開発されました。現在はCNCFのインキュベーティングプロジェクトです。P2Pアプローチにより、ノードが協力してイメージレイヤーを配布します——KubernetesクラスターにBitTorrentを適用したイメージで考えると分かりやすいです。
主要コンポーネント
- Manager:コントロールプレーン。ピア情報を保存し、スケジューラーの検出を管理し、クラスター全体の動的設定を処理します。
- Scheduler:P2Pネットワークの頭脳。ノードがレイヤーを必要とする際、どのピアがすでにそれを持っているか(完全または部分的に)を判断し、最適なピアグラフを構築します。
- Seed Peer:レジストリからレイヤーを一度ダウンロードし、クラスターの残りのノードへの初期シーダーになります。冗長性のために少なくとも2つ実行してください。
- Dfdaemon(Client):全ノードでDaemonSetとして実行されます。コンテナランタイムのレイヤープルをインターセプトし、P2Pネットワーク経由にリダイレクトし、データを取得後に他のノードへシードします。
プルフロー
ノードがnginx:1.27をプルしようとします。Dfdaemonはそのリクエストをインターセプトし、Schedulerに確認した上で、Docker Hubから直接取得する代わりに、すでにレイヤーをダウンロードした3〜5ピアからチャンクをプルします。レジストリはデータを一度だけ配信します——最初のシードピアにのみ。
最初に驚いたのは:Dragonflyはレジストリを置き換えたり、イメージへの変更を必要としないことです。コンテナランタイムレベルの透過的なプロキシとして動作します。既存のCIパイプライン、イメージ参照、デプロイメントマニフェストへの変更は一切不要です。
KubernetesへのDragonflyのデプロイ
前提条件
- Kubernetes 1.20以上のクラスター
- Helm 3のインストール済み
- コンテナランタイムとしてcontainerd(Docker非推奨化後の最も一般的な選択)
- クラスターアクセスが設定済みのkubectl
ステップ1:Helmでインストール
helm repo add dragonfly https://dragonflyoss.github.io/helm-charts/
helm repo update

helm install --create-namespace --namespace dragonfly-system \
  dragonfly dragonfly/dragonfly \
  --set seedPeer.enable=true \
  --set seedPeer.replicas=2 \
  --set scheduler.replicas=2 \
  --set manager.replicas=2
全ポッドが起動するまで待ちます:
kubectl -n dragonfly-system get pods -wManager、Scheduler、Seed Peer、Client(DaemonSet)のポッドがすべて実行中になっていることを確認してください。Client DaemonSetはノードごとに1つのポッドをデプロイします——これが各ワーカーノードでローカルに実行されるdfdaemonプロキシです。
ステップ2:Dragonfly経由でプロキシするようcontainerdを設定する
この手順は多くのガイドが簡略化しがちですが、最も重要な部分です。レジストリに直接アクセスする代わりに、ローカルのdfdaemonプロキシ経由でイメージプルをルーティングするようcontainerdに設定する必要があります。Dfdaemonはデフォルトでポート65001をリッスンします。
各ノードにcontainerdミラー設定を作成します:
# Docker Hubミラーリングの設定
mkdir -p /etc/containerd/certs.d/docker.io

cat > /etc/containerd/certs.d/docker.io/hosts.toml <<EOF
server = "https://registry-1.docker.io"

[host."http://127.0.0.1:65001"]
  capabilities = ["pull", "resolve"]
  skip_verify = true
  override_path = true
EOF
プライベートレジストリの場合は、同じ構造を繰り返します:
# registry.example.comのプライベートレジストリ設定
mkdir -p /etc/containerd/certs.d/registry.example.com

cat > /etc/containerd/certs.d/registry.example.com/hosts.toml <<EOF
server = "https://registry.example.com"

[host."http://127.0.0.1:65001"]
  capabilities = ["pull", "resolve"]
  skip_verify = true
  override_path = true
EOF

systemctl restart containerd
クラウドプロバイダーのノードグループやAnsibleでノードを管理している場合は、テストの前にこの手順を全ワーカーノードに自動化してください。
ステップ3:P2P配布が機能していることを確認する
テストポッドでイメージプルを強制実行します:
kubectl run test-pull --image=nginx:1.27 --restart=Never
kubectl get pod test-pull -w
ポッドがスケジュールされたノードのdfdaemonログを確認します:
NODE=$(kubectl get pod test-pull -o jsonpath='{.spec.nodeName}')
DAEMON_POD=$(kubectl -n dragonfly-system get pod -o wide \
  | grep "$NODE" | grep client | awk '{print $1}')
kubectl -n dragonfly-system logs $DAEMON_POD | grep -i "p2p\|peer\|task"
レジストリから直接ではなく、P2Pピアからレイヤーを取得していることを示すログエントリを探してください。同じイメージをプルする後続のノードでは、プル時間が大幅に短縮されます——シードピアにデータがキャッシュされると、通常5〜10倍速くなります。
ステップ4:Dragonflyコンソールで監視する
Dragonfly Managerにはウェブコンソールが付属しています。アクセスするにはポートフォワードを使います:
kubectl -n dragonfly-system port-forward svc/dragonfly-manager 8080:8080http://localhost:8080にアクセスします。アクティブなタスク、ピア数、リアルタイムのトラフィックグラフから、P2Pネットワークを流れるデータをリアルタイムで確認できます——レジストリが全リクエストを受け続けているかどうかを推測するよりも、はるかに安心できます。
本番環境での使用経験から
複数の本番クラスターで運用してきましたが、安定して動作します——ただし、準備ができていないと痛い目を見るいくつかの落とし穴があります。
Dfdaemon DaemonSetにリソース制限を設定する
クライアントデーモンは全ノードで実行されるため、メモリ使用量が無制限だとリソースの少ないノードで問題が発生します。Helm valuesに以下の制限を追加してください:
client:
  resources:
    limits:
      cpu: "500m"
      memory: "512Mi"
    requests:
      cpu: "100m"
      memory: "128Mi"
常に2つのSeed Peerレプリカを実行する
単一のシードピアポッドがデプロイの途中で再起動すると、ノードは直接レジストリプルにフォールバックします——安全ではありますが、そのロールアウトの帯域幅節約効果が失われます。2つのレプリカがあれば、ポッドの停止中もスムーズに動作します。
Dfdaemon設定のレジストリ許可リストを確認する
新しいバージョンのDragonflyには、プロキシ対象レジストリのフィルターリストが含まれています。プライベートレジストリのホスト名が含まれていることを確認してください。そうでないと、プルはP2Pネットワークを完全にバイパスします:
kubectl -n dragonfly-system get configmap dragonfly-client -o yaml \
  | grep -A 20 "proxy"
大規模クラスター向けにピア接続数を調整する
デフォルトのピア接続数は最大約50ノードで問題なく動作します。大規模クラスターの場合は、スケジューラーのピアタスク並行制限を調整して、ピースごとにより多くの同時接続を許可してください:
scheduler:
  config:
    scheduler:
      peerTaskTTL: 24h
      retryBackToSourceLimit: 3
実際に得られるもの
DragonflyはKubernetesノードをN個の独立したレジストリクライアントから、協調的な配布ネットワークへと変えます。有効化後の最初のデプロイで、どれだけの帯域幅を無駄にしていたかが一目瞭然になります。30ノード以上のクラスターでは、レジストリのエグレス帯域幅が一貫して70〜80%削減されることを確認しています。15〜20分かかっていたデプロイ時間が、ほとんどのイメージサイズで60秒以内に短縮されます。
セットアップのオーバーヘッドは最小限です:少数のコントロールプレーンポッドとノードごとに1つのDaemonSetポッドだけです。containerdのミラー設定がノードごとの唯一の変更点で——1つのAnsible playまたはcloud-initスニペットで全ワーカーノードに対応できます。両方の設定が完了すれば、設定した全レジストリへのイメージプルが自動的にP2Pネットワークを経由します。継続的なチューニングは不要です。
頻繁なデプロイ、大きなベースイメージ、または厳しいレジストリ帯域幅制限の中でKubernetesを大規模運用している方にとって、Dragonflyはすぐに元を取れる価値があります。