導入の背景と理由
開発チームの規模が拡大するにつれて、コードレビューの遅延は深刻化します。たとえば15人のエンジニアチームが週に40件のプルリクエスト(PR)を作成するようになると、レビュー待ちのキューはたちまち飽和状態に陥ります。
シニアエンジニアは日常的な構文エラーを差分から探すためだけに、毎週6〜8時間ものリソースを費やすことになります。その一方で、未検証のユーザー入力、流出したトークン、安全でないSQLクエリといった深刻なセキュリティバグが見逃され、ステージングブランチへ密かに混入してしまうケースが後を絶ちません。SonarQubeやSemgrepなどの従来のSAST(静的アプリケーションセキュリティテスト)ツールは典型的な構文パターンを検出できますが、偽陽性率(誤検知率)が高く(30%を超えることも珍しくありません)、開発者がアラートを軽視する原因にもなっています。
大規模言語モデル(LLM)は、静的な正規表現ルールとは比較にならないほど高度にコードの意味論、文脈ロジック、開発者の意図を理解します。しかし、クラウドホスト型のAIレビューサービスに社内のプロプライエタリなソースコードを送信することには、コンプライアンス上の大きな障壁が伴います。
SOC 2、ISO 27001、HIPAAなどのガイドラインに準拠する必要があるチームにとって、プライベートなコードベース、独自のアルゴリズム、社内APIスキーマをOpenAIやAnthropicなどのサードパーティプロバイダーに送信することは認められません。プライベートコードがいったん自社のサブネット外部に出てしまえば、監査ログやデータ保持の管理権限を失うことになります。
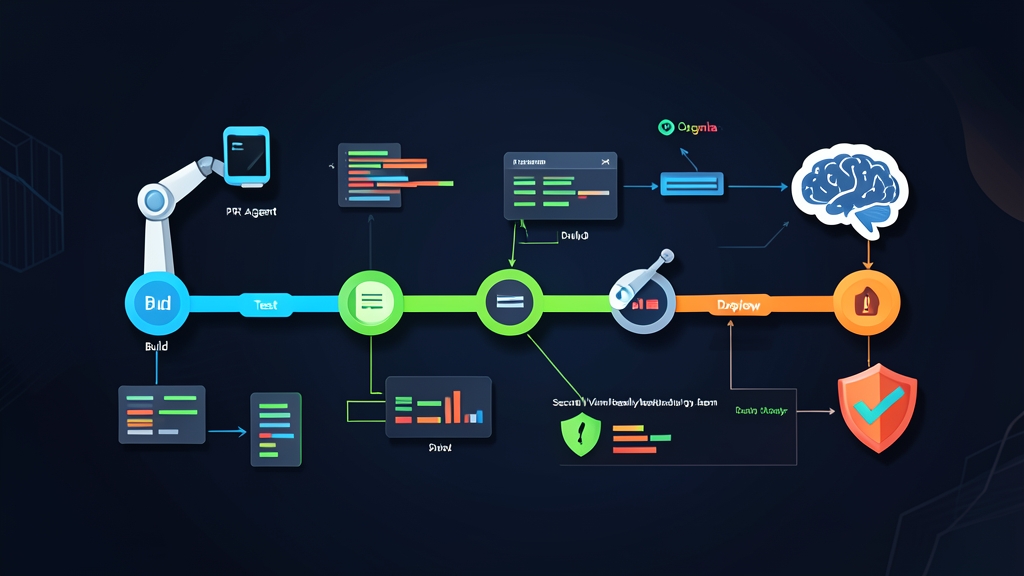
プライベートインフラの内部でレビューパイプラインを実行すれば、このジレンマを根本から解決できます。オープンソースのGitレビューエージェントであるPR-Agentと、軽量なローカルLLMランナーであるOllamaを組み合わせることで、セルフホスト型のCI/CDランナー上で自律型レビュアーを直接ホスト可能です。ソースコードが自社のVPCから外部へ流出することは一切なく、月ごとのトークン費用もゼロになります。さらに、エンジニアはPRを作成してからわずか60〜90秒以内に、文脈を考慮したセキュリティフィードバックを受け取ることができます。
社内のステージングサービスにこの構成を展開したところ、作成されたすべてのPRに対する即時のファーストレスポンダーとして機能し、人間のレビュアーがブランチを確認する前に境界値チェックの漏れやエッジケースの不備を確実に検出できています。
インストール手順
CIの待機時間を抑えてスムーズな推論を行うには、専用GPUコンピュートを備えたインスタンス上でOllamaを実行してください。NVIDIA RTX 3060(12 GB)、T4(16 GB)、またはA10であれば、1秒あたり30〜50トークンを快適に処理できます。CPUのみのベアメタルサーバーを使用せざるを得ない場合でも、量子化モデル(Q4_K_M)を使用すれば200行未満の差分を処理可能ですが、レイテンシは数秒から約2分程度まで増加します。
ステップ1:Ollamaのインストールと起動
公式スクリプトを使用して、Linuxランナー上にOllamaをインストールします:
curl -fsSL https://ollama.com/install.sh | shデフォルトでは、Ollamaデーモンは127.0.0.1:11434のみをリッスンします。PR-Agentをブリッジネットワークを使用したDockerコンテナ内で実行する場合、Ollamaがすべてのローカルインターフェースにバインドされている必要があります。以下のコマンドでsystemdサービスのオーバーライドを設定します:
sudo mkdir -p /etc/systemd/system/ollama.service.d
echo -e '[Service]\nEnvironment="OLLAMA_HOST=0.0.0.0:11434"' | sudo tee /etc/systemd/system/ollama.service.d/override.conf
sudo systemctl daemon-reload
sudo systemctl restart ollama
ステップ2:コーディングに最適化されたモデルの取得
汎用の基底モデルは、複雑なコードレビューにおいて的確な判断を下せないことがよくあります。そのため、ソフトウェアエンジニアリング向けにファインチューニングされたインストラクションチューニング済みモデルを採用します。Qwen2.5-Coder (7B)は、VRAM消費を5GB未満に抑えながら最高水準のコード推論能力を発揮します:
# 7Bパラメータモデルをダウンロード(ダウンロードサイズ:約4.7 GB)
ollama pull qwen2.5-coder:7b

# CLI経由で動作確認テストを実行
ollama run qwen2.5-coder:7b "次のコードに潜む潜在的な脆弱性を特定してください: query = f\"SELECT * FROM users WHERE id = {user_input}\""
ステップ3:PR-Agentの取得
PR-Agentは、各種Gitプロバイダーとの統合機能およびプロンプトパイプラインを含むスタンドアロンのDockerイメージとして提供されています。ランナーホスト上にイメージをプルします:
docker pull codiumai/pr-agent:latest設定方法
Ollamaはhttp://<host>:11434/v1でOpenAI互換APIを提供しています。PR-AgentのベースURLとモデル設定を上書きすることで、このローカルエンドポイントと直接通信させることが可能です。
ステップ1:PR-Agent設定ファイルの作成
リポジトリのルートまたはCIデプロイディレクトリに、.pr_agent.tomlという名前の設定ファイルを作成します:
[config]
model = "qwen2.5-coder:7b"
fallback_models = ["qwen2.5-coder:7b"]
git_provider = "github"

[openai]
api_base = "http://127.0.0.1:11434/v1"
key = "none"

[pr_reviewer]
require_score_review = false
require_tests_review = true
require_security_review = true
num_code_suggestions = 4
inline_code_comments = true

[pr_description]
publish_labels = false
add_original_user_description = true
ステップ2:セルフホストランナー上のGitHub Actionsによる自動化
.github/workflows/pr-review.ymlにGitHubワークフローファイルを作成します。Ollamaが動作しているself-hostedランナープールを指定してジョブを実行します:
name: ローカル環境での自動コードレビュー

on:
  pull_request:
    types: [opened, synchronize, reopened]

jobs:
  local-pr-agent:
    runs-on: self-hosted
    permissions:
      contents: read
      pull-requests: write
      issues: write
    steps:
      - name: コードベースのチェックアウト
        uses: actions/checkout@v4

      - name: Docker経由でPR-Agent Reviewerを実行
        env:
          OPENAI_KEY: "none"
          OPENAI_API_BASE: "http://127.0.0.1:11434/v1"
          CONFIG_MODEL: "qwen2.5-coder:7b"
          GITHUB_TOKEN: ${{ secrets.GITHUB_TOKEN }}
          github_action_config.auto_review: "true"
          github_action_config.auto_describe: "false"
          github_action_config.auto_improve: "false"
        run: |
          docker run --rm \
            --net="host" \
            -e OPENAI_KEY="$OPENAI_KEY" \
            -e OPENAI.API_BASE="$OPENAI_API_BASE" \
            -e CONFIG.MODEL="$CONFIG_MODEL" \
            -e GITHUB.USER_TOKEN="$GITHUB_TOKEN" \
            -e GITHUB.DEPLOYMENT_TYPE="app" \
            -v $(pwd)/.pr_agent.toml:/app/.pr_agent.toml \
            codiumai/pr-agent:latest \
            --pr_url="${{ github.event.pull_request.html_url }}" \
review--net="host"を使用することで、コンテナはDockerブリッジのNATを経由することなく、127.0.0.1:11434にあるOllamaと直接通信できます。Ollamaは認証を必要としないため、ダミー値の"none"を渡すことでPR-Agentクライアント側の認証要件を満たせます。
検証とモニタリング
ワークフローファイルをプッシュしたら、意図的に脆弱性を含めたプルリクエストを作成して自動化パイプラインをテストします。
ステップ1:脆弱性を含むプルリクエストでのテスト
mainブランチから作業ブランチを作成し、テスト用ファイル(例: auth.py)に安全でないクエリを記述します:
import sqlite3

def get_user_records(user_id):
    conn = sqlite3.connect("users.db")
    cursor = conn.cursor()
    # 重大な欠陥: 生の文字列フォーマットによりSQLインジェクションが発生
    query = f"SELECT * FROM accounts WHERE id = '{user_id}'"
    cursor.execute(query)
    return cursor.fetchall()
ブランチをプッシュしてPRを作成します。2分以内にランナーがGit差分を評価し、Ollamaへ問い合わせた上で、PRのディスカッションに以下のような構造化コメントを直接投稿します:
- 脆弱性の指摘:エスケープされていないSQLパラメータの直接展開に対して
get_user_recordsに警告フラグを付与。 - セキュリティチェックリスト:サニタイズされていないユーザー入力項目を「不合格」としてマーク。
- 具体的な修正コードの提示:パラメータ化されたバインディングへの修正(例:
cursor.execute("SELECT * FROM accounts WHERE id = ?", (user_id,)))を提案。
ステップ2:パフォーマンスとリソース消費状況のモニタリング
推論負荷を監視することで、CIランナーのメモリ不足(OOM)を未然に防止できます。レビューの実行中に、GPUメモリの割り当てと温度をリアルタイムで確認します:
watch -n 1 nvidia-smiアクティブなトークンスループットを確認したり、HTTP通信エラーのトラブルシューティングを行ったりする場合は、Ollamaのサービスログを直接確認します:
journalctl -u ollama -f --no-tailステップ3:大規模な差分におけるトークン制限への対処
デフォルト設定のOllamaでは、2,048トークンのコンテキストウィンドウ(num_ctx)でモデルが初期化されます。自動生成されたスキーマファイルや依存関係のロックファイルなどを含む大きな差分では、この制限によって内容が切り捨てられる恐れがあります。Qwen2.5-Coderはネイティブでより大きなコンテキスト長をサポートしているため、カスタムModelfileを定義してOllamaのアクティブウィンドウを8,192トークンに拡張できます:
FROM qwen2.5-coder:7b
PARAMETER num_ctx 8192
PARAMETER temperature 0.1なお、num_ctxを2,048から8,192に拡張すると、KVキャッシュ用に約1.5GBの追加VRAMが割り当てられる点に留意してください。以下のコマンドでカスタムバリアントを登録します:
ollama create qwen2.5-coder-8k -f ./Modelfileその後、.pr_agent.toml内の設定をmodel = "qwen2.5-coder-8k"に変更します。サンプリング温度(temperature)を0.1に下げておくことで、レビュアーの挙動が決定的(デターミニスティック)になり、ハルシネーションを抑制して純粋な機能的・セキュリティ上の欠陥のみにフォーカスした指摘を行わせることができます。
このセルフホスト型パイプラインを導入することで、すべてのコミットに対して自動化されたセキュリティスクリーニングが提供されます。機密性の高いソースコードを自社サーバー内のみに厳格に保持しながら、エンジニアリングチームはリグレッションをより早い段階で確実に検知できるようになります。