深夜2時、データベースが吹き飛んだ
スマートフォンが鳴り止まない。オンコールアラートは「本番環境がおかしい」と告げている。SSHで接続して原因を探ると、ジュニア開発者が実行したマイグレーションスクリプトが DELETE FROM orders WHERE status = 'pending' を実行していた。タイポでWHERE句が意図せず機能せず、ordersテーブルが丸ごと削除されていた。47,000行。消えた。
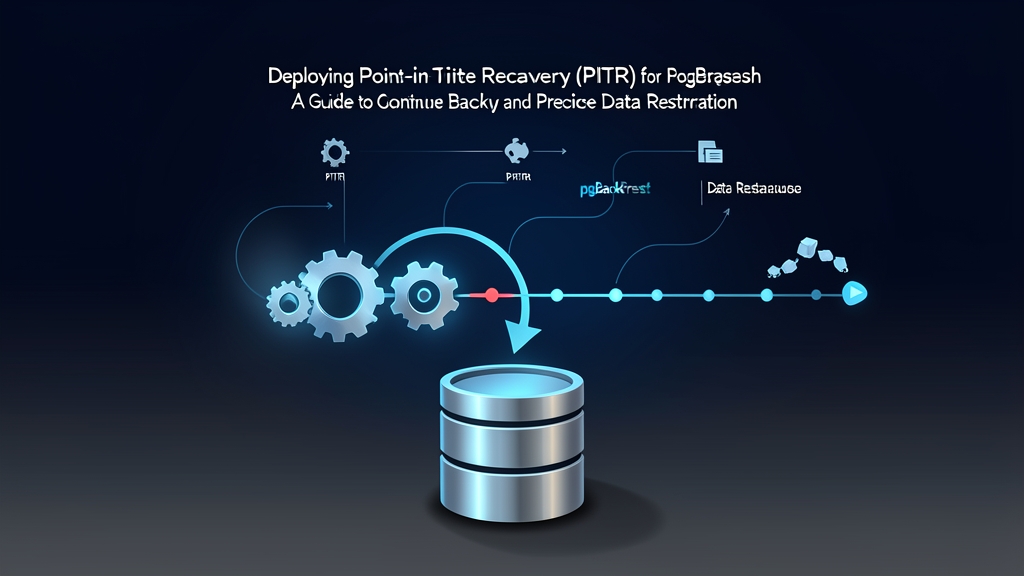
これがまさに pg_dump バックアップの限界です。最後のダンプは6時間前のもの。注文、決済、顧客データの6時間分は、従来のスナップショットからは取り戻せない。しかしpgBackRestでPoint-in-Time Recovery(PITR)を設定していれば、問題のマイグレーションが実行される1分前の状態に正確に復元して、20分でオンラインに戻れます。
インシデントが起きる前にこれを構築する方法を解説します。
なぜ pg_dump だけでは本番環境に不十分なのか
従来の pg_dump はスナップショット、つまりある瞬間のデータベースの完全なコピーを作成します。小規模なデータベースや開発環境では問題ありませんが、本番環境では2つの致命的な欠点があります:
- 高いRPO(目標復旧時点):最後のダンプからインシデントまでの全データが失われる。6時間ごとにダンプする場合、最大6時間分のデータが失われる可能性がある。
- タイムトラベル不可:ダンプが実行された瞬間にしか復元できない。「問題のクエリの5分前に戻す」ことはできない。
PITRはWAL(Write-Ahead Log)ファイルを継続的にアーカイブすることで、この両方の問題を解決します。PostgreSQLはすべての変更をデータファイルに適用する前にWALに書き込みます。これらのWALファイルを保持しておけば、任意の正確なタイムスタンプまでトランザクションを再生できます。
pgBackRestはこれを本番環境に対応した形で実現します。フル、差分、増分バックアップがすべて組み込まれており、WALアーカイブはバックグラウンドで自動的に実行されます。リストアは並列処理で動作し、シングルスレッドで25分かかる300GBのデータベースも、4ワーカーなら約8分で完了します。すべてのバックアップファイルはチェックサムで検証され、ストレージはローカルディスク、S3、Azure Blob Storageに対応しています。真剣なPostgreSQL運用のデファクトスタンダードです。
pgBackRestのセットアップ:ステップバイステップ
以下の手順はUbuntu 22.04とPostgreSQL 15を対象としています。バージョンに合わせてパスを調整してください。
pgBackRestのインストール
sudo apt-get update
sudo apt-get install pgbackrest -y
pgbackrest version
設定ファイルの作成
sudo mkdir -p /etc/pgbackrest
sudo nano /etc/pgbackrest/pgbackrest.conf
[global]
repo1-path=/var/lib/pgbackrest
repo1-retention-full=2
log-level-console=info
log-level-file=detail
[main]
pg1-path=/var/lib/postgresql/15/mainPostgreSQLでWALアーカイブを有効化する
postgresql.conf を編集します:
sudo nano /etc/postgresql/15/main/postgresql.conf以下の設定を追加または更新します:
wal_level = replica
archive_mode = on
archive_command = 'pgbackrest --stanza=main archive-push %p'
archive_timeout = 60
max_wal_senders = 3
archive_timeout = 60 の行は重要です。これがないと、WALセグメントは16MBになって初めてアーカイブされますが、トラフィックの少ないデータベースでは数時間アーカイブが発生しないことがあります。60秒に設定することで少なくとも毎分アーカイブされ、最悪の場合でもRPOが60秒になります。
sudo systemctl restart postgresqlスタンザの初期化と初回バックアップの取得
sudo -u postgres pgbackrest --stanza=main stanza-create
sudo -u postgres pgbackrest --stanza=main --type=full backup
フルバックアップが完了すると、pgBackRestが継続的にWALアーカイブを引き継ぎます。その時点からRPOはほぼゼロになります。cronで自動バックアップをスケジュールします:
# 毎日午前1時にフルバックアップ
0 1 * * * postgres pgbackrest --stanza=main --type=full backup

# 6時間ごとに差分バックアップ
0 */6 * * * postgres pgbackrest --stanza=main --type=diff backup
実際のリカバリー:特定の時刻への復元
深夜2時に重要になるのはここです。まず、問題が発生したおおよその時刻を特定します。アプリケーションログ、PostgreSQLログを確認するか、開発者にマイグレーションを実行した時刻を聞いてください。問題の削除が 2024-11-15 02:03:00 UTC に発生したとします。
PostgreSQLの停止とデータディレクトリのクリア
sudo systemctl stop postgresql
sudo -u postgres find /var/lib/postgresql/15/main -mindepth 1 -delete
インシデントの1分前への復元
sudo -u postgres pgbackrest --stanza=main restore \
  --target="2024-11-15 02:02:00+00" \
  --target-action=promote \
  --type=time
ターゲットは 02:02:00 — 問題のクエリの1分前です。この精度こそがPITRの核心です。内部的には、pgBackRestはターゲットタイムスタンプより前の最新のフルバックアップを特定し、データファイルを復元した後、カットオフに達するまでWALセグメントを一つずつ再生して停止します。
PostgreSQLの起動と確認
sudo systemctl start postgresql
sudo -u postgres psql -c "SELECT count(*) FROM orders;"
47,000行が表示されれば、会社を救ったことになります。総ダウンタイム:20分未満。
監視 — 壊れたアーカイブはアーカイブなしより悪い
アーカイブが正常であると決して思い込まず、積極的に頻繁に確認してください:
sudo -u postgres pgbackrest --stanza=main infostatus: ok を確認し、WALアーカイブのmin/maxが時間の経過とともに進んでいることを確認してください。status: error が表示されれば、PITRは静かに壊れています。
PostgreSQL自身の統計ビューも同じことを教えてくれます:
sudo -u postgres psql -c "SELECT last_archived_wal, last_failed_wal, failed_count FROM pg_stat_archiver;"failed_count が増加している場合、アーカイブコマンドが壊れているので、朝ではなく今すぐ修正する必要があります。
月に一度、ステージングサーバーを起動してフルリストアを実行してください。行数を確認し、最も重要なテーブルをスポットチェックしてください。私は一度、2週間のアーカイブギャップがあるバックアップを信頼して痛い目にあいました。権限変更が archive_command を静かに壊していたのに、何もアラートが上がらなかったのです。
知っておくべき注意点
経験から学んだいくつかの注意点:
- ディスクスペース:トラフィックの多いデータベースではWALファイルが急速に蓄積されます。
repo1-retention-archive-type=incrを設定して、リテンションポリシーに合わせて古いアーカイブを自動的にクリーンアップしましょう。 - 権限:すべてのpgBackRestコマンドは
postgresユーザーとして実行してください。rootとpostgresの所有権が混在すると、わかりにくい障害が発生します。 - 必要になる前にテストする:実際のインシデント中に初めてリストアを実行しないでください。少なくとも一度はステージングでリストアプロセスを経験しておき、深夜2時に体が自然に動くようにしておきましょう。
- データベースに取り込む前にインポートを検証する:最善のリカバリーとは必要のないリカバリーです。バルクデータのインポート前には必ずデータ構造を検証してください。CSVの場合は、Postgresに触れる前に toolcraft.app/ja/tools/data/csv-to-json に通して構造を確認しましょう(ブラウザ完結型のため、データがマシン外に出ることはありません)。この段階で不正なインポートを検出できれば、PITRリストアを実行するよりずっとましです。
完全なバックアップ戦略におけるPITRの位置づけ
Point-in-Time Recoveryは「誰かが本番データを削除した」シナリオにうまく対処します。しかしカバーしていない部分もあります:
- オフサイトストレージ:
repo1-type=s3を設定してバックアップをS3に保存してください。ディスク障害は起こるものであり、バックアップスケジュールには容赦しません。 - ストリーミングレプリケーション:ハードウェア障害からは保護されますが、論理エラーからは保護されません。誤ったDELETEはスタンバイサーバーに即座にレプリケートされます。
- 定期的な pg_dump エクスポート:移植性のために週次の論理バックアップを保持してください。スキーママイグレーションでは、ファイルレベルのリストアではなくクリーンなダンプが必要な場合があります。
pgBackRest PITR、ストリーミングレプリケーション、週次 pg_dump エクスポートの3つを重ねることで、本番環境で起こりうるほぼすべての障害モードに対応できます。各レイヤーが他のレイヤーでカバーできない部分を補います。
必要になる前に動かしておいてください。少なくとも一度はステージングでフルリストアを経験しておき、実際に深夜2時で半分眠りながらでも、コマンドが体に染み付いているようにしておきましょう。プレッシャーの中でGoogle検索するようでは遅すぎます。