ネットワーク監視:適切なテレメトリの選定
高速ネットワークの監視には、エンジニアリングにおけるシビアなトレードオフが伴います。エッジルーターが数十Gbpsのトラフィックを処理している場合、全パケットをキャプチャしようとすると即座にストレージ容量が逼迫します。一方で、単なるインターフェースのトラフィックグラフだけでは、障害発生時の重要な詳細を見落としてしまいます。インフラチームは通常、以下の3つのアプローチを比較検討します。
- フルパケットインスペクション(Raw PCAP):
tcpdumpやZeekなどのツールを用いて、ペイロード、プロトコルヘッダー、TCP制御フラグを含むフレーム全体をキャプチャします。詳細度は群を抜いていますが、70%の負荷がかかった単一の10 Gbpsリンクでは、24時間で約75 TBもの非圧縮PCAPデータが生成されます。この規模の生PCAPを保存・解析するには、専用のキャプチャアプライアンスと大容量NVMeアレイが必要となり、数週間にわたるデータ保持はコスト面から現実的ではありません。 - SNMPポーリング:1〜5分ごとにインターフェースのカウンターをポーリングすることで、基本的な回線使用率を把握できます。軽量で設定も容易ですが、SNMPは完全なブラックボックスです。例えば午前2時にアップリンクの使用率が突如98%に達したとしても、SNMPだけではどの内部IP、リモートホスト、またはアプリケーションプロトコルが急増の原因となったかを特定できません。
- フローアカウンティング(NetFlow、sFlow、IPFIX):エッジルーターやスイッチが、各接続を要約したコンパクトなメタデータレコードをエクスポートします。これらのレコードは、送信元・宛先IP、ポート番号、プロトコルフラグ、パケット数、バイト数を追跡します。フローアカウンティングは、フルPCAPと比較してデータフットプリントを99%以上削減します。同じ10 Gbpsリンクでも、1日あたり約1 GB〜2 GBの構造化フローデータに圧縮されるため、ストレージコストを抑えながら高い可視性を確保できます。
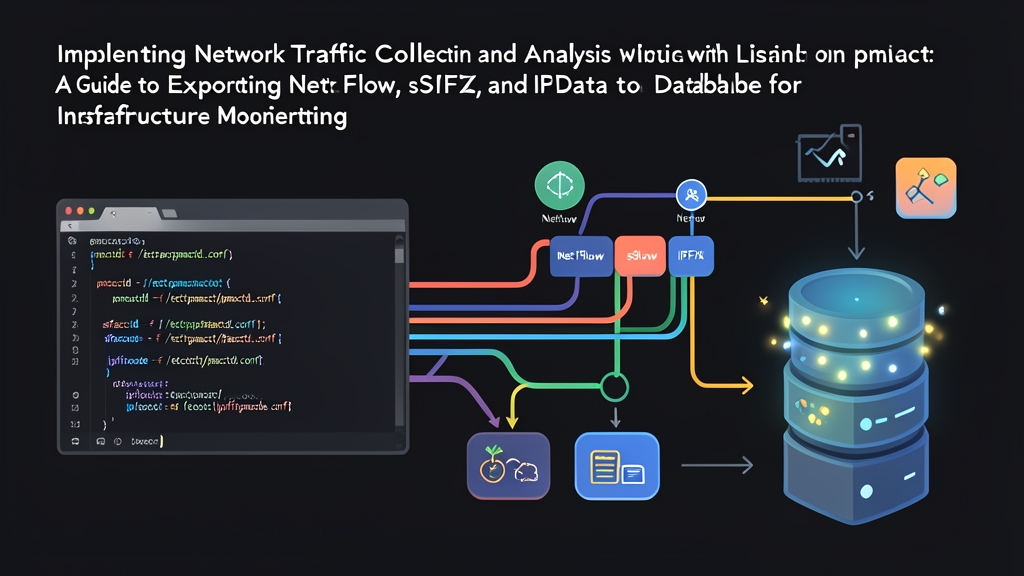
オープンソースのpmacctツールセットは、Linux上でのフロー収集における課題を解決します。NetFlowおよびIPFIX用のnfacctd、sFlow用のsfacctd、生インターフェース用のpmacctdといった特化型デーモンを中心に構成され、受信したUDPデータグラムを取り込み、メモリ内でフローを集約した上で、PostgreSQL、ClickHouse、Kafkaなどに構造化レコードを直接書き込みます。
アーキテクチャのトレードオフ:pmacctの適用領域
pmacctを本番環境に導入する前に、そのアーキテクチャ上の強みと運用上の制限事項を比較検討してください。
メリット
- プロトコルの柔軟性:従来のCisco CatalystからのレガシーなNetFlow v5をはじめ、NetFlow v9、最新のJunosやVyOSルーターからのIPFIX、AristaスイッチからのサンプリングされたsFlow v5フレームの取り込みに対応しています。
- メモリ内集約:高トラフィックのバックボーンでは、毎秒10万件もの生フローエクスポートが容易に発生します。各レコードを直接SQLに挿入すると、書き込み増幅によりデータベースが過負荷に陥ります。pmacctは設定可能な集約ウィンドウ(例:5分間)の間、内部キャッシュで一致するフローをまとめ、事前集約されたサマリーのみをデータベースにフラッシュします。
- 直接的なデータベース連携:セカンダリのログ転送ツールやカスタムのPython連携スクリプトを用意する必要はありません。ネイティブのC言語プラグインにより、PostgreSQL、MySQL、ClickHouse、SQLite、Apache Kafkaへ直接レコードをストリーミングできます。
- BGP情報の付加:上流のトランジットルーターと読み取り専用のBGPピアリングセッションを確立することで、
nfacctdはパケット受信時にライブのASパスやBGPコミュニティ情報をフローレコードへ直接マッピングできます。
制限事項
- ペイロードの可視性がない:フローはレイヤー3およびレイヤー4のメタデータのみを追跡します。HTTPリクエストボディ、TLSハンドシェイクパラメータ、生のDNSクエリ文字列などを検査することはできません。
- サンプリングによる死角:40 Gbpsや100 Gbpsのバックボーンでは、スイッチ側で1:1,000または1:4,096のハードウェアパケットサンプリングが頻繁に用いられます。統計的な正規化を考慮しない限り、短時間の単一パケットプローブや数ミリ秒しか続かないマイクロバーストを検知できない場合があります。
- テーブルサイズの肥大化:数百のサブネットにわたって5分間隔で集約しても、PostgreSQLのようなリレーショナルデータベースには週に数百万行が蓄積されます。インデックスのメンテナンスやパーティションのプルーニングに関する運用設計が不可欠です。
推奨アーキテクチャ
実運用に耐えうるフローパイプラインには、急激なトラフィックバースト時にもUDPデータグラムを取りこぼさない堅牢性が求められます。以下の構成は、複数のエッジデバイスにまたがる最大50 Gbpsの監視トラフィックを安定して処理できます。
- コレクター:Ubuntu 22.04/24.04 LTS上で動作する
nfacctd。UDPポート2055でNetFlow v9およびIPFIXトラフィックをリスンします。 - ストレージエンジン:日次テーブルパーティショニングを適用したPostgreSQL 15または16。パーティショニングによりB-Treeインデックスの肥大化を防ぎ、負荷の高い
DELETE処理を行わずにDROP TABLEを用いて不要になった古いデータをミリ秒単位で削除できます。 - 集約インターバル:300秒(5分)。フォレンジック調査に耐えうる解像度を維持しつつ、データベースへの挿入レートを適切に抑えるバランスの取れた設定です。
- データ保持ポリシー:
pg_partmanによる自動テーブルローテーションを実施し、ディスク容量保護のため30〜60日以上経過したパーティションを自動削除します。
ステップ・バイ・ステップ導入手順:nfacctdからPostgreSQLへ
以下の手順では、ネットワーク機器からフローテレメトリを収集し、集約テーブルをローカルのPostgreSQLインスタンスへフラッシュするようにnfacctdを設定します。
ステップ 1:必要なパッケージのインストール
Ubuntuの公式リポジトリから、PostgreSQL、データベース開発ライブラリ、およびpmacctスイートをインストールします。Ubuntu標準パッケージには、PostgreSQL動的バックエンドプラグインが組み込まれています。
sudo apt update
sudo apt install -y pmacct postgresql postgresql-contrib
バイナリが正常に動作するか確認し、組み込まれているプラグインをチェックします:
nfacctd -V
sudo systemctl status postgresql --no-pager
ステップ 2:LinuxのUDPソケットバッファのチューニング
フロー収集デーモンは、急激にバーストするUDPデータグラムを処理します。Linuxのネットワークスタックでソケットバッファ領域が不足すると、カーネルは受信フローを警告なしにドロップします。デーモンを起動する前に、最大受信バッファサイズを引き上げておきます:
sudo sysctl -w net.core.rmem_max=33554432
sudo sysctl -w net.core.rmem_default=8388608
echo "net.core.rmem_max=33554432" | sudo tee -a /etc/sysctl.d/99-pmacct.conf
echo "net.core.rmem_default=8388608" | sudo tee -a /etc/sysctl.d/99-pmacct.conf
ステップ 3:PostgreSQLデータベースとスキーマの作成
pmacct専用のPostgreSQLユーザーとデータベースを作成します。ここでは、送信元、宛先、レイヤー4ポート、プロトコル、総バイト数、タイムスタンプを記録するテーブルを作成します。
sudo -u postgres psqlpsqlプロンプト内で以下のSQL文を実行します:
CREATE USER pmacct WITH PASSWORD 'StrongPmacctSecretKey';
CREATE DATABASE pmacct_db OWNER pmacct;
\c pmacct_db pmacct;

CREATE TABLE acct_v9 (
    agent_id VARCHAR(16) NOT NULL DEFAULT '0',
    as_src INT NOT NULL DEFAULT 0,
    as_dst INT NOT NULL DEFAULT 0,
    ip_src INET NOT NULL,
    ip_dst INET NOT NULL,
    src_port INT NOT NULL DEFAULT 0,
    dst_port INT NOT NULL DEFAULT 0,
    ip_proto SMALLINT NOT NULL DEFAULT 0,
    packets BIGINT NOT NULL,
    bytes BIGINT NOT NULL,
    stamp_inserted TIMESTAMP WITHOUT TIME ZONE NOT NULL DEFAULT NOW(),
    stamp_updated TIMESTAMP WITHOUT TIME ZONE DEFAULT NULL,
    PRIMARY KEY (agent_id, ip_src, ip_dst, src_port, dst_port, ip_proto, stamp_inserted)
);

CREATE INDEX idx_acct_v9_stamps ON acct_v9 (stamp_inserted);
CREATE INDEX idx_acct_v9_dst_lookup ON acct_v9 (ip_dst, stamp_inserted);
\q
ステップ 4:nfacctdの設定
コレクターの設定ファイルを/etc/pmacct/nfacctd.confに作成します。この設定ではポート2055にバインドし、受信接続を5分ごとの集約バケットにキャッシュした上で、一括COPY処理によって完成したブロックをPostgreSQLへストリーミングします。
sudo mkdir -p /etc/pmacct
sudo nano /etc/pmacct/nfacctd.conf
以下の設定を保存します:
! /etc/pmacct/nfacctd.conf - フローアカウンティングデーモンの設定

! プロセス制御
daemonize: false
pidfile: /run/nfacctd.pid
syslog: daemon

! ソケットおよびバッファ設定
nfacctd_ip: 0.0.0.0
nfacctd_port: 2055
nfacctd_time_new: true
plugin_buffer_size: 10240
plugin_pipe_size: 10240000

! 出力バックエンド
plugins: pgsql[traffic_in]

! 集約プリミティブ:アクティブなフローを以下のディメンションでグループ化
aggregate[traffic_in]: src_host, dst_host, src_port, dst_port, proto

! データベース接続パラメータ
sql_db[traffic_in]: pmacct_db
sql_table[traffic_in]: acct_v9
sql_user[traffic_in]: pmacct
sql_passwd[traffic_in]: StrongPmacctSecretKey
sql_host[traffic_in]: 127.0.0.1

! タイミングおよび一括書き込みパフォーマンス設定
sql_refresh_time[traffic_in]: 300
sql_history[traffic_in]: 5m
sql_history_roundoff[traffic_in]: m
sql_dont_try_update[traffic_in]: true
sql_use_copy[traffic_in]: true
sql_use_copy: trueを指定することで、pmacctは個別のINSERT文を発行する代わりに、PostgreSQLのバイナリバルクコピー(COPY)インターフェースを使用して行をバッチ処理します。これによりディスクI/Oが削減され、トラフィック急増時でもインジェスチョン遅延を20ミリ秒未満に抑えることができます。
ステップ 5:Systemdサービスの作成
カーネルの再起動やシステムクラッシュ時にもコレクターが自動復旧するように、nfacctdをsystemdサービスユニットとして設定します。
sudo nano /etc/systemd/system/nfacctd.service以下のユニット定義を記述します:
[Unit]
Description=pmacct NetFlow/IPFIX コレクター
After=network.target postgresql.service
Wants=postgresql.service

[Service]
Type=simple
ExecStart=/usr/sbin/nfacctd -f /etc/pmacct/nfacctd.conf
Restart=always
RestartSec=5s
LimitNOFILE=65536

[Install]
WantedBy=multi-user.target
systemdマネージャーをリロードし、サービスを有効化して起動後、稼働状況を確認します:
sudo systemctl daemon-reload
sudo systemctl enable --now nfacctd
sudo systemctl status nfacctd
コレクターがUDPポート2055でリッスンしていることを確認します:
sudo ss -ulnp 'sport = :2055'ステップ 6:トラフィックデータのクエリと分析
境界ルーターやスイッチを設定し、LinuxコレクターのIPアドレス宛てにUDP 2055番ポートでフローをエクスポートさせます。最初のキャッシュバケットが蓄積されてフラッシュされるまで5分間待ちます。その後、PostgreSQLシェルを起動してトラフィック傾向を分析します:
psql -U pmacct -d pmacct_db -h 127.0.0.1過去60分間で最も受信トラフィック量の多かった上位5件の内部ホストを特定します:
SELECT
    ip_dst AS destination_ip,
    CASE ip_proto
        WHEN 6 THEN 'TCP'
        WHEN 17 THEN 'UDP'
        WHEN 1 THEN 'ICMP'
        ELSE 'その他'
    END AS protocol,
    SUM(packets) AS total_packets,
    ROUND(SUM(bytes)::numeric / (1024 * 1024), 2) AS total_mb
FROM
    acct_v9
WHERE
    stamp_inserted > NOW() - INTERVAL '1 hour'
GROUP BY
    ip_dst, ip_proto
ORDER BY
    total_mb DESC
LIMIT 5;
同じ時間枠内で最もスループットを消費している宛先サービスポートを特定します:
SELECT
    dst_port,
    CASE ip_proto
        WHEN 6 THEN 'TCP'
        WHEN 17 THEN 'UDP'
        ELSE 'その他'
    END AS transport,
    ROUND(SUM(bytes)::numeric / (1024 * 1024), 2) AS mb_consumed
FROM
    acct_v9
WHERE
    stamp_inserted > NOW() - INTERVAL '1 hour'
GROUP BY
    dst_port, ip_proto
ORDER BY
    mb_consumed DESC
LIMIT 10;これで、Linuxホストが高パフォーマンスなフローコレクターとして機能するようになりました。ここから公式PostgreSQLデータソースを用いてGrafanaと連携させることで、帯域幅トレンドのリアルタイム可視化、DDoS攻撃の早期検知、インフラ全体のアップリンクキャパシティ予測などを実現できます。