クイックスタート: 5分で立ち上げる環境構築
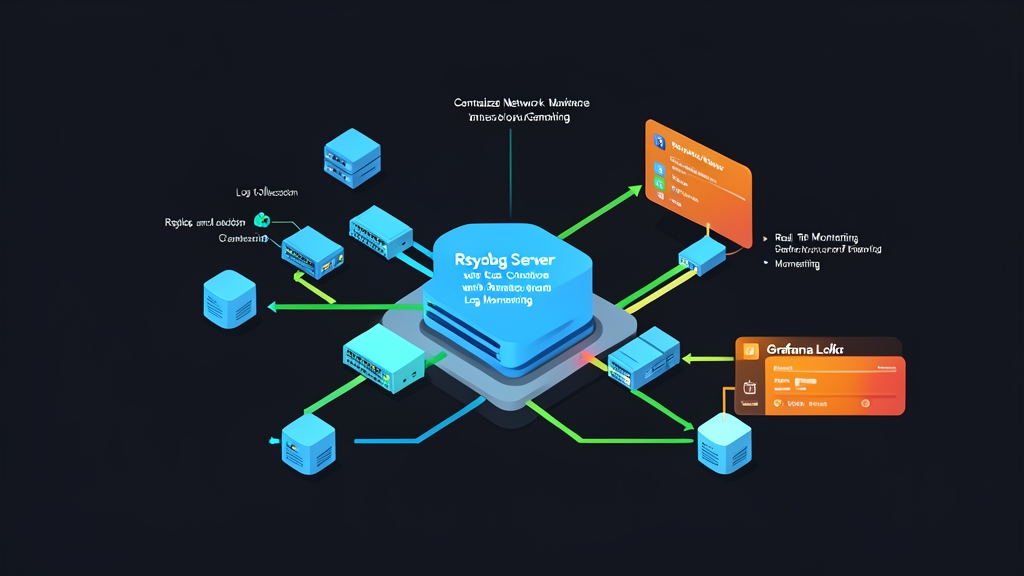
半年前、私たちのインフラチームは、検索インデックスをウォーム状態に保つだけで48GBものRAMを消費していた3ノードのElasticsearchクラスターを廃止しました。その代替として導入したのがGrafana LokiとRsyslogです。この新しい構成では、Cisco Catalyst 9300スイッチ、FortiGate 200Fクラスター、MikroTik CCRエッジルーターなど120台のネットワーク機器から届く毎秒約8,500件のsyslogイベントを処理しながら、メモリ消費量を4GB未満に抑えています。
Docker Composeを使用すれば、Ubuntu 22.04または24.04 LTS上で同様のログ収集パイプラインを数分で立ち上げることができます。
ステップ1: LokiとGrafanaのデプロイ
まず、network-loggingという名前のプロジェクトディレクトリを作成し、以下のdocker-compose.ymlファイルを保存します:
version: "3.8"

services:
  loki:
    image: grafana/loki:2.9.4
    container_name: loki
    ports:
      - "3100:3100"
    command: -config.file=/etc/loki/local-config.yaml
    volumes:
      - ./loki-data:/loki
    restart: unless-stopped

  promtail:
    image: grafana/promtail:2.9.4
    container_name: promtail
    volumes:
      - /var/log/network:/var/log/network:ro
      - ./promtail-config.yaml:/etc/promtail/config.yaml:ro
    command: -config.file=/etc/promtail/config.yaml
    restart: unless-stopped

  grafana:
    image: grafana/grafana:10.4.1
    container_name: grafana
    ports:
      - "3000:3000"
    environment:
      - GF_SECURITY_ADMIN_PASSWORD=adminpass
    restart: unless-stopped
ステップ2: RsyslogをUDP/TCPポート514にバインドする
次に、受信するネットワークトラフィックを受け取れるようホスト側のRsyslogを設定します。/etc/rsyslog.d/10-network-input.confという設定ファイルを新規作成し、以下の設定を記述します:
module(load="imudp")
input(type="imudp" port="514")

module(load="imtcp")
input(type="imtcp" port="514")

# ホストIPごとに受信ログを分割保存: /var/log/network/<DEVICE_IP>/syslog.log
template(name="NetLogPath" type="string" string="/var/log/network/%fromhost-ip%/syslog.log")
*.* ?NetLogPath
& stop
ディレクトリのパーミッションを準備し、サービスを再起動します:
sudo mkdir -p /var/log/network
sudo chmod -R 755 /var/log/network
sudo systemctl restart rsyslog
ステップ3: PromtailでSyslogファイルを監視する
Promtailは、ディスク上の未加工ログファイルを追跡(tail)し、メタデータラベルを付与して、圧縮バッチとしてLokiへ送信します。プロジェクトディレクトリにpromtail-config.yamlとして以下を保存します:
server:
  http_listen_port: 9080
  grpc_listen_port: 0

positions:
  filename: /tmp/positions.yaml

clients:
  - url: http://loki:3100/loki/api/v1/push

scrape_configs:
  - job_name: network_syslog
    static_configs:
      - targets:
          - localhost
        labels:
          job: network_devices
          __path__: /var/log/network/*/*.log
    pipeline_stages:
      - regex:
          expression: '^/var/log/network/(?P<device_ip>[^/]+)/.*\.log$'
          source: filename
      - labels:
          device_ip: ""
コンテナを起動します:
docker compose up -d
ブラウザでhttp://<your-server-ip>:3000にアクセスしてGrafanaを開きます。admin / adminpassでログインし、データソースとしてLoki(http://loki:3100)を追加したら、{job="network_devices"}でログストリームのクエリを実行できます。
詳細解説: アーキテクチャとパイプラインの仕組み
ElasticsearchやOpenSearchのような従来のツールは、受信したテキスト文字列を転置インデックス(Inverted Index)にパースして格納します。これは自由形式の検索クエリには適していますが、インターネット全体を対象としたスキャン攻撃などで、ノイズの多いファイアウォールから毎秒4万件ものドロップイベントが吐き出されるような環境では急速に破綻します。RAM使用率が高騰し、ディスクI/Oが激しく消耗し、クラスターのメンテナンスが専任業務と化してしまうのです。
なぜフロントゲートにRsyslogを採用するのか?
RsyslogはC言語で記述されており、カーネル空間に近いユーザー空間で動作します。そのため、LogstashやVectorのようなJavaやGoベースのコレクターよりも、高頻度なUDPパケットをはるかに効率的に取り込むことができます。仮にアクセススイッチが激しくリンクフラッピングを起こし始めても、Rsyslogはインメモリのリングバッファにログ行を保持し、CPUコアを圧迫することなく処理を継続します。
Lokiの設計思想: テキストではなくラベルをインデックス化する
Lokiは標準的なインデックス作成モデルを根本から覆しています。ログ本文には手を加えず、チャンク単位でgzip圧縮してディスクやS3互換ストレージに直接書き込みます。インデックス化されるのは、job、device_ip、environmentといったストリームのメタデータラベルのみです。
この設計アプローチにより、月間のストレージ使用量を1.2TBから約140GBにまで削減できました。Grafanaがチャンク境界をまたいでgrepのような並列フィルタリングを実行するため、クエリの実行速度も高速に維持されます。
ネットワーク機器の設定手順
ポート514経由でUbuntuホストへイベントを転送するように各ネットワーク機器を設定します:
# Cisco IOS / IOS-XE
logging host 192.168.10.50 transport udp port 514
logging trap informational
logging facility local6
logging source-interface GigabitEthernet0/0

# Fortinet FortiGate (CLI)
config log syslogd setting
    set status enable
    set server "192.168.10.50"
    set mode udp
    set port 514
    set facility local7
    set format default
end

# MikroTik RouterOS v7
/system logging action add name=central-syslog target=remote remote=192.168.10.50 remote-port=514 src-address=192.168.10.1
/system logging add action=central-syslog topics=critical,error,warning,info
高度な活用法: LogQLによるパースとアラート通知
Grafana内で必要に応じてパースやフィルタリングを行うことで、生のテキストストリームは強力な情報源に変化します。
読み取り時のフィールド抽出
Ciscoのsyslogメッセージは%FACILITY-SEVERITY-MNEMONIC: Descriptionという規則的なフォーマットに従っています。事前にスキーマ定義を用意しなくても、LogQLのパターンマッチングを使えばクエリ実行時にフィールドをパースできます:
{device_ip="192.168.10.1"}
  |= "%LINK-3-UPDOWN:"
  | pattern "<_> %LINK-3-UPDOWN: Interface <interface>, changed state to <status>"
このクエリは、interfaceフィールドとstatusフィールドを動的に抽出します。これらをGrafanaのテーブルパネルに直接バインドすることで、キャンパスコア全体で発生しているポートのフラッピングを迅速に特定できます。
生ログからのメトリクスストリーム生成
生のログを集計して、Prometheusスタイルの時系列データを作成することも可能です:
sum by (device_ip) (
  rate({job="network_devices"} |= "action=deny" [1m])
)
これにより、デバイスごとの毎秒ファイアウォールパケット破棄数が算出されます。突発的なスパイクを検知すれば、内部マルウェアによるスキャンや境界部への総当たり攻撃を数秒以内に検知できます。
リアルタイムアラートルールの設定
Lokiの設定にアラートルールを追加することで、ルーティングの切断を即座に検知できます:
groups:
  - name: network-alerts
    rules:
      - alert: BGPNeighborDown
        expr: |
          count_over_time({job="network_devices"} |= "%BGP-5-ADJCHANGE:" |= "Down" [2m]) > 0
        for: 0m
        labels:
          severity: critical
        annotations:
          summary: "{{ $labels.device_ip }} 上でBGPピアセッションが切断されました"
実践的アドバイス: 堅牢化と本番環境チューニング
このパイプラインを本番運用する中で、早期に対処しておくべき3つのボトルネックが判明しました。
1. 高カーディナリティなラベルを避ける
リモートクライアントIP、MACアドレス、TCPポート番号のような動的な値をPromtailのラベルとして抽出してはいけません。Lokiはユニークなラベルの組み合わせごとに個別のインデックスストリームを生成します。1万件の一意なクライアントIPが存在すると瞬時に1万本のストリームが作成され、Lokiのインデックスが肥大化して検索パフォーマンスが著しく低下します。ラベルにはsite、role、device_ipのようなカーディナリティの低い値のみを使用してください。
2. RsyslogのUDPソケットバッファを調整する
突発的なトラフィックバーストが発生すると、OSの受信バッファが飽和し、Linuxカーネルは受信UDPデータグラムを警告なしにドロップします。以下のコマンドでドロップ数を確認できます:
netstat -su | grep "receive errors"
このカウンターが増加している場合は、/etc/sysctl.d/99-syslog.confでカーネルの受信バッファを25MBに引き上げます:
net.core.rmem_default = 26214400
net.core.rmem_max = 26214400
再起動せずにsysctlの設定値を反映させます:
sudo systemctl -p /etc/sysctl.d/99-syslog.conf
3. コンパクターによるログ保持期間(Retention)の強制適用
ネットワーク機器は膨大な量の稼働ログを出力します。ストレージを保護するために、loki-config.yamlで明示的な保持期間を設定し、古いチャンクを自動削除するように構成します:
compactor:
  working_directory: /loki/compactor
  compactor_ring:
    kvstore:
      store: inmemory
  retention_enabled: true

schema_config:
  configs:
    - from: 2024-01-01
      store: tsdb
      object_store: filesystem
      schema: v13
      index:
        prefix: index_
        period: 24h

limits_config:
  retention_period: 30d
これにより、コンプライアンス要件を満たす30日分の検索可能な監査ログを維持しながら、NVMeディスクの使用量を一定範囲内に抑えることができます。