Giám sát mạng: Lựa chọn giải pháp đo kiểm phù hợp
Giám sát các mạng tốc độ cao đòi hỏi những đánh đổi kỹ thuật không hề đơn giản. Nếu router biên của bạn xử lý hàng chục gigabit mỗi giây, việc lưu lại từng gói tin sẽ nhanh chóng làm tràn ngập ổ đĩa. Ngược lại, các biểu đồ giao diện đơn thuần lại bỏ sót những chi tiết quan trọng khi xảy ra sự cố. Các đội ngũ hạ tầng thường cân nhắc giữa ba phương pháp sau:
- Phân tích toàn bộ gói tin (Raw PCAP): Các công cụ như
tcpdumpvà Zeek bắt toàn bộ khung truyền (frame), bao gồm payload, header của giao thức và các cờ điều khiển TCP. Độ chi tiết của phương pháp này là vượt trội nhất. Tuy nhiên, một đường truyền 10 Gbps hoạt động ở mức 70% tải sẽ tạo ra khoảng 75 TB dữ liệu PCAP không nén mỗi 24 giờ. Việc lưu trữ và phân tích dung lượng PCAP thô khổng lồ đó đòi hỏi các thiết bị chuyên dụng và mảng ổ cứng NVMe đắt đỏ, khiến việc lưu trữ dữ liệu trong nhiều tuần trở nên bất khả thi về mặt chi phí. - Thu thập dữ liệu qua SNMP (SNMP Polling): Định kỳ truy vấn các bộ đếm trên interface mỗi 1 đến 5 phút sẽ cung cấp cho bạn thông số cơ bản về mức độ bão hòa đường truyền. Phương pháp này nhẹ và dễ cấu hình. Thế nhưng SNMP lại hoàn toàn là một “hộp đen”. Nếu một đường uplink đột ngột chạm ngưỡng 98% dung lượng lúc 2 giờ sáng, SNMP không thể cho bạn biết địa chỉ IP nội bộ, máy chủ từ xa hay giao thức ứng dụng nào đã gây ra sự tăng đột biến đó.
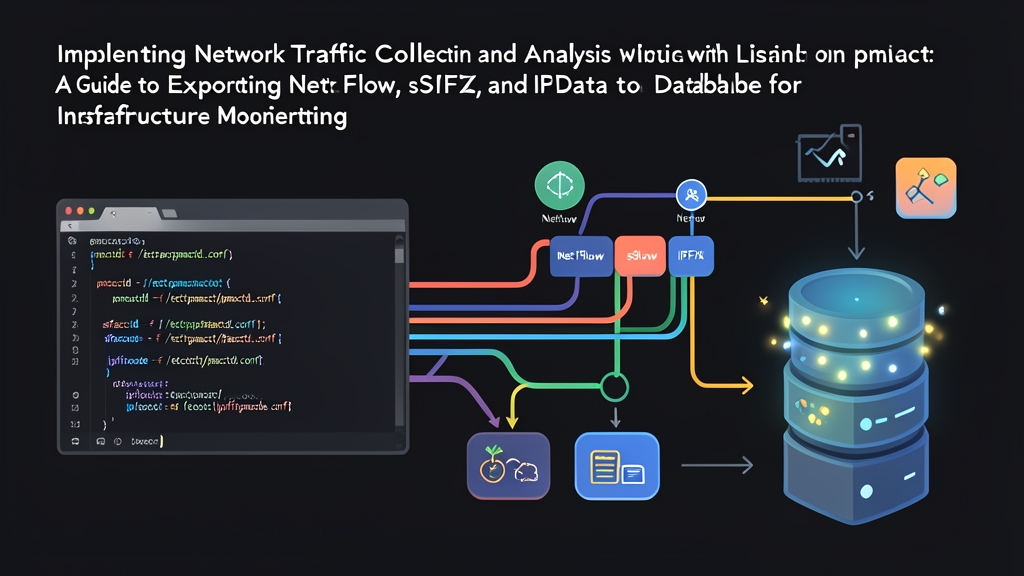
- Kế toán luồng lưu lượng (NetFlow, sFlow, IPFIX): Các router biên và switch xuất ra các bản ghi metadata thu gọn tóm tắt từng kết nối. Các bản ghi này theo dõi IP nguồn, IP đích, cổng mạng, cờ giao thức, số lượng gói tin và tổng số byte. Kế toán luồng cắt giảm hơn 99% dung lượng dữ liệu so với full PCAP. Cùng một đường truyền 10 Gbps đó chỉ còn nén lại khoảng 1 GB đến 2 GB dữ liệu luồng có cấu trúc mỗi ngày, mang lại khả năng hiển thị chi tiết mà không gây gánh nặng lưu trữ.
Bộ công cụ mã nguồn mở pmacct giải quyết bài toán thu thập này trên Linux. Được xây dựng xoay quanh các daemon chuyên biệt—nfacctd cho NetFlow và IPFIX, sfacctd cho sFlow, và pmacctd cho các interface mạng thô—công cụ tiếp nhận các gói tin UDP datagram gửi đến, tổng hợp luồng trong bộ nhớ và ghi trực tiếp các bản ghi có cấu trúc vào PostgreSQL, ClickHouse hoặc Kafka.
Đánh đổi kiến trúc: Khi nào nên dùng pmacct
Trước khi đưa pmacct vào môi trường production, hãy cân nhắc điểm mạnh về mặt kiến trúc cùng các giới hạn vận hành của nó:
Ưu điểm
- Linh hoạt về giao thức: Bộ công cụ này hỗ trợ cả NetFlow v5 truyền thống từ các dòng Cisco Catalyst cũ, NetFlow v9, IPFIX từ các router Junos và VyOS hiện đại, cũng như các khung sFlow v5 dạng lấy mẫu từ switch Arista.
- Tổng hợp dữ liệu trong bộ nhớ: Các đường trục có lưu lượng lớn dễ dàng tạo ra 100.000 bản ghi flow thô mỗi giây. Nếu ghi trực tiếp từng bản ghi vào SQL, cơ sở dữ liệu của bạn sẽ bị nghẽn do hiện tượng khuếch đại ghi (write amplification). pmacct gom nhóm các luồng khớp nhau trong bộ nhớ đệm nội bộ theo một khoảng thời gian tổng hợp có thể cấu hình (chẳng hạn 5 phút), và chỉ đẩy các bản tóm tắt đã được tổng hợp sẵn vào cơ sở dữ liệu.
- Hỗ trợ cơ sở dữ liệu trực tiếp: Bạn không cần các bộ chuyển tiếp log phụ trợ hay các script Python trung gian. Các plugin C gốc truyền dữ liệu trực tiếp vào PostgreSQL, MySQL, ClickHouse, SQLite và Apache Kafka.
- Làm giàu dữ liệu với BGP (BGP Enrichment): Bằng cách thiết lập phiên BGP peering ở chế độ chỉ đọc với router transit upstream,
nfacctdsẽ ánh xạ trực tiếp AS-path và BGP community thực tế vào các bản ghi flow ngay khi gói tin vừa đến.
Hạn chế
- Không quan sát được Payload: Dữ liệu luồng chỉ theo dõi metadata ở layer 3 và layer 4. Bạn không thể kiểm tra nội dung HTTP request body, các tham số bắt tay TLS hay chuỗi truy vấn DNS thô.
- Điểm mù do lấy mẫu (Sampling Blindspots): Trên các đường trục 40 Gbps và 100 Gbps, switch thường dùng cơ chế lấy mẫu phần cứng với tỷ lệ 1:1.000 hoặc 1:4.096. Các đợt thăm dò ngắn bằng một gói tin duy nhất hay những đợt tăng vọt lưu lượng chỉ kéo dài vài mili-giây có thể bị lọt lưới, trừ khi đội ngũ của bạn áp dụng phương pháp chuẩn hóa thống kê.
- Tốc độ tăng trưởng bảng dữ liệu: Với chu kỳ 5 phút trên hàng trăm subnet, một cơ sở dữ liệu quan hệ như PostgreSQL vẫn tiếp nhận hàng triệu hàng mỗi tuần. Bạn cần phải dành thời gian bảo trì index và dọn dẹp các phân vùng cũ (partition pruning).
Kiến trúc khuyến nghị
Một pipeline xử lý luồng mạng hoàn chỉnh cần chịu được các đợt bùng nổ lưu lượng bất ngờ mà không làm rơi các UDP datagram. Mô hình sau đây có thể xử lý lưu lượng giám sát lên tới 50 Gbps trên nhiều thiết bị biên:
- Bộ thu thập (Collector):
nfacctdchạy trên Ubuntu 22.04/24.04 LTS, lắng nghe lưu lượng NetFlow v9 và IPFIX trên cổng UDP 2055. - Engine lưu trữ: PostgreSQL 15 hoặc 16 có phân vùng bảng (partitioning) theo ngày. Phân vùng giúp tránh phình to chỉ mục B-tree và cho phép xóa dữ liệu cũ chỉ trong vài mili-giây bằng lệnh
DROP TABLEthay vì các lệnh quétDELETEnặng nề. - Khoảng thời gian tổng hợp: 300 giây (5 phút). Mức này vừa đảm bảo độ phân giải chi tiết phục vụ điều tra sự cố, vừa kiểm soát được tần suất ghi vào cơ sở dữ liệu.
- Chính sách lưu giữ dữ liệu: Tự động xoay vòng bảng bằng
pg_partman, dọn dẹp các phân vùng cũ hơn 30 đến 60 ngày để bảo toàn dung lượng ổ đĩa.
Các bước triển khai chi tiết: nfacctd sang PostgreSQL
Hướng dẫn sau đây sẽ cấu hình nfacctd để thu thập dữ liệu đo kiểm luồng từ thiết bị mạng và ghi các bảng đã tổng hợp vào cơ sở dữ liệu PostgreSQL cục bộ.
Bước 1: Cài đặt các gói cần thiết
Cài đặt PostgreSQL, các thư viện phát triển của cơ sở dữ liệu và bộ công cụ pmacct từ kho phần mềm chính thức của Ubuntu. Bản phân phối Ubuntu mặc định đã được biên dịch sẵn plugin backend động cho PostgreSQL.
sudo apt update
sudo apt install -y pmacct postgresql postgresql-contrib
Kiểm tra xem file thực thi có chạy ổn định không và kiểm tra danh sách các plugin đã được biên dịch kèm:
nfacctd -V
sudo systemctl status postgresql --no-pager
Bước 2: Tối ưu bộ đệm UDP Socket trên Linux
Các daemon thu thập luồng phải xử lý những đợt UDP datagram dồn dập với cường độ rất lớn. Nếu network stack của Linux cạn kiệt dung lượng bộ đệm socket, kernel sẽ âm thầm đánh rơi các gói luồng gửi đến. Hãy tăng kích thước bộ đệm nhận tối đa trước khi khởi chạy daemon:
sudo sysctl -w net.core.rmem_max=33554432
sudo sysctl -w net.core.rmem_default=8388608
echo "net.core.rmem_max=33554432" | sudo tee -a /etc/sysctl.d/99-pmacct.conf
echo "net.core.rmem_default=8388608" | sudo tee -a /etc/sysctl.d/99-pmacct.conf
Bước 3: Tạo cơ sở dữ liệu và Schema trong PostgreSQL
Tạo một user và database PostgreSQL riêng cho pmacct. Chúng ta sẽ tạo một bảng để lưu trữ địa chỉ nguồn, đích, cổng layer-4, giao thức, tổng số byte và mốc thời gian.
sudo -u postgres psqlThực thi các câu lệnh SQL sau trong giao diện dòng lệnh psql:
CREATE USER pmacct WITH PASSWORD 'StrongPmacctSecretKey';
CREATE DATABASE pmacct_db OWNER pmacct;
\c pmacct_db pmacct;

CREATE TABLE acct_v9 (
    agent_id VARCHAR(16) NOT NULL DEFAULT '0',
    as_src INT NOT NULL DEFAULT 0,
    as_dst INT NOT NULL DEFAULT 0,
    ip_src INET NOT NULL,
    ip_dst INET NOT NULL,
    src_port INT NOT NULL DEFAULT 0,
    dst_port INT NOT NULL DEFAULT 0,
    ip_proto SMALLINT NOT NULL DEFAULT 0,
    packets BIGINT NOT NULL,
    bytes BIGINT NOT NULL,
    stamp_inserted TIMESTAMP WITHOUT TIME ZONE NOT NULL DEFAULT NOW(),
    stamp_updated TIMESTAMP WITHOUT TIME ZONE DEFAULT NULL,
    PRIMARY KEY (agent_id, ip_src, ip_dst, src_port, dst_port, ip_proto, stamp_inserted)
);

CREATE INDEX idx_acct_v9_stamps ON acct_v9 (stamp_inserted);
CREATE INDEX idx_acct_v9_dst_lookup ON acct_v9 (ip_dst, stamp_inserted);
\q
Bước 4: Cấu hình nfacctd
Tạo file cấu hình cho collector tại đường dẫn /etc/pmacct/nfacctd.conf. Cấu hình này sẽ lắng nghe trên cổng 2055, gom các kết nối gửi đến vào các bucket tổng hợp 5 phút một lần, và truyền dữ liệu đã xử lý vào PostgreSQL thông qua phương thức ghi hàng loạt COPY.
sudo mkdir -p /etc/pmacct
sudo nano /etc/pmacct/nfacctd.conf
Lưu cấu hình sau:
! /etc/pmacct/nfacctd.conf - Cấu hình Daemon kế toán luồng lưu lượng (Flow Accounting)

! Quản lý tiến trình
daemonize: false
pidfile: /run/nfacctd.pid
syslog: daemon

! Thiết lập socket và bộ đệm
nfacctd_ip: 0.0.0.0
nfacctd_port: 2055
nfacctd_time_new: true
plugin_buffer_size: 10240
plugin_pipe_size: 10240000

! Backend đầu ra
plugins: pgsql[traffic_in]

! Các trường tổng hợp: gom nhóm các luồng đang hoạt động theo các chiều này
aggregate[traffic_in]: src_host, dst_host, src_port, dst_port, proto

! Tham số cơ sở dữ liệu đích
sql_db[traffic_in]: pmacct_db
sql_table[traffic_in]: acct_v9
sql_user[traffic_in]: pmacct
sql_passwd[traffic_in]: StrongPmacctSecretKey
sql_host[traffic_in]: 127.0.0.1

! Thiết lập thời gian và hiệu năng ghi hàng loạt (bulk write)
sql_refresh_time[traffic_in]: 300
sql_history[traffic_in]: 5m
sql_history_roundoff[traffic_in]: m
sql_dont_try_update[traffic_in]: true
sql_use_copy[traffic_in]: true
Thiết lập sql_use_copy: true chỉ định pmacct đóng gói các hàng dữ liệu bằng giao thức binary bulk-copy của PostgreSQL thay vì gửi từng lệnh INSERT riêng lẻ. Việc này giúp giảm tải I/O đĩa và giữ độ trễ ghi dữ liệu dưới 20 mili-giây ngay cả khi lưu lượng mạng tăng cao.
Bước 5: Tạo Systemd Service
Tạo một systemd service unit cho nfacctd để bộ thu thập này tự động khởi động lại sau mỗi lần reboot hệ thống hoặc khi xảy ra sự cố đột ngột.
sudo nano /etc/systemd/system/nfacctd.serviceDán nội dung định nghĩa unit file:
[Unit]
Description=Bộ thu thập NetFlow/IPFIX pmacct
After=network.target postgresql.service
Wants=postgresql.service

[Service]
Type=simple
ExecStart=/usr/sbin/nfacctd -f /etc/pmacct/nfacctd.conf
Restart=always
RestartSec=5s
LimitNOFILE=65536

[Install]
WantedBy=multi-user.target
Nạp lại trình quản lý systemd, kích hoạt service và kiểm tra trạng thái hoạt động:
sudo systemctl daemon-reload
sudo systemctl enable --now nfacctd
sudo systemctl status nfacctd
Xác nhận rằng bộ thu thập đang lắng nghe trên cổng UDP 2055:
sudo ss -ulnp 'sport = :2055'Bước 6: Truy vấn và phân tích dữ liệu lưu lượng
Cấu hình các router biên hoặc switch để xuất dữ liệu luồng tới địa chỉ IP của máy chủ Linux qua cổng UDP 2055. Đợi khoảng 5 phút để bucket bộ nhớ đệm đầu tiên được lấp đầy và ghi vào cơ sở dữ liệu. Sau đó, truy cập vào PostgreSQL để phân tích các mẫu lưu lượng:
psql -U pmacct -d pmacct_db -h 127.0.0.1Tìm top 5 máy chủ nội bộ tiếp nhận lưu lượng inbound lớn nhất trong 60 phút qua:
SELECT
    ip_dst AS destination_ip,
    CASE ip_proto
        WHEN 6 THEN 'TCP'
        WHEN 17 THEN 'UDP'
        WHEN 1 THEN 'ICMP'
        ELSE 'Other'
    END AS protocol,
    SUM(packets) AS total_packets,
    ROUND(SUM(bytes)::numeric / (1024 * 1024), 2) AS total_mb
FROM
    acct_v9
WHERE
    stamp_inserted > NOW() - INTERVAL '1 hour'
GROUP BY
    ip_dst, ip_proto
ORDER BY
    total_mb DESC
LIMIT 5;
Xác định cổng dịch vụ đích nào chiếm nhiều băng thông nhất trong cùng khoảng thời gian đó:
SELECT
    dst_port,
    CASE ip_proto
        WHEN 6 THEN 'TCP'
        WHEN 17 THEN 'UDP'
        ELSE 'Other'
    END AS transport,
    ROUND(SUM(bytes)::numeric / (1024 * 1024), 2) AS mb_consumed
FROM
    acct_v9
WHERE
    stamp_inserted > NOW() - INTERVAL '1 hour'
GROUP BY
    dst_port, ip_proto
ORDER BY
    mb_consumed DESC
LIMIT 10;
Máy chủ Linux của bạn giờ đây đã trở thành một bộ thu thập dữ liệu luồng hiệu năng cao. Từ bước này, bạn có thể kết nối Grafana qua data source PostgreSQL chính thức để vẽ biểu đồ xu hướng băng thông thời gian thực, phát hiện sớm các cuộc tấn công DDoS và dự báo nhu cầu dung lượng uplink cho toàn bộ hạ tầng mạng.