課題:LLMへの直接リクエストのスケールに伴うコスト爆発
6か月前、弊社のカスタマーサポート用コパイロットは大きな壁にぶつかりました。わずか3週間でクエリ量が10倍に急増し、1日あたり約6万件のリクエストに達したのです。その結果、2つの深刻なボトルネックが露呈しました。第1に、月間のOpenAI請求額が1万4,000ドルを超え、当初の予算5,000ドルを大幅にオーバーしたこと。第2に、ユーザーが単純な回答を得るためだけに、ローディング表示を見つめたまま3〜7秒間も待たされる事態が発生したことです。
一般的なキャッシュ手法は導入初日に破綻しました。通常のWebアーキテクチャであれば、RedisやMemcachedを用いた完全一致によるキー検索がスムーズに機能します。GET /api/user/42のようなエンドポイントは、常にバイト単位で完全に一致するためです。しかし、人間の自然言語はそうはいきません。ある日の午後、実際にヘルプデスクに寄せられた3件の問い合わせを見てみましょう。
- 「パスワードをリセットするにはどうすればいいですか?」
- 「アカウントのパスワード再設定を手伝ってもらえますか?」
- 「パスワードを忘れました。変更方法を教えてください。」
従来のキー・バリューストアは、これらをまったく異なる3つの文字列として扱います。つまり、LLM APIへのラウンドトリップが3回発生することになり、システムプロンプトのオーバーヘッドを含めると、GPT-4o-miniでも1回あたり約0.003ドルの費用がかかります。しかし意味論的(セマンティック)には、これらはすべて同じ回答を求めているにすぎません。言い回しが少し異なるだけのクエリを毎回リモートの推論エンドポイントへ転送することは、費用の浪費であり、ユーザー体験を損ね、コンピュートリソースを無駄に消費する原因となります。
基本概念:セマンティックキャッシュの仕組み
セマンティックキャッシュは、単純な文字列ハッシュの代わりにベクトル類似度検索を用います。文字の完全一致を求めるのではなく、入力の数学的な意味を検証する仕組みです。新たに入力されたプロンプトが、ベクトル空間上で既存のエントリと十分に近接しているかを判定します。
1. セマンティックパイプラインのアーキテクチャ
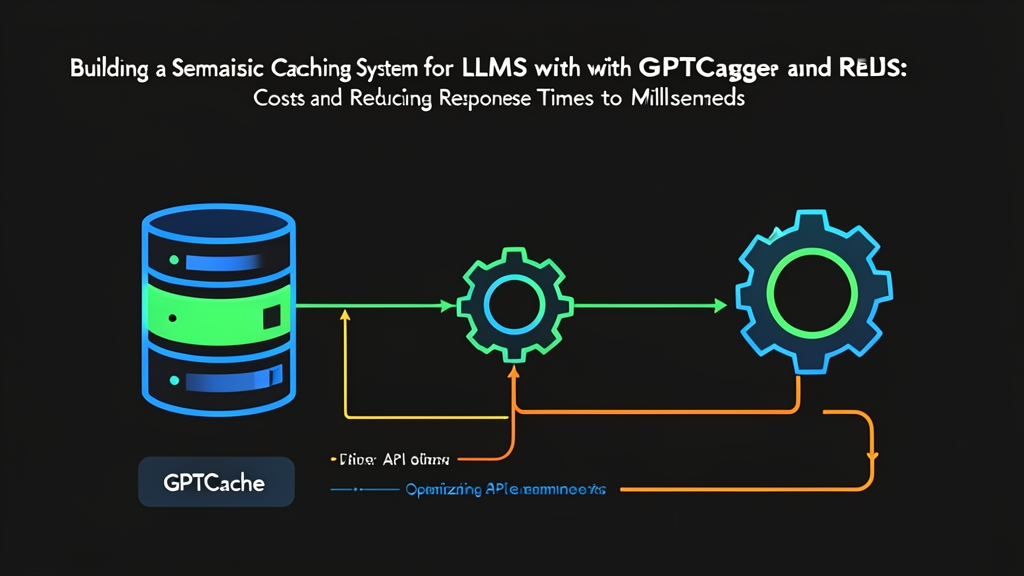
本番環境向けパイプラインは、以下の実践的な4ステップで構成されます。
- 埋め込み(Embedding)生成:MiniLMやtext-embedding-3-smallのような高速かつコンパクトなモデルを使用し、入力テキストを密なベクトル埋め込みに変換します。
- ベクトル類似度検索:Redisにクエリを投げ、コサイン類似度が最も高い(またはユークリッド距離が最も小さい)保存済み埋め込みを特定します。
- 閾値評価:距離スコアが設定した基準値(例:ユークリッド距離0.18未満)を下回っている場合、エンジンはキャッシュヒットと判定します。基準を超えている場合はキャッシュミスとなります。
- ストレージとエビクション(破棄):キャッシュミスの際はLLMへ問い合わせてユーザーに回答を返し、次回の参照に備えて埋め込みと回答のペアを非同期でRedisに保存します。
2. なぜGPTCacheとRedisを採用するのか?
GPTCacheは、プロンプトの前処理、ローカルでの埋め込み計算、類似度距離の評価に関するモジュール化された抽象化レイヤーを提供します。一方、RedisはRediSearchモジュールを通じて高スループットなベクトル検索を処理しつつ、生成された回答を保持する永続キー・バリューストアとしても機能します。この2つを組み合わせることで、高コストなプロトタイプだったコパイロットは、トラフィックの急増にもびくともしないエンタープライズグレードのサービスへと進化しました。
実践演習:キャッシュをステップバイステップで構築する
ベクトルインデックス機能を備えたローカルのRedis Stackインスタンスを立ち上げ、Pythonを使ってGPTCacheと連携させてみましょう。
ステップ1:DockerでRedis Stackを起動する
ベクトル検索を利用するには、RediSearchモジュールがロードされたRedisが必要です。公式のredis/redis-stack-serverイメージには、必要なものがすべてプリインストールされています。
docker run -d \
  --name redis-semantic-cache \
  -p 6379:6379 \
  -v redis_cache_data:/data \
  redis/redis-stack-server:latest
コンテナが正常に稼働し、コマンドに応答することを確認します。
docker exec -it redis-semantic-cache redis-cli ping
# 期待される出力: PONG
ステップ2:Python依存パッケージのインストール
クリーンな仮想環境を用意し、必要なクライアントパッケージをインストールします。
pip install gptcache redis openai onnxruntime sentence-transformersステップ3:Redisストレージを利用したGPTCacheの初期化
以下は、OpenAIクライアントをラップするエンドツーエンドの実装コードです。キャッシュ評価に伴う外部APIコストをゼロに抑えるため、軽量なall-MiniLM-L6-v2モデルをONNX経由でローカル実行します。
import os
import time
from gptcache import cache
from gptcache.adapter import openai as cached_openai
from gptcache.embedding import Onnx
from gptcache.manager import CacheBase, VectorBase, get_data_manager
from gptcache.processor.pre import get_prompt
from gptcache.similarity_evaluation.distance import SearchDistanceEvaluation

# APIキーの設定
os.environ["OPENAI_API_KEY"] = "your-openai-api-key-here"

def init_semantic_cache():
    # 1. ローカルONNX埋め込みエンジン(モデルサイズ約80MB、CPU上で4〜8msで動作)
    encoder = Onnx(model_name="all-MiniLM-L6-v2")

    # 2. Redisストレージの設定
    data_manager = get_data_manager(
        CacheBase("redis", host="localhost", port=6379),
        VectorBase(
            "redis",
            host="localhost",
            port=6379,
            dimension=384,  # all-MiniLM-L6-v2は384次元のベクトルを出力
            index_name="gptcache_idx"
        )
    )

    # 3. 距離の閾値設定(距離が小さいほど意味的一致度が高い)
    evaluator = SearchDistanceEvaluation(max_distance=0.20)

    # 4. グローバルキャッシュシングルトンの初期化
    cache.init(
        pre_embedding_func=get_prompt,
        embedding_func=encoder.to_embeddings,
        data_manager=data_manager,
        similarity_evaluation=evaluator
    )
    print("Redisバックエンドによるセマンティックキャッシュが初期化されました。")

if __name__ == "__main__":
    init_semantic_cache()
ステップ4:クエリの実行とレイテンシのベンチマーク
最初のクエリと、それを言い換えた2回目のクエリを実行し、応答時間を比較してみましょう。
def query_llm(prompt_text: str):
    start_time = time.time()
    response = cached_openai.ChatCompletion.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt_text}],
        temperature=0.0
    )
    elapsed_ms = (time.time() - start_time) * 1000
    content = response["choices"][0]["message"]["content"]
    return content, elapsed_ms

# クエリ1: コールドスタート(キャッシュミス)
prompt_a = "アカウントのパスワードをリセットするにはどうすればいいですか?"
print(f"実行中: '{prompt_a}'")
answer_a, time_a = query_llm(prompt_a)
print(f"レイテンシ: {time_a:.2f} ms\n応答: {answer_a[:90]}...\n")

# クエリ2: 言い換えたプロンプト(キャッシュヒット)
prompt_b = "パスワードを忘れてしまったのですが、どのように変更できますか?"
print(f"実行中: '{prompt_b}'")
answer_b, time_b = query_llm(prompt_b)
print(f"レイテンシ: {time_b:.2f} ms\n応答: {answer_b[:90]}...\n")
結果は一目瞭然です。テスト環境(AMD EPYC 7763、4 vCPU)において、最初のコールドミスはパブリックネットワーク経由で1,418ミリ秒かかりました。一方、2回目の呼び出しはRedisから直接解決され、わずか11.4ミリ秒で完了しました。これは99.2%のレイテンシ短縮に相当し、トークン消費による費用も一切発生していません。
ステップ5:本番環境に向けた類似度閾値のチューニング
距離の閾値は、回答の品質とキャッシュヒット率の双方を左右します。厳格にしすぎる(例:max_distance < 0.05)とキャッシュがほとんどヒットしなくなり、緩すぎると(例:max_distance > 0.35)セマンティックドリフトが発生し、異なる質問に対して誤った回答を返すリスクが高まります。
実際のサポート対応ログ2万5,000件を用いた検証に基づき、弊社では以下の3つの運用基準を策定しました。
- 距離 0.00〜0.10(厳格):請求関連のワークフロー、ロールや権限の更新、細部の違いで結果が大きく変わるコードスニペットなどに最適です。
- 距離 0.11〜0.22(バランス型・推奨デフォルト):オンボーディング案内、一般的なアカウントへの質問、トラブルシューティング用ドキュメントに適しています。テスト環境での誤検知率は0.4%未満に抑えられました。
- 距離 0.25超(高リスク):明らかな意味の混同が発生します。「Proプランへのアップグレード方法」という質問に対して、「Proプランの解約方法」というキャッシュされた回答を誤って返してしまう恐れがあります。
結論:月間180万件のクエリ運用から得られた知見
Redis Stack上でGPTCacheを稼働させたことで、ユニットエコノミクスは劇的に改善しました。月間180万件のクエリ全体を通じて、キャッシュヒット率は38%〜44%で安定し、月々のAPI請求額を5,600ドル削減できました。さらに、95パーセンタイル(P95)の応答時間は4.2秒から380ミリ秒へと劇的に短縮されました。
クラスタ環境へ本番展開する前に、以下の3つのルールを確認してください。
- 動的な変数の事前除去:ベクトル埋め込みを計算する前に、タイムスタンプ、ユーザーID、請求書番号などを取り除いてください。サニタイズされていない文字列はキャッシュヒット率を大幅に低下させます。
- 厳格なTTLの適用:古いドキュメントを元にした回答は、ハルシネーションや陳腐化した情報の提供につながります。Redis標準のTTL機能を活用し、キーが7日後に自動失効するよう設定しています。
- 埋め込み処理のローカル完結:キャッシュ確認のためにOpenAIのtext-embedding-3のようなリモート埋め込みエンドポイントを呼び出すのは避けてください。外部へのAPIコールで120〜250ミリ秒のネットワーク遅延が発生し、高速なインメモリキャッシュのメリットが損なわれます。代わりにMiniLMなどをCPU上でローカル実行してください。