Kiểm thử ứng dụng LLM: Đánh giá thủ công vs Script tự viết vs Framework chuyên dụng
Sáu tháng trước, bot hỗ trợ khách hàng của chúng tôi bỗng dưng gặp sự cố âm thầm trên môi trường production. Một lập trình viên đã hạ temperature từ 0.7 xuống 0.2 và chỉnh lại vài từ ngữ để giọng văn thân thiện hơn. Sự thay đổi tưởng chừng vô hại đó đã vô tình làm mất dấu ngoặc đóng trong phản hồi JSON, khiến webhook tiếp nhận của Zendesk bị crash suốt 4 giờ đồng hồ.
Để ngăn chặn các sự cố làm gián đoạn production, chúng tôi đã tiến hành benchmark ba chiến lược đánh giá prompt phổ biến:
- Kiểm tra thủ công theo mẫu (Manual Spot-Checking): Kỹ sư copy và dán 5 đến 10 câu truy vấn mẫu vào OpenAI Playground trước khi tạo pull request. Cách này hoạt động ổn trong ngày đầu tiên. Nhưng con người rất dễ bỏ sót các trường hợp biên (edge cases), không theo dõi được lượng token bị đội lên ngoài ý muốn, và không thể phát hiện lỗi hồi quy trên tập dữ liệu gồm 500 ca kiểm thử.
- Hệ thống kiểm thử Python tự viết (Custom Python Test Harnesses): Các đội ngũ tự xây dựng bộ test pytest nội bộ bọc quanh SDK của OpenAI hoặc Anthropic. Bạn có toàn quyền kiểm soát các test fixture. Tuy nhiên, việc duy trì cơ chế retry xử lý rate-limit, theo dõi chi phí token và tạo báo cáo tùy biến sẽ nhanh chóng ngốn hàng chục giờ làm việc mỗi quý.
- Công cụ đánh giá dạng khai báo (Promptfoo): Một CLI và thư viện gọn nhẹ được thiết kế để xử lý prompt tương tự như mã nguồn đã biên dịch. Bạn khai báo dữ liệu đầu vào, biến mock và các quy tắc kiểm tra (assertion) trong một file YAML duy nhất. Promptfoo đảm nhiệm việc định tuyến đến các provider, chạy song song các assertion trên nhiều mô hình, và trả về mã thoát (exit code) chuẩn mực bên trong pipeline CI.
Ưu và nhược điểm: Đánh giá Promptfoo sau 6 tháng vận hành production
Việc triển khai Promptfoo trên 14 quy trình tương tác trực tiếp với khách hàng đã mang lại cho chúng tôi những số liệu thực tế về điểm mạnh cũng như các rào cản mà đội ngũ gặp phải.
Những điểm Promptfoo vượt trội
- Tạo ma trận thử nghiệm không cần code thừa (Zero-Boilerplate Matrixing): Bạn cần kiểm thử 3 biến thể prompt trên GPT-4o-mini, Claude 3.5 Haiku và một endpoint Ollama nội bộ? Chỉ cần khai báo chúng trong file YAML cùng 40 dòng dữ liệu test. Promptfoo sẽ tự động thực thi ma trận hoán vị 120 lượt chạy song song mà không cần viết thêm mã nối nào.
- Tích hợp sẵn các assertion xác định (Built-In Deterministic Assertions): Bạn có thể kiểm tra tức thì JSON schema, biểu thức chính quy (regex), ngưỡng tương đồng ngữ nghĩa, độ trễ phản hồi (dưới 1.800ms) và giới hạn ngân sách cho mỗi lệnh gọi mà không cần tự viết logic kiểm thử.
- Thực thi cục bộ, bảo mật cô lập (Local, Air-Gapped Execution): Khác với các nền tảng đánh giá SaaS nạp dữ liệu production vào cơ sở dữ liệu đám mây bên thứ ba, Promptfoo chạy trực tiếp trong terminal hoặc runner CI riêng của bạn. Dữ liệu độc quyền của khách hàng không bao giờ phải gửi qua máy chủ của nhà cung cấp dịch vụ đánh giá.
- Kết quả CI rõ ràng, dễ hành động: Công cụ trả về mã trạng thái 100 khi có test thất bại, theo dõi chi phí token chi tiết đến từng phần nhỏ của cent, đồng thời xuất dashboard HTML độc lập hoặc bảng tóm tắt định dạng markdown cho pull request.
Những hạn chế trong thực tế
- Chi phí cộng dồn khi dùng LLM làm giám khảo (LLM-as-a-Judge): Việc sử dụng
llm-rubricđể chấm điểm giọng điệu hoặc khả năng suy luận mở sẽ tạo ra một lệnh gọi API phụ cho mỗi test case. Với một bộ test gồm 100 ca kiểm thử chạy qua 10 pull request mỗi ngày, các lệnh gọi giám khảo này đã làm tăng thêm $45 mỗi tuần vào hóa đơn OpenAI của chúng tôi. - Độ phức tạp khi kiểm thử hội thoại nhiều lượt (Multi-Turn Dialogue): Trích xuất dữ liệu đơn lượt rất dễ kiểm thử. Ngược lại, các luồng hội thoại nhiều lượt đòi hỏi phải tự điều phối trạng thái hoặc viết hook mở rộng bằng Python để mô phỏng chính xác lịch sử phiên làm việc.
Chiến lược kiểm thử CI/CD trên môi trường Production của chúng tôi
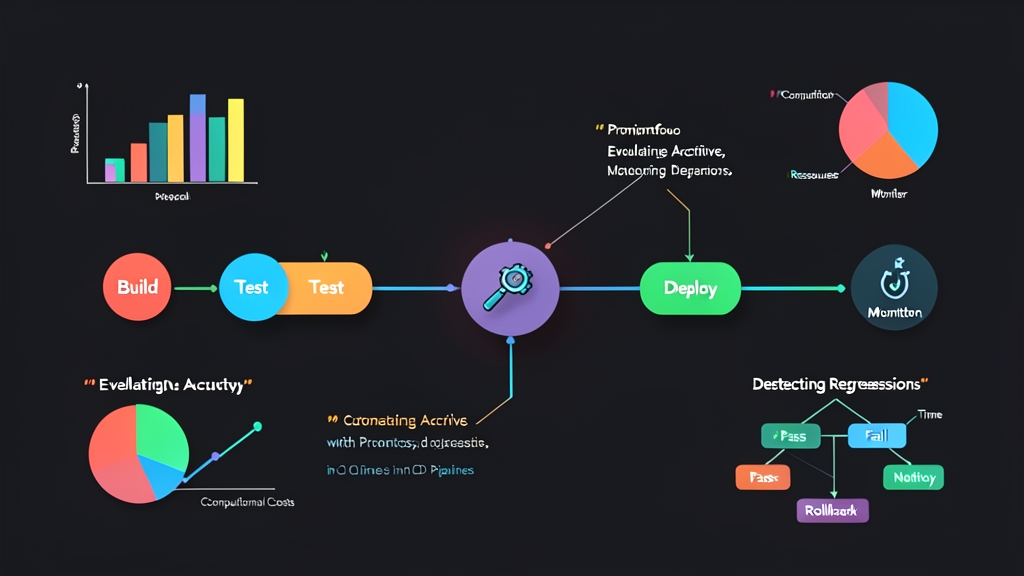
Chạy toàn bộ ma trận 200 test case sau mỗi lần git push sẽ gây lãng phí credit API và làm chậm tốc độ làm việc của lập trình viên. Thay vào đó, chúng tôi chia quy trình xác thực prompt thành ba vòng kiểm soát rõ ràng:
- Pre-commit cục bộ (30 giây): Một bộ smoke test tinh gọn gồm 5 lượt kiểm tra cơ bản chạy với
gpt-4o-minihoặc phản hồi mock cục bộ. Bước này giúp phát hiện lỗi cú pháp và JSON schema không hợp lệ trước khi code rời khỏi máy tính cá nhân. - Kiểm soát Pull Request (2 đến 3 phút): Bộ kiểm thử gồm 40 đến 60 assertion xác định nhằm kiểm tra JSON schema, giới hạn regex, mức trần token và ngưỡng độ trễ. Quy trình này chạy trên mọi pull request trỏ vào nhánh main.
- Bộ kiểm thử hồi quy chạy hàng đêm (15 phút): Đánh giá toàn diện trên hơn 300 mẫu dữ liệu production đã ẩn danh. Giai đoạn này áp dụng chấm điểm bằng mô hình (model-graded rubrics), quét tính độc hại (toxicity) và so sánh chi phí trực tiếp giữa các bản nâng cấp mô hình.
Trong 6 tháng qua với hơn 400 pull request được merge, pipeline phân tầng này đã ngăn chặn thành công 18 lỗi thay đổi schema nghiêm trọng trước khi chúng kịp lên tới môi trường staging.
Hướng dẫn triển khai: Cấu hình Promptfoo với GitHub Actions
Thực hiện theo các bước sau để thiết lập kiểm thử prompt tự động từ đầu, áp đặt giới hạn nghiêm ngặt về độ trễ lẫn ngân sách, và kích hoạt kiểm tra tự động trên mọi pull request.
1. Cài đặt và khởi tạo dự án
Cài đặt Promptfoo dưới dạng dev dependency trong dự án của bạn:
# Cài đặt Promptfoo vào dự án của bạn
npm install --save-dev promptfoo

# Khởi tạo thư mục cấu hình mẫu ban đầu
npx promptfoo init
2. Xây dựng Prompt và định nghĩa các Assertion
Lưu template prompt dùng cho production vào prompts/support_agent.txt:
Bạn là trợ lý hỗ trợ CNTT cho một nền tảng cloud nội bộ.
Hãy chuyển đổi vấn đề của người dùng thành phản hồi JSON có cấu trúc với các khóa: "category", "severity", và "action_required".
Không bao gồm văn bản đàm thoại hoặc định dạng markdown bên ngoài JSON.

Vấn đề của người dùng: {{issue}}
Tiếp theo, hãy khai báo các model provider, ngưỡng cơ sở và các test case trong promptfooconfig.yaml:
description: "Đánh giá Prompt cho Ticket Hỗ trợ"

prompts:
  - file://prompts/support_agent.txt

providers:
  - id: openai:gpt-4o-mini
    config:
      temperature: 0.1
  - id: anthropic:messages:claude-3-5-haiku-20241022
    config:
      temperature: 0.1

defaultTest:
  assert:
    # Đảm bảo độ trễ phản hồi luôn dưới 1.800 ms
    - type: latency
      threshold: 1800
    # Đảm bảo chi phí mỗi request luôn dưới $0.0015
    - type: cost
      threshold: 0.0015

tests:
  - description: "Lỗi kết nối cơ sở dữ liệu phải được phân loại mức độ nghiêm trọng high hoặc critical"
    vars:
      issue: "Replica của cụm Postgres production không vượt qua health check do bị connection pool timeout."
    assert:
      - type: is-json
      - type: javascript
        value: "['critical', 'high'].includes(JSON.parse(output).severity)"
      - type: javascript
        value: "JSON.parse(output).category === 'database'"

  - description: "Yêu cầu đặt lại mật khẩu phải được phân loại mức độ nghiêm trọng low"
    vars:
      issue: "Có ai đặt lại giúp tôi mật khẩu của trang dashboard Grafana trên staging được không?"
    assert:
      - type: is-json
      - type: javascript
        value: "JSON.parse(output).severity === 'low'"
      - type: not-icontains
        value: "sudo"
3. Chạy đánh giá cục bộ và xem lại kết quả
Export API key của bạn và kích hoạt bộ đánh giá trực tiếp ngay trong terminal:
export OPENAI_API_KEY="sk-..."
export ANTHROPIC_API_KEY="sk-ant-..."

# Chạy các assertion đối với các provider đã cấu hình
npx promptfoo eval

# Khởi chạy giao diện so sánh trực quan cục bộ
npx promptfoo view
Terminal sẽ lập tức hiển thị bảng tóm tắt dạng ASCII về lượng token tiêu thụ, trạng thái pass/fail và độ trễ của từng mô hình. Lệnh npx promptfoo view sẽ khởi chạy một web server cục bộ (mặc định tại cổng 15500), nơi bạn có thể kiểm tra chi tiết các assertion thất bại và so sánh trực quan kết quả hoàn thành gốc giữa các mô hình.
4. Tích hợp vào CI Pipeline của GitHub Actions
Để tự động chạy các bài kiểm thử này trên mọi pull request có chỉnh sửa file prompt template hoặc file test, hãy tạo file .github/workflows/prompt-tests.yml:
name: Đánh giá Prompt LLM

on:
  pull_request:
    paths:
      - 'prompts/**'
      - 'promptfooconfig.yaml'

jobs:
  evaluate-prompts:
    runs-on: ubuntu-latest
    steps:
      - name: Checkout mã nguồn
        uses: actions/checkout@v4

      - name: Cài đặt Node.js
        uses: actions/setup-node@v4
        with:
          node-version: 20
          cache: 'npm'

      - name: Cài đặt Dependencies
        run: npm ci

      - name: Chạy đánh giá Promptfoo
        env:
          OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
        run: npx promptfoo eval --no-cache
Nếu một kỹ sư chỉnh sửa prompt làm vỡ JSON schema hoặc vô tình tạo ra câu trả lời ảo giác (hallucination) ngốn tới 1.000 token, Promptfoo sẽ thoát với mã lỗi khác 0. GitHub Actions sẽ lập tức đánh dấu bước kiểm tra thất bại và chặn việc merge pull request đó.