Bài toán thực tế: Gọi trực tiếp LLM khi mở rộng quy mô làm đội chi phí chóng mặt
Sáu tháng trước, trợ lý hỗ trợ khách hàng (copilot) của chúng tôi chạm trần giới hạn. Lượng truy vấn tăng gấp mười lần chỉ trong ba tuần, đạt khoảng 60.000 yêu cầu mỗi ngày. Hai nút thắt cổ chai đau đầu xuất hiện ngay lập tức. Đầu tiên, hóa đơn OpenAI hàng tháng vượt mốc 14.000 USD, phá vỡ hoàn toàn mức ngân sách 5.000 USD dự tính. Thứ hai, người dùng phải chờ từ 3 đến 7 giây nhìn biểu tượng loading chỉ để nhận các câu trả lời cơ bản.
Phương pháp caching tiêu chuẩn thất bại ngay từ ngày đầu. Trong các kiến trúc web thông thường, việc tra cứu key dạng chuỗi ký tự chính xác (exact-string) trong Redis hoặc Memcached hoạt động cực kỳ mượt mà. Các endpoint như GET /api/user/42 khớp chính xác từng byte trong mọi lần gọi. Nhưng ngôn ngữ con người lại không hoạt động như vậy. Hãy nhìn vào ba ticket hỗ trợ thực tế được ghi nhận chỉ trong một buổi chiều:
- “Làm thế nào để đặt lại mật khẩu?”
- “Bạn có thể giúp tôi reset mật khẩu tài khoản không?”
- “Tôi quên mật khẩu rồi, đổi lại như thế nào?”
Các kho lưu trữ key-value truyền thống xem đây là ba chuỗi ký tự hoàn toàn khác biệt. Điều đó đồng nghĩa với ba lượt gọi khứ hồi đến API của LLM, tiêu tốn khoảng 0,003 USD cho mỗi lượt trên GPT-4o-mini tính cả chi phí prompt hệ thống (system prompt). Tuy nhiên về mặt ngữ nghĩa (semantically), chúng đều yêu cầu một câu trả lời giống hệt nhau. Việc chuyển tiếp mọi truy vấn được diễn đạt lại (rephrased) đến các endpoint suy luận từ xa vừa gây lãng phí tiền bạc, làm gián đoạn trải nghiệm người dùng, vừa lãng phí tài nguyên tính toán.
Khái niệm cốt lõi: Cơ chế hoạt động của Semantic Caching
Semantic caching thay thế việc băm chuỗi (string hashing) thô bằng tìm kiếm độ tương đồng vector (vector similarity search). Thay vì đòi hỏi phải khớp chính xác từng ký tự, bộ nhớ cache sẽ kiểm tra ý nghĩa toán học của văn bản đầu vào. Cơ chế này xác định xem prompt mới có nằm đủ gần một bản ghi đã tồn tại trong không gian vector hay không.
1. Kiến trúc Semantic Pipeline
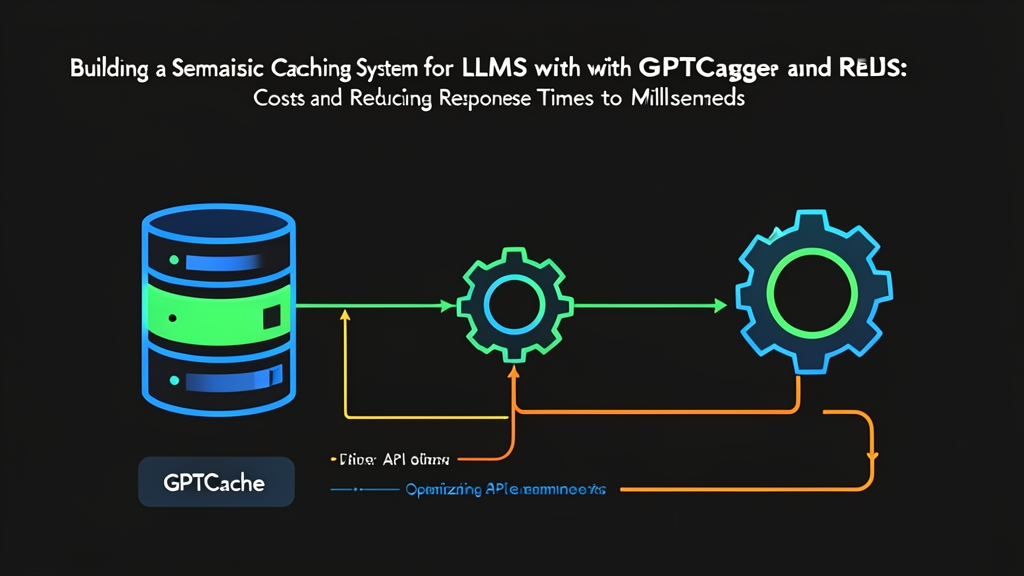
Một pipeline sẵn sàng cho production tuân theo bốn bước thực tế sau:
- Tạo Embedding: Chuyển đổi văn bản đầu vào thành vector embedding dày đặc bằng một mô hình nhanh, nhỏ gọn như MiniLM hoặc text-embedding-3-small.
- Tìm kiếm độ tương đồng Vector: Truy vấn Redis để tìm các embedding đã lưu có độ tương đồng cosine (cosine similarity) cao nhất hoặc khoảng cách Euclid (Euclidean distance) nhỏ nhất.
- Đánh giá ngưỡng (Threshold Evaluation): Nếu điểm khoảng cách nằm dưới ngưỡng giới hạn (chẳng hạn khoảng cách Euclid dưới 0,18), hệ thống ghi nhận một cache hit. Ngược lại, hệ thống sẽ báo cache miss.
- Lưu trữ và thu hồi (Eviction): Khi gặp cache miss, hệ thống sẽ truy vấn LLM, trả kết quả cho người dùng và lưu bất đồng bộ cả embedding lẫn câu trả lời vào Redis để phục vụ cho các lần tra cứu sau.
2. Tại sao lại chọn GPTCache + Redis?
GPTCache cung cấp các lớp trừu tượng dạng module hóa để tiền xử lý prompt, tính toán embedding cục bộ và đánh giá khoảng cách tương đồng. Redis xử lý việc tìm kiếm vector thông lượng cao thông qua module RediSearch, đồng thời đóng vai trò là kho lưu trữ key-value bền vững cho các phản hồi được tạo ra. Sự kết hợp giữa cả hai đã đưa trợ lý ảo của chúng tôi từ một prototype đắt đỏ trở thành một dịch vụ chuẩn doanh nghiệp, xử lý mượt mà các đợt tăng đột biến lưu lượng mà không gặp bất kỳ trở ngại nào.
Thực hành: Xây dựng Semantic Cache từng bước
Hãy cùng khởi tạo một instance Redis Stack cục bộ có lập chỉ mục vector và kết nối nó với GPTCache bằng Python.
Bước 1: Khởi chạy Redis Stack qua Docker
Tìm kiếm vector yêu cầu Redis phải được nạp module RediSearch. Image chính thức redis/redis-stack-server đã tích hợp sẵn mọi thứ cần thiết.
docker run -d \
  --name redis-semantic-cache \
  -p 6379:6379 \
  -v redis_cache_data:/data \
  redis/redis-stack-server:latest
Kiểm tra xem container của bạn đã hoạt động và phản hồi các lệnh hay chưa:
docker exec -it redis-semantic-cache redis-cli ping
# Kết quả mong đợi: PONG
Bước 2: Cài đặt các thư viện Python
Cài đặt các gói client cần thiết bên trong một môi trường ảo (virtual environment) sạch:
pip install gptcache redis openai onnxruntime sentence-transformersBước 3: Khởi tạo GPTCache với Redis Storage
Dưới đây là một wrapper hoàn chỉnh bao bọc client OpenAI. Chúng tôi chạy mô hình nhẹ all-MiniLM-L6-v2 cục bộ qua ONNX để việc đánh giá cache không tốn bất kỳ chi phí API bên ngoài nào.
import os
import time
from gptcache import cache
from gptcache.adapter import openai as cached_openai
from gptcache.embedding import Onnx
from gptcache.manager import CacheBase, VectorBase, get_data_manager
from gptcache.processor.pre import get_prompt
from gptcache.similarity_evaluation.distance import SearchDistanceEvaluation

# Cấu hình API key
os.environ["OPENAI_API_KEY"] = "your-openai-api-key-here"

def init_semantic_cache():
    # 1. Engine tạo embedding ONNX cục bộ (mô hình ~80MB, chạy mất 4-8 ms trên CPU)
    encoder = Onnx(model_name="all-MiniLM-L6-v2")

    # 2. Cấu hình lưu trữ Redis
    data_manager = get_data_manager(
        CacheBase("redis", host="localhost", port=6379),
        VectorBase(
            "redis",
            host="localhost",
            port=6379,
            dimension=384,  # all-MiniLM-L6-v2 trả về vector 384 chiều
            index_name="gptcache_idx"
        )
    )

    # 3. Ngưỡng khoảng cách (khoảng cách càng nhỏ = khớp ngữ nghĩa càng chặt chẽ)
    evaluator = SearchDistanceEvaluation(max_distance=0.20)

    # 4. Khởi tạo singleton cache toàn cục
    cache.init(
        pre_embedding_func=get_prompt,
        embedding_func=encoder.to_embeddings,
        data_manager=data_manager,
        similarity_evaluation=evaluator
    )
    print("Semantic cache đã được khởi tạo với backend Redis.")

if __name__ == "__main__":
    init_semantic_cache()
Bước 4: Thực thi truy vấn và đo độ trễ (Benchmark Latency)
Bây giờ hãy thử nghiệm một truy vấn ban đầu và một câu hỏi diễn đạt lại tiếp theo để đo thời gian phản hồi:
def query_llm(prompt_text: str):
    start_time = time.time()
    response = cached_openai.ChatCompletion.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt_text}],
        temperature=0.0
    )
    elapsed_ms = (time.time() - start_time) * 1000
    content = response["choices"][0]["message"]["content"]
    return content, elapsed_ms

# Truy vấn 1: Khởi động lạnh (Cache Miss)
prompt_a = "Làm thế nào để đặt lại mật khẩu tài khoản của tôi?"
print(f"Đang thực thi: '{prompt_a}'")
answer_a, time_a = query_llm(prompt_a)
print(f"Độ trễ: {time_a:.2f} ms\nCâu trả lời: {answer_a[:90]}...\n")

# Truy vấn 2: Prompt được diễn đạt lại (Cache Hit)
prompt_b = "Tôi quên mật khẩu rồi, làm sao để đổi lại?"
print(f"Đang thực thi: '{prompt_b}'")
answer_b, time_b = query_llm(prompt_b)
print(f"Độ trễ: {time_b:.2f} ms\nCâu trả lời: {answer_b[:90]}...\n")
Các con số đã tự nói lên tất cả. Trên máy chủ thử nghiệm của chúng tôi (AMD EPYC 7763, 4 vCPU), lượt cache miss khởi động lạnh đầu tiên mất 1.418 ms qua mạng Internet công cộng. Lần gọi thứ hai được giải quyết trực tiếp từ Redis chỉ trong vỏn vẹn 11,4 ms. Mức giảm độ trễ lên tới 99,2% và không tiêu tốn bất kỳ token nào trong tài khoản của chúng tôi.
Bước 5: Tinh chỉnh ngưỡng tương đồng (Similarity Threshold) cho Production
Ngưỡng khoảng cách quyết định cả chất lượng câu trả lời lẫn tỷ lệ cache hit. Nếu đặt quá chặt (chẳng hạn max_distance < 0.05), cache sẽ gần như không bao giờ kích hoạt. Nếu đặt quá lỏng (chẳng hạn max_distance > 0.35), bạn sẽ đối mặt với rủi ro trôi ngữ nghĩa (semantic drift) – trả về giải pháp sai cho các vấn đề hoàn toàn khác nhau.
Chúng tôi đã xác định ba mức vận hành dựa trên các đợt kiểm thử với 25.000 bản ghi hội thoại hỗ trợ thực tế:
- Khoảng cách 0.00 – 0.10 (Bảo thủ): Phù hợp nhất cho các luồng thanh toán, cập nhật quyền tài khoản hoặc các đoạn code – nơi mà những chi tiết nhỏ có thể làm thay đổi toàn bộ kết quả.
- Khoảng cách 0.11 – 0.22 (Cân bằng – Mặc định đề xuất): Điểm tối ưu cho quy trình tiếp nhận người dùng mới (onboarding), các câu hỏi về tài khoản và tài liệu hướng dẫn khắc phục sự cố. Giữ tỷ lệ khớp sai (false-positive) dưới 0,4% trong các thử nghiệm của chúng tôi.
- Khoảng cách > 0.25 (Rủi ro cao): Gây ra hiện tượng lẫn lộn ngữ nghĩa rõ rệt. Một prompt hỏi “Làm thế nào để nâng cấp lên bản Pro?” có thể trả về nhầm câu trả lời đã lưu của câu “Làm thế nào để hủy gói Pro?”
Kết luận: Bài học thực chiến từ 1,8 triệu truy vấn mỗi tháng
Vận hành GPTCache trên Redis Stack đã làm thay đổi hoàn toàn bài toán kinh tế trên từng đơn vị (unit economics) của chúng tôi. Trong số 1,8 triệu truy vấn hàng tháng, tỷ lệ hit rate ổn định từ 38% đến 44%. Điều đó giúp tiết kiệm 5.600 USD tiền hóa đơn API mỗi tháng. Đáng kể hơn nữa, độ trễ ở phân vị thứ 95 (percentile 95) giảm mạnh từ 4,2 giây xuống còn 380 mili-giây.
Trước khi triển khai giải pháp này lên các cụm máy chủ của bạn, hãy ghi nhớ ba nguyên tắc sau:
- Làm sạch các biến động (dynamic variables): Loại bỏ các dấu mốc thời gian (timestamp), ID người dùng và mã hóa đơn trước khi tính toán vector embedding. Các chuỗi chưa được chuẩn hóa sẽ làm phá hỏng tỷ lệ cache hit.
- Thiết lập TTL nghiêm ngặt: Tài liệu lỗi thời sẽ dẫn đến câu trả lời bị ảo giác (hallucination) hoặc thông tin cũ. Chúng tôi cho các key trong Redis tự động hết hạn sau 7 ngày thông qua cơ chế TTL tích hợp sẵn.
- Luôn xử lý embedding cục bộ: Đừng bao giờ gọi các endpoint embedding từ xa như OpenAI text-embedding-3 chỉ để kiểm tra cache. Một lệnh gọi embedding từ xa sẽ cộng thêm 120-250 ms độ trễ mạng, làm mất đi ý nghĩa của một bộ nhớ cache in-memory tốc độ cao. Thay vào đó, hãy chạy MiniLM trực tiếp trên CPU.