Nút thắt độ trễ trong các pipeline RAG production
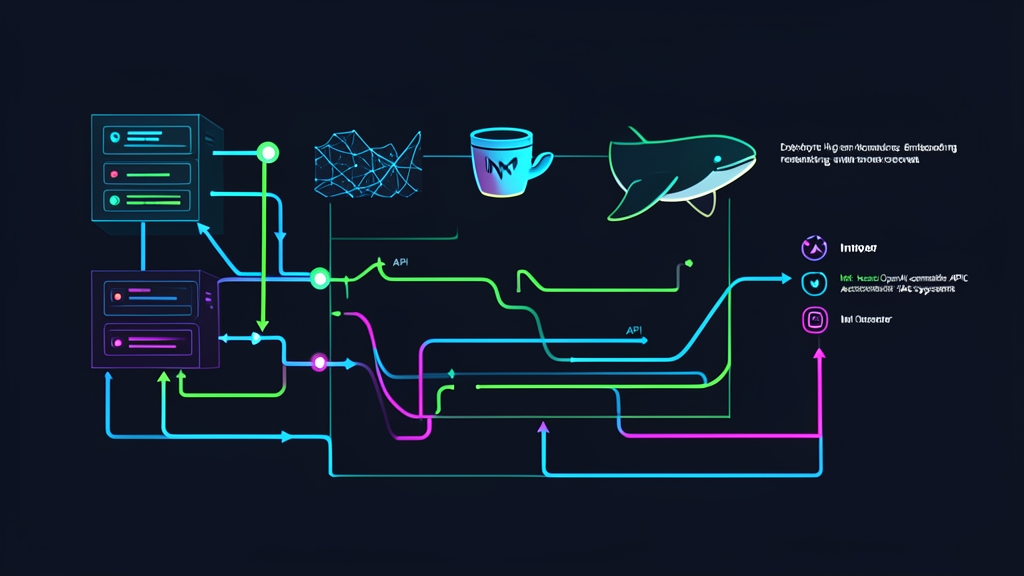
Độ trễ truy xuất (retrieval latency) là “kẻ sát nhân thầm lặng” hủy hoại trải nghiệm người dùng trong các hệ thống RAG (Retrieval-Augmented Generation). Hãy xem xét vòng đời của một truy vấn thông thường: backend gửi văn bản đến một API embedding từ xa, truy vấn cơ sở dữ liệu vector, chuyển tiếp các chunk phù hợp nhất tới cloud reranker, rồi gửi prompt tới LLM. Mỗi chặng trung gian đều tiêu tốn một lượt khứ hồi (round-trip) qua internet. Trước khi LLM kịp sinh ra token đầu tiên, người dùng đã phải chờ từ 1,5 đến 3 giây.
Các API bên thứ ba tạo ra những nút thắt dồn dập. Chạy embedding và reranker qua các endpoint như OpenAI hay Cohere sẽ kéo theo độ trễ mạng chập chờn (network jitter), giới hạn tần suất (rate limit) khắt khe và chi phí tính theo token tăng dần.
Reranking 50 tài liệu cho mỗi truy vấn với 100.000 lượt tìm kiếm mỗi ngày có thể dễ dàng ngốn thêm hơn 1.500 USD mỗi tháng vào hóa đơn cloud. Quan trọng hơn, việc chuyển tài liệu nội bộ và câu hỏi của khách hàng qua internet công cộng sẽ khiến dữ liệu của bạn có nguy cơ bị lộ cho các bên xử lý thứ ba. Chạy inference cục bộ sẽ loại bỏ hoàn toàn những rủi ro này.
Đó chính là lý do Infinity ra đời. Infinity là một inference engine chuyên dụng được xây dựng bằng Rust và Python dành cho các transformer encoder. Nó cung cấp cơ chế dynamic batching tích hợp sẵn, lượng tử hóa FP16 và INT8, cùng một REST API tương thích hoàn toàn với OpenAI cho cả mô hình embedding và cross-encoder reranker.
So sánh các phương pháp: Chiến lược Embedding & Reranking
Việc lựa chọn inference engine phù hợp phụ thuộc trực tiếp vào lưu lượng truy cập và tài nguyên phần cứng hiện có của bạn.
| Phương pháp | Thông lượng & Độ trễ | Chi phí hạ tầng | Khả năng tương thích OpenAI API | Cross-Encoder Reranking |
|---|---|---|---|---|
| Cloud APIs (OpenAI, Cohere) | Độ trễ p95 từ 180–450ms; phụ thuộc vào mạng | Không có (fully managed) | Chuẩn native | Cần các endpoint riêng biệt như Cohere, Voyage hoặc Jina |
| In-Process SentenceTransformers | Đơn luồng nhanh (~25ms), nhưng làm nghẽn GIL khi có lưu lượng đồng thời cao | Dùng chung CPU và bộ nhớ với ứng dụng | Không; cần viết wrapper tùy chỉnh | Vòng lặp batch thủ công; nguy cơ cạn kiệt tài nguyên CPU cao |
| vLLM / TGI | Thông lượng cao, nhưng đòi hỏi 16GB–24GB+ VRAM | Nặng; thiết kế chuyên biệt cho các mô hình autoregressive decoder | Một phần | Hỗ trợ tích hợp cross-encoder kém hoặc không hỗ trợ |
| Infinity Inference Server | Độ trễ p95 từ 8–15ms; hơn 1.200 câu/giây trên một GPU đơn lẻ | Thấp; chạy được trên 4 vCPU hoặc một GPU khiêm tốn 8GB | Hỗ trợ đầy đủ /v1/embeddings và /v1/rerank |
Continuous batching tích hợp sẵn cho cross-encoder |
Đánh giá Infinity khi tự host
Việc đưa inference về nội bộ giúp tăng tốc độ vượt trội, nhưng cũng chuyển giao trách nhiệm vận hành sang đội ngũ của bạn.
Ưu điểm
- Độ trễ dưới 15ms: Các container cục bộ giao tiếp qua Unix socket hoặc mạng bridge của Docker, loại bỏ hoàn toàn quá trình bắt tay (handshake) qua internet công cộng.
- Chi phí tính toán dự đoán được: Chi phí phần cứng luôn cố định. Bạn có thể embed 500 triệu token mà không lo phát sinh phụ phí đột biến hay phải nâng cấp gói dịch vụ.
- Không rò rỉ dữ liệu: Dữ liệu nhạy cảm được giữ trọn vẹn trong subnet riêng tư hoặc VPC của bạn, đáp ứng các tiêu chuẩn cách ly nghiêm ngặt của SOC 2, HIPAA và GDPR một cách dễ dàng.
- Tích hợp dễ dàng: Chuyển đổi endpoint API trong LangChain, LlamaIndex hoặc các HTTP client thuần chỉ bằng cách thay đổi đúng hai dòng code: base URL và API key.
- Chạy chung nhiều mô hình: Triển khai đồng thời mô hình dense embedding như
BAAI/bge-small-en-v1.5và mô hình reranker nhưBAAI/bge-reranker-basetrong cùng một container chỉ với dưới 4 GB VRAM.
Nhược điểm & Thách thức
- Lập kế hoạch dung lượng GPU: Dù Infinity có thể chạy trên CPU qua ONNX Runtime, nhưng để đáp ứng mức đồng thời cao (trên 50 RPS), bạn sẽ cần GPU có tối thiểu 8 GB VRAM.
- Gánh nặng bảo trì: Bạn phải tự giám sát tình trạng container, theo dõi lượng tiêu thụ VRAM và xử lý khởi động lại khi cập nhật server.
- Dung lượng ổ cứng: Các checkpoint của mô hình embedding và reranking cần từ 2 GB đến 6 GB bộ nhớ NVMe tốc độ cao để lưu trữ trọng số và tokenizer.
Kiến trúc đề xuất & Cấu hình phần cứng
Đối với môi trường xử lý khoảng 100 đến 250 request mỗi giây, hãy hướng tới cấu hình tối thiểu sau:
- Triển khai trên GPU (Khuyến nghị): 1x GPU NVIDIA có từ 8 GB VRAM trở lên (RTX 3060, RTX 4060 Ti, hoặc cloud T4/L4), 4 CPU core và 16 GB RAM hệ thống.
- Phương án thay thế bằng CPU: 8 vCPU core (Intel Xeon Ice Lake hoặc AMD EPYC có tập lệnh mở rộng AVX-512) và 16 GB RAM kết hợp lượng tử hóa INT8.
- Hệ điều hành máy chủ: Ubuntu 22.04 LTS hoặc 24.04 LTS đi kèm Docker Engine và Docker Compose v2.
- Driver: NVIDIA Driver 535+ và NVIDIA Container Toolkit.
- Cặp mô hình kết hợp:
- Embedding:
BAAI/bge-small-en-v1.5(384 chiều, trọng số ~133MB) để tìm kiếm vector siêu nhanh. Sử dụngBAAI/bge-m3(1024 chiều) nếu bắt buộc phải hỗ trợ đa ngôn ngữ. - Reranker:
BAAI/bge-reranker-base(trọng số ~1.1GB) hoặcmixedbread-ai/mxbai-rerank-base-v1.
- Embedding:
Hướng dẫn triển khai từng bước với Docker Compose
Bước 1: Cấu hình NVIDIA Container Toolkit
Bỏ qua bước này nếu bạn chỉ chạy thuần trên CPU. Để tăng tốc bằng GPU, hãy đăng ký repository của NVIDIA và thiết lập runtime mặc định cho Docker:
# Thêm repository NVIDIA Container Toolkit
curl -fsSL https://nvidia.github.io/libnvidia-container/gpgkey | sudo gpg --dearmor -o /usr/share/keyrings/nvidia-container-toolkit-keyring.gpg \
  && curl -s -L https://nvidia.github.io/libnvidia-container/stable/deb/nvidia-container-toolkit.list | \
    sed 's#deb https://#deb [signed-by=/usr/share/keyrings/nvidia-container-toolkit-keyring.gpg] https://#g' | \
    sudo tee /etc/apt/sources.list.d/nvidia-container-toolkit.list

sudo apt-get update
sudo apt-get install -y nvidia-container-toolkit
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker
Bước 2: Định nghĩa Docker Compose Stack
Tạo một thư mục làm việc cho Infinity và mở file cấu hình compose mới:
mkdir -p ~/infinity-stack && cd ~/infinity-stack
nano docker-compose.yml
Dán nội dung định nghĩa service sau vào file. Cấu hình này sẽ tải cả mô hình embedding và cross-encoder vào một engine chung sử dụng độ chính xác nửa (FP16):
services:
  infinity:
    image: michaelf34/infinity:latest
    container_name: infinity-inference
    restart: unless-stopped
    ports:
      - "7997:7997"
    environment:
      - INFINITY_MODEL_ID=BAAI/bge-small-en-v1.5;BAAI/bge-reranker-base
      - INFINITY_BATCH_SIZE=64
      - INFINITY_API_KEY=sk-inf-local-secret-key-9923
      - INFINITY_DTYPE=float16
    volumes:
      - ./cache:/root/.cache/huggingface
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]
Bạn chạy trên CPU? Hãy xóa toàn bộ khối deploy, sau đó đổi INFINITY_DTYPE thành int8 hoặc float32.
Bước 3: Khởi chạy service và kiểm tra trạng thái
Khởi chạy container ở chế độ chạy ngầm và theo dõi tiến trình tải mô hình:
docker compose up -d
docker compose logs -f infinity
Trong lần chạy đầu tiên, Infinity sẽ tải trọng số mô hình từ Hugging Face về thư mục ./cache. Sau khi trọng số được compile và warm-up xong, log sẽ xác nhận trạng thái sẵn sàng:
INFO: Started server process on http://0.0.0.0:7997
INFO: Application startup complete. Ready for requests.
Bước 4: Gửi truy vấn kiểm tra các endpoint cục bộ
Đầu tiên, kiểm tra khả năng sinh vector bằng cấu trúc payload chuẩn của OpenAI:
curl http://localhost:7997/v1/embeddings \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer sk-inf-local-secret-key-9923" \
  -d '{
    "model": "BAAI/bge-small-en-v1.5",
    "input": ["Embedding tự host giúp giảm độ trễ mạng về gần như bằng không."]
  }'
Tiếp theo, truyền danh sách các tài liệu ứng viên vừa truy xuất vào reranker. Endpoint này sẽ tính điểm độ liên quan và trả về các chỉ mục đã được sắp xếp:
curl http://localhost:7997/v1/rerank \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer sk-inf-local-secret-key-9923" \
  -d '{
    "model": "BAAI/bge-reranker-base",
    "query": "Làm thế nào để giảm thời gian phản hồi khi tìm kiếm vector?",
    "documents": [
      "Dynamic batching liên tục trong Infinity giúp tối ưu hóa việc sử dụng GPU.",
      "Cà phê cold brew cần ủ mười sáu tiếng ở nhiệt độ phòng.",
      "Chỉ mục HNSW giúp tăng tốc tra cứu láng giềng gần đúng."
    ],
    "top_n": 2
  }'
Bước 5: Kết nối ứng dụng Python của bạn
Vì Infinity tuân thủ chính xác schema của OpenAI, thư viện openai chuẩn có thể hoạt động được ngay mà không cần viết thêm adapter tùy chỉnh nào.
from openai import OpenAI

# Trỏ client tới máy chủ Infinity cục bộ
client = OpenAI(
    base_url="http://localhost:7997/v1",
    api_key="sk-inf-local-secret-key-9923"
)

def embed_documents(texts: list[str]) -> list[list[float]]:
    response = client.embeddings.create(
        model="BAAI/bge-small-en-v1.5",
        input=texts
    )
    return [record.embedding for record in response.data]

sample_chunks = [
    "Inference tự host giúp giảm thời gian truy xuất p95 xuống còn 12ms.",
    "Cross-encoder lọc chính xác các kết quả khớp vector dương tính giả."
]

vectors = embed_documents(sample_chunks)
print(f"Đã tạo {len(vectors)} embedding | Kích thước vector: {len(vectors[0])} chiều")
Việc triển khai Infinity đặt cạnh cơ sở dữ liệu giúp rút ngắn thời gian truy xuất xuống chỉ còn 10–15ms. Bạn sẽ hoàn toàn loại bỏ sự phụ thuộc vào API bên thứ ba, bảo vệ an toàn dữ liệu nhạy cảm và nắm toàn quyền kiểm soát hiệu năng hệ thống RAG của mình.