Bối cảnh & Lý do
Tìm kiếm vector ngữ nghĩa (semantic vector search) không phải là viên đạn bạc cho các hệ thống RAG (Retrieval-Augmented Generation) trên môi trường production. Dense embedding dễ dàng nắm bắt được ý định tổng quát, cách diễn đạt thông tục và ý nghĩa đa ngôn ngữ. Tuy nhiên, chúng lại xử lý rất kém trước các dữ liệu kỹ thuật đòi hỏi tính chính xác tuyệt đối. Nếu đưa vào mô hình embedding một mã SKU chuẩn xác như SKU-4821-X, mã Jira ticket như SEC-4091, hay mã lỗi PostgreSQL như 42P01, mô hình thường sẽ sinh ra kết quả ảo (hallucinate) hoặc trả về các tài liệu chỉ liên quan mơ hồ thay vì kết quả khớp chính xác.
Phương pháp truy xuất từ khóa truyền thống giải quyết triệt để vấn đề độ chính xác này. Tính năng Full-Text Search (FTS) tích hợp sẵn của PostgreSQL tận dụng inverted index để tìm kiếm chính xác từng từ chỉ trong vài mili-giây. Điểm hạn chế duy nhất? FTS hoàn toàn không hiểu từ đồng nghĩa và cách diễn đạt linh hoạt của người dùng. Hãy thử tìm kiếm "how to repair a flat tyre", và một chỉ mục FTS đánh trên các tài liệu chứa cụm từ "fixing a punctured tire" sẽ không mang lại bất kỳ kết quả nào.
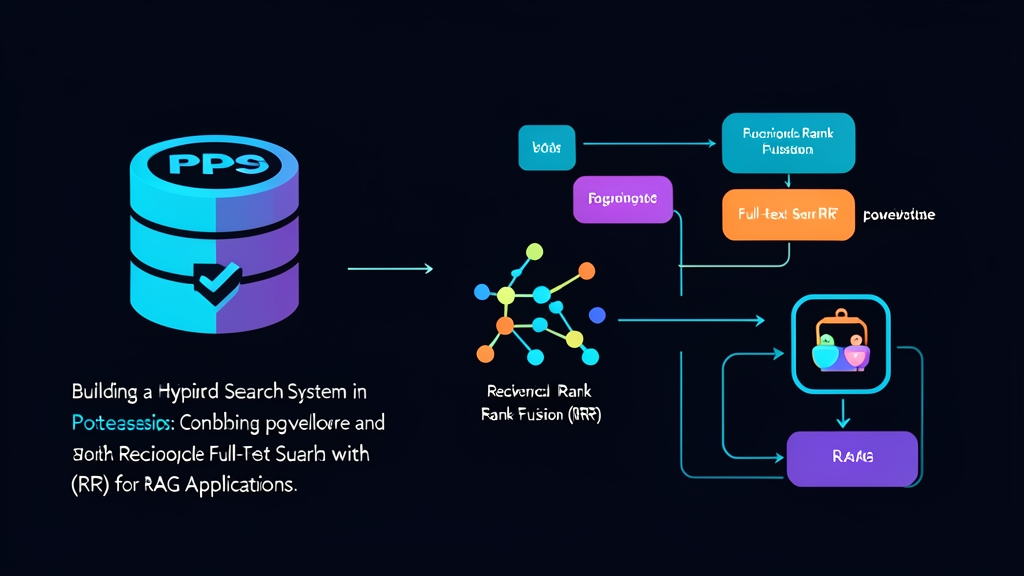
Tìm kiếm kết hợp (Hybrid search) xóa bỏ rào cản này. Bạn thực hiện đồng thời cả truy vấn từ khóa lẫn truy vấn vector, sau đó hợp nhất các kết quả hàng đầu thành một danh sách ứng viên duy nhất.
Tuy nhiên, việc kết hợp điểm số thô (raw score) giữa hai phương pháp lại là một cái bẫy kỹ thuật kinh điển. Khoảng cách vector (cosine distance dao động từ 0.0 đến 2.0) tuân theo một phân phối thống kê hoàn toàn khác so với điểm từ khóa như ts_rank (số thực không giới hạn). Việc gán trọng số theo cảm tính kiểu 0.7 * vector + 0.3 * fts sẽ đổ vỡ ngay khi bạn thêm tài liệu mới hoặc thay đổi mô hình embedding.
Reciprocal Rank Fusion (RRF) giúp bạn vượt qua rào cản căn chỉnh điểm số thủ công. Thay vì cân bằng các điểm số liên quan tùy ý, RRF đánh giá thứ hạng của từng tài liệu trên từng cơ chế truy xuất. Công thức của RRF vô cùng đơn giản:
RRF_Score(d) = Σ (1 / (k + rank(d)))Trong đó, rank(d) là thứ hạng của tài liệu trong danh sách kết quả (bắt đầu từ 1), còn k là một hằng số làm mượt (smoothing constant). Các benchmark trong truy xuất thông tin thường đặt k = 60 để tránh việc thứ hạng #1 cá biệt chiếm ưu thế tuyệt đối. Lấy ví dụ một tài liệu xếp hạng #1 trong tìm kiếm vector và #4 trong full-text search.
Điểm tổng hợp của nó sẽ là (1 / (60 + 1)) + (1 / (60 + 4)) = 0.01639 + 0.01562 = 0.03201. Những tài liệu đạt thứ hạng cao ở cả hai công cụ sẽ nhanh chóng vươn lên đầu bảng. Đồng thời, những tài liệu chỉ được tìm thấy bởi một pipeline duy nhất vẫn có cơ hội công bằng để lọt vào context cuối cùng của prompt.
Việc gom cả vector lẫn văn bản vào trong PostgreSQL còn giúp tinh gọn đáng kể hạ tầng của bạn. Bạn loại bỏ được race condition khi ghi đồng thời (dual-write), không cần đồng bộ dữ liệu với các cơ sở dữ liệu vector bên thứ ba như Pinecone hay Qdrant, và giữ nguyên vẹn ranh giới giao dịch (transaction boundary).
Cài đặt
Bạn cần PostgreSQL phiên bản 15 hoặc 16 cùng với extension pgvector. Docker là lựa chọn gọn gàng nhất cho môi trường phát triển cục bộ và kiểm thử CI:
# Khởi chạy PostgreSQL 16 với pgvector được cài đặt sẵn
docker run -d \
  --name postgres-hybrid \
  -e POSTGRES_USER=appuser \
  -e POSTGRES_PASSWORD=secretpassword \
  -e POSTGRES_DB=rag_knowledgebase \
  -p 5432:5432 \
  pgvector/pgvector:pg16
Với các máy chủ vật lý hoặc máy ảo chạy Ubuntu 22.04 hay 24.04, bạn có thể lấy các file nhị phân đã biên dịch sẵn trực tiếp từ kho lưu trữ PGDG chính thức:
sudo apt update
sudo apt install -y postgresql-16-pgvector
Kết nối tới database mục tiêu qua psql và kích hoạt extension:
CREATE EXTENSION IF NOT EXISTS vector;Cấu hình
Một schema tìm kiếm kết hợp cho production sẽ ghép nối văn bản thô với hai công cụ tìm kiếm: một cột tsvector được tạo tự động cho việc tra cứu từ khóa và một cột vector có số chiều cố định dành cho embedding.
1. Định nghĩa Schema
CREATE TABLE documents (
    id BIGSERIAL PRIMARY KEY,
    title TEXT NOT NULL,
    content TEXT NOT NULL,
    tsv TSVECTOR GENERATED ALWAYS AS (
        setweight(to_tsvector('english', coalesce(title, '')), 'A') ||
        setweight(to_tsvector('english', coalesce(content, '')), 'B')
    ) STORED,
    embedding VECTOR(1536) -- Phù hợp với OpenAI text-embedding-3-small
);
Mệnh đề GENERATED ALWAYS AS ... STORED tự động tính toán các lexical token sau mỗi thao tác INSERT hoặc UPDATE. Hàm setweight gán trọng số ưu tiên ‘A’ cho tiêu đề cao hơn nội dung (‘B’), mang lại lợi thế xếp hạng tự nhiên cho các kết quả khớp ở tiêu đề.
2. Chiến lược đánh chỉ mục (Indexing)
Độ trễ thấp là yếu tố sống còn. Nếu không có chỉ mục chuyên dụng, PostgreSQL sẽ quét tuần tự (sequential scan) cả 500.000 dòng cho cả hai truy vấn, khiến thời gian phản hồi API sụt giảm nghiêm trọng:
-- Chỉ mục Generalized Inverted Index (GIN) cho bộ lọc từ khóa
CREATE INDEX idx_documents_tsv ON documents USING GIN(tsv);

-- Chỉ mục Hierarchical Navigable Small World (HNSW) cho khoảng cách cosine
CREATE INDEX idx_documents_embedding_hnsw ON documents
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);
Hãy ưu tiên chọn HNSW thay vì IVFFlat cho các tập dữ liệu RAG trên production. IVFFlat đòi hỏi phải huấn luyện trước theo batch và suy giảm độ hồi quy (recall) khi tài liệu được thêm vào linh hoạt. Ngược lại, HNSW xây dựng theo cơ chế lặp (iterative), mang lại độ recall trên 95% ngay khi dùng với độ trễ ổn định có thể dự đoán được.
3. Nạp dữ liệu (Data Ingestion)
Làm sạch dữ liệu thô xuất ra thường tốn nhiều thời gian. Nếu bạn cần chuyển đổi nhanh các bản trích xuất CSV sang JSON có cấu trúc để insert hàng loạt, các tiện ích chạy trên trình duyệt như toolcraft.app/vi/tools/data/csv-to-json sẽ xử lý file ngay tại máy cục bộ mà không gửi dữ liệu nhạy cảm qua mạng. Khi đã có cấu trúc, hãy nạp tài liệu bằng lệnh COPY của PostgreSQL hoặc sử dụng batch insert có tham số trong Python.
4. Truy vấn Reciprocal Rank Fusion (RRF)
Bạn có thể thực thi RRF hoàn toàn bên trong PostgreSQL bằng cách sử dụng Common Table Expression (CTE) và ROW_NUMBER(). Truy vấn này lấy ra 60 ứng viên hàng đầu từ mỗi nhánh và hợp nhất chúng thành tập kết quả top 10 đã được chuẩn hóa:
WITH vector_candidates AS (
    SELECT
        id,
        title,
        content,
        ROW_NUMBER() OVER (ORDER BY embedding <=> '[0.012, -0.045, ... điền 1536 số thực ... ]'::vector) AS rank
    FROM documents
    ORDER BY embedding <=> '[0.012, -0.045, ... điền 1536 số thực ... ]'::vector
    LIMIT 60
),
text_candidates AS (
    SELECT
        id,
        title,
        content,
        ROW_NUMBER() OVER (ORDER BY ts_rank_cd(tsv, plainto_tsquery('english', 'database connection timeout')) DESC) AS rank
    FROM documents
    WHERE tsv @@ plainto_tsquery('english', 'database connection timeout')
    ORDER BY ts_rank_cd(tsv, plainto_tsquery('english', 'database connection timeout')) DESC
    LIMIT 60
)
SELECT
    COALESCE(v.id, t.id) AS id,
    COALESCE(v.title, t.title) AS title,
    COALESCE(v.content, t.content) AS content,
    (
        COALESCE(1.0 / (60 + v.rank), 0.0) +
        COALESCE(1.0 / (60 + t.rank), 0.0)
    ) AS rrf_score
FROM vector_candidates v
FULL OUTER JOIN text_candidates t ON v.id = t.id
ORDER BY rrf_score DESC
LIMIT 10;
Hãy chú ý đến phép FULL OUTER JOIN. Nó giữ lại các tài liệu chỉ được tìm thấy bởi một phương pháp duy nhất, đồng thời cộng dồn điểm số thưởng cho các tài liệu xuất hiện ở cả hai nhánh.
5. Hàm truy xuất Python cho RAG
Dưới đây là mã tích hợp hoàn chỉnh từ đầu đến cuối sử dụng thư viện psycopg (v3) hiện đại. Chú ý cách chúng ta định dạng danh sách embedding thành chuỗi ký tự vector trong PostgreSQL:
import psycopg
from psycopg.rows import dict_row

def hybrid_search(
    db_url: str,
    query_text: str,
    query_embedding: list[float],
    limit: int = 5
) -> list[dict]:
    # Chuyển đổi mảng số thực float sang định dạng chuỗi pgvector literal '[0.012,-0.045,...]'
    vector_str = f"[{','.join(map(str, query_embedding))]}"

    sql = """
    WITH vector_candidates AS (
        SELECT id, title, content,
               ROW_NUMBER() OVER (ORDER BY embedding <=> %s::vector) AS rank
        FROM documents
        ORDER BY embedding <=> %s::vector
        LIMIT 60
    ),
    text_candidates AS (
        SELECT id, title, content,
               ROW_NUMBER() OVER (ORDER BY ts_rank_cd(tsv, plainto_tsquery('english', %s)) DESC) AS rank
        FROM documents
        WHERE tsv @@ plainto_tsquery('english', %s)
        ORDER BY ts_rank_cd(tsv, plainto_tsquery('english', %s)) DESC
        LIMIT 60
    )
    SELECT
        COALESCE(v.id, t.id) AS id,
        COALESCE(v.title, t.title) AS title,
        COALESCE(v.content, t.content) AS content,
        (
            COALESCE(1.0 / (60 + v.rank), 0.0) +
            COALESCE(1.0 / (60 + t.rank), 0.0)
        ) AS rrf_score
    FROM vector_candidates v
    FULL OUTER JOIN text_candidates t ON v.id = t.id
    ORDER BY rrf_score DESC
    LIMIT %s;
    """

    with psycopg.connect(db_url, row_factory=dict_row) as conn:
        with conn.cursor() as cur:
            cur.execute(
                sql,
                (vector_str, vector_str, query_text, query_text, query_text, limit)
            )
            return cur.fetchall()
Xác minh & Giám sát
Sau khi dựng xong pipeline, hãy kiểm tra độ liên quan của kết quả truy xuất và đo lường độ trễ truy vấn khi chịu tải đồng thời.
Kiểm tra tính chính xác của cơ chế truy xuất
Hãy chạy hai bài kiểm tra nhanh này trên chỉ mục để đảm bảo RRF xếp hạng hợp lý cho cả hai phương thức tìm kiếm:
- Bài kiểm tra mã lỗi/SKU chính xác: Truy vấn bằng một định danh đặc thù như
ORA-00942hoặcERR-CONN-503. Pipeline tìm kiếm văn bản sẽ phải đưa đúng bản ghi log đó lên vị trí #1, lấn át hoàn toàn độ lệch ngữ nghĩa từ mô hình embedding. - Bài kiểm tra từ đồng nghĩa theo khái niệm: Tìm kiếm bằng một câu hỏi trừu tượng không chứa từ khóa trùng khớp trực tiếp, ví dụ: "how do I prevent connection exhaustion in high concurrency web services?". Hãy xác nhận rằng các bài viết hướng dẫn về connection pooler như PgBouncer sẽ được đưa lên đầu thông qua nhánh tìm kiếm vector.
Phân tích kế hoạch thực thi truy vấn (Query Plan)
Kiểm tra đường dẫn thực thi bên trong psql bằng lệnh EXPLAIN (ANALYZE, BUFFERS):
EXPLAIN (ANALYZE, BUFFERS)
WITH vector_candidates AS (...) ...
Hãy chú ý ba điểm mấu chốt trong kết quả trả về:
- CTE ứng viên văn bản phải hiển thị
Bitmap Index Scan on idx_documents_tsv. Nếu bạn thấySeq Scan, hãy kiểm tra lại thông sốwork_memvà đảm bảoenable_seqscankhông bị ép bật. - CTE ứng viên vector phải báo cáo
Index Scan using idx_documents_embedding_hnsw. - Tổng thời gian thực thi chỉ nên dao động từ 4ms đến 15ms trên một bảng chứa 500.000 tài liệu đã được đánh chỉ mục.
Giám sát và tinh chỉnh Cache
Đồ thị HNSW rất ngốn bộ nhớ RAM. Nếu máy chủ của bạn buộc phải đọc các phân đoạn chỉ mục từ ổ đĩa NVMe hoặc block storage chậm chạp cho mỗi truy vấn, độ trễ sẽ tăng vọt từ 8ms lên hơn 120ms.
-- Kiểm tra dung lượng lưu trữ trên đĩa của bảng documents và các chỉ mục
SELECT
    c.relname AS object_name,
    pg_size_pretty(pg_relation_size(c.oid)) AS table_size,
    pg_size_pretty(pg_total_relation_size(c.oid)) AS total_size
FROM pg_class c
JOIN pg_namespace n ON n.oid = c.relnamespace
WHERE n.nspname = 'public' AND c.relname = 'documents';
Với 250.000 vector có 1536 chiều, chỉ mục HNSW sẽ tiêu tốn khoảng 1,8 GB RAM. Hãy tinh chỉnh file postgresql.conf để đảm bảo chỉ mục nằm vừa vặn trong bộ nhớ cache:
# Đảm bảo shared_buffers đủ lớn cho các bảng hoạt động và cấu trúc chỉ mục HNSW
shared_buffers = 4GB

# Cấp phát working memory cho các window function và thao tác sắp xếp CTE
work_mem = 64MB

# Thiết lập độ sâu tìm kiếm HNSW (mặc định là 40; 80-100 mang lại recall >98% ở độ trễ ~10ms)
# Bạn cũng có thể thiết lập động theo từng kết nối: SET hnsw.ef_search = 100;
hnsw.ef_search = 80
Việc lưu trữ cả dữ liệu quan hệ lẫn vector embedding ngay trong PostgreSQL giúp loại bỏ những phức tạp không cần thiết khỏi kiến trúc RAG của bạn. Bạn có được sự an toàn của chuẩn ACID, triệt tiêu tình trạng lệch dữ liệu (data drift), và đạt tốc độ truy xuất kết hợp dưới 15ms mà không cần vận hành thêm bất kỳ microservice cơ sở dữ liệu vector bên ngoài nào.