Vấn đề đặt ra: Cạm bẫy lưu trữ trong môi trường Kubernetes ảo hóa
Khởi tạo một cụm K3s đa node trên Proxmox VE là kiến trúc quen thuộc cho các mô hình lab tại nhà (homelab), chi nhánh và node biên (edge node). Tuy nhiên, các workload có trạng thái (stateful)—như PostgreSQL, Nextcloud hay Prometheus—thường gặp bế tắc mỗi khi bảo trì. K3s sử dụng Rancher Local Path Provisioner theo mặc định. Bộ provisioner này nhanh và tốn rất ít tài nguyên, nhưng nó lại gắn chặt dữ liệu persistent vào trực tiếp filesystem của máy chủ nơi pod khởi chạy lần đầu thông qua hostPath.
Chỉ cần khởi động lại máy ảo Proxmox để cập nhật kernel, vấn đề sẽ xuất hiện ngay lập tức. Node hypervisor reboot, và Kubernetes lập lịch chuyển pod của bạn sang một worker node còn hoạt động. Do dữ liệu thô vẫn bị kẹt trên ổ đĩa ảo của máy ảo đã tắt nguồn, pod mới sẽ rơi vào trạng thái bế tắc CrashLoopBackOff hoặc Pending. Tính sẵn sàng cao (HA) thực sự đòi hỏi một giải pháp lưu trữ dạng khối (block storage) phân tán có khả năng mirror các thao tác ghi đĩa qua mạng tới các node độc lập khác nhau.
Các khái niệm cốt lõi: Cách Longhorn vận hành hệ thống lưu trữ khối phân tán
Longhorn là nền tảng lưu trữ dạng khối phân tán dung lượng nhẹ được thiết kế chuyên biệt cho Kubernetes. Nó chạy trực tiếp bên trong cụm dưới dạng các microservice native. Khác với Ceph vốn thường đòi hỏi từ 2 đến 4 GB RAM cho mỗi daemon OSD cộng thêm các node lưu trữ chuyên dụng, Longhorn hoạt động nhẹ nhàng chỉ với khoảng 1 đến 1.5 GB RAM mỗi node cho toàn bộ control plane và data engine.
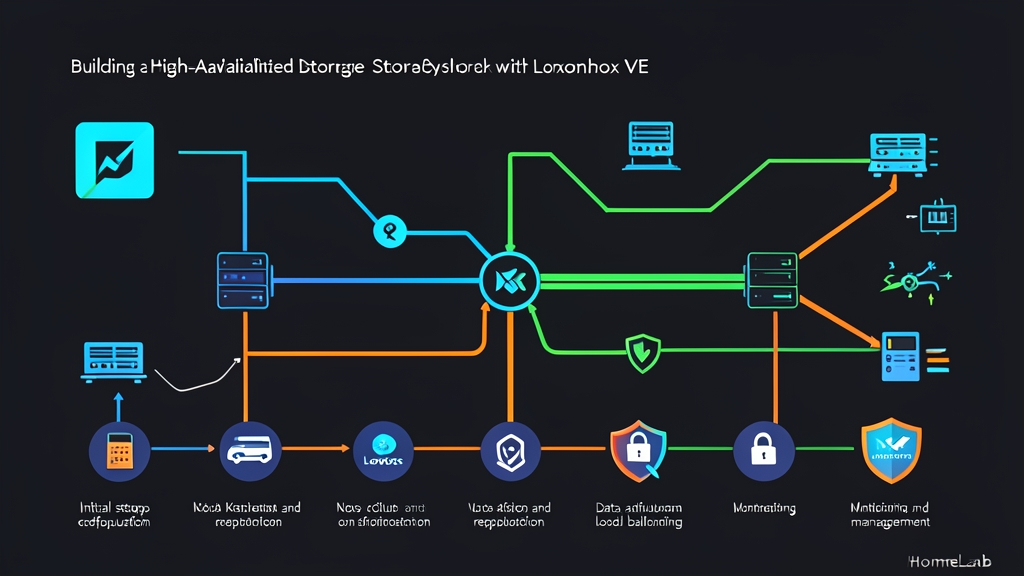
Longhorn phân chia kiến trúc quản lý lưu trữ thành ba tầng cốt lõi:
- Longhorn CSI Plugin: Tích hợp với Container Storage Interface của Kubernetes để cấp phát các PersistentVolume (PV), gắn (attach) thiết bị và điều phối snapshot volume.
- Longhorn Engine: Một pod controller gọn nhẹ được tạo động cho từng volume được gắn. Nó điều phối luồng dữ liệu và đóng vai trò như một endpoint iSCSI phục vụ trực tiếp cho worker node cục bộ.
- Longhorn Replicas: Các tầng lưu trữ khối dạng thin-provisioning được phân bổ trên các node riêng biệt trong cụm. Theo mặc định, Longhorn cấu hình 3 replica cho mỗi volume. Khi một ứng dụng thực hiện thao tác ghi, engine sẽ đồng bộ phát dữ liệu tới cả ba replica trước khi trả về tín hiệu hoàn tất I/O.
Trên Proxmox VE, mỗi máy ảo chuyển tiếp một ổ đĩa ảo đính kèm vào storage pool. Để đạt thông lượng tối ưu cũng như dọn dẹp dung lượng (garbage collection) hiệu quả, hãy cấu hình các ổ đĩa này trên bộ điều khiển VirtIO SCSI Single và bật discard=on. Khi một máy chủ hypervisor gặp sự cố, engine vẫn tiếp tục xử lý các tác vụ đọc/ghi thông qua các replica còn lại đang hoạt động.
Thực hành: Triển khai và kiểm thử hệ thống lưu trữ HA
Mô hình triển khai này giả định bạn có ba máy ảo Proxmox chạy Ubuntu 22.04 hoặc Debian 12 đã cài sẵn K3s (k3s-node-01, k3s-node-02, k3s-node-03). Mỗi máy ảo có 4 vCPU, 8 GB RAM và một ổ đĩa ảo phụ dung lượng 50 GB tại /dev/sdb được định dạng ext4 và mount vào /var/lib/longhorn. Đối với lưu lượng replication trong cụm, hãy sử dụng ít nhất mạng chuyên dụng 1 GbE; giao diện mạng 2.5 GbE hoặc 10 GbE sẽ giúp độ trễ ghi duy trì dưới mức 5 ms.
Bước 1: Cài đặt các gói phụ thuộc trên toàn bộ các node
Longhorn quản lý các thiết bị khối thô thông qua iSCSI và phụ thuộc vào các công cụ NFS để xử lý target backup. Hãy chạy lệnh cài đặt sau trên từng node K3s:
sudo apt-get update && sudo apt-get install -y open-iscsi nfs-common util-linux bash curl
sudo systemctl enable iscsid && sudo systemctl start iscsid
Kiểm tra xem tất cả các kernel module—bao gồm iscsi_tcp và dm_crypt—đã hoạt động hay chưa bằng cách chạy script kiểm tra môi trường chính thức của Longhorn:
curl -sSfL https://raw.githubusercontent.com/longhorn/longhorn/v1.6.1/scripts/environment_check.sh | bashBước 2: Triển khai Longhorn bằng Helm
Thêm repository chính thức của Longhorn bằng Helm trên control-plane node của bạn:
helm repo add longhorn https://charts.longhorn.io
helm repo update
Tạo một file cấu hình tinh chỉnh có tên là longhorn-values.yaml. Thiết lập replicaSoftAntiAffinity: false để đảm bảo các replica không bao giờ nằm chung trên một máy ảo, từ đó ép buộc phân tách nghiêm ngặt giữa các node:
persistence:
  defaultClass: true
  defaultClassReplicaCount: 3
defaultSettings:
  defaultDataPath: /var/lib/longhorn
  storageOverProvisioningPercentage: 150
  storageMinimalAvailablePercentage: 15
  replicaSoftAntiAffinity: false
Tiến hành cài đặt vào namespace riêng biệt longhorn-system:
helm install longhorn longhorn/longhorn \
  --namespace longhorn-system \
  --create-namespace \
  -f longhorn-values.yaml
Theo dõi quá trình khởi chạy pod cho đến khi các manager và CSI driver đạt trạng thái ready:
kubectl -n longhorn-system get pods -wBước 3: Triển khai workload có trạng thái với cơ chế replicate dữ liệu
Để kiểm tra khả năng sao chép đồng bộ, hãy triển khai một pod thử nghiệm được cấu hình toleration tùy chỉnh khi bị trục xuất (eviction). Việc bổ sung toleration cho node.kubernetes.io/unreachable giúp rút ngắn thời gian trễ khi failover từ mức mặc định 300 giây của Kubernetes xuống còn 10 giây.
Lưu cấu hình sau thành file ha-storage-test.yaml:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: longhorn-test-pvc
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: longhorn
  resources:
    requests:
      storage: 5Gi
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: storage-writer
spec:
  replicas: 1
  selector:
    matchLabels:
      app: storage-writer
  template:
    metadata:
      labels:
        app: storage-writer
    spec:
      tolerations:
      - key: "node.kubernetes.io/unreachable"
        operator: "Exists"
        effect: "NoExecute"
        tolerationSeconds: 10
      - key: "node.kubernetes.io/not-ready"
        operator: "Exists"
        effect: "NoExecute"
        tolerationSeconds: 10
      containers:
      - name: writer
        image: busybox
        command: ["/bin/sh", "-c", "while true; do date >> /data/heartbeat.log; sleep 2; done"]
        volumeMounts:
        - name: data-volume
          mountPath: /data
      volumes:
      - name: data-volume
        persistentVolumeClaim:
          claimName: longhorn-test-pvc
Áp dụng manifest:
kubectl apply -f ha-storage-test.yamlKiểm tra PersistentVolumeClaim vừa tạo và xác minh sự phân bổ của các replica:
kubectl get pvc longhorn-test-pvc
VOL_NAME=$(kubectl get pvc longhorn-test-pvc -o jsonpath='{.spec.volumeName}')
kubectl -n longhorn-system get replicas -l longhornvolume=$VOL_NAME
Ba mục replica riêng biệt sẽ xuất hiện trong kết quả đầu ra, mỗi bản ghi tương ứng với một node K3s khác nhau.
Bước 4: Kiểm thử tính năng Failover và khả năng sống sót của node
Xác định worker VM nào hiện đang chạy writer pod:
kubectl get pod -l app=storage-writer -o wideGiả sử pod đang chạy trên k3s-node-02 (VM ID 102). Giả lập sự cố sập phần cứng đột ngột bằng cách tắt nóng máy ảo từ shell của Proxmox VE:
# Thực thi trực tiếp trên shell của máy chủ Proxmox
qm stop 102
Kubernetes sẽ chuyển trạng thái của k3s-node-02 sang NotReady trong vòng 40 giây. Nhờ cấu hình toleration của chúng ta, cụm sẽ dừng pod bị mất kết nối sau 10 giây và lập lịch tạo một pod thay thế trên k3s-node-01 hoặc k3s-node-03. Longhorn Engine sẽ gỡ (detach) volume instance cũ, gắn nó vào node thay thế và mount lại filesystem.
Xác nhận rằng quá trình ghi file vẫn tiếp tục mà không bị hỏng dữ liệu:
NEW_POD=$(kubectl get pod -l app=storage-writer -o jsonpath='{.items[0].metadata.name}')
kubectl exec -it $NEW_POD -- tail -n 10 /data/heartbeat.log
Kết quả đầu ra hiển thị các mốc thời gian ghi cách nhau 2 giây không hề bị gián đoạn trong suốt khoảng thời gian reboot, chứng minh không có bản ghi nào bị mất mát.
Kết luận
Sự kết hợp giữa K3s và Longhorn trên Proxmox VE giúp chuyển đổi mô hình lưu trữ persistent mong manh trên node đơn lẻ thành một nền tảng linh hoạt, có khả năng chịu lỗi cao. Các tình huống khởi động lại máy chủ, di chuyển máy ảo hay sự cố phần cứng bất ngờ sẽ không còn khiến trạng thái ứng dụng bị gián đoạn. Để phòng ngừa rủi ro mất dữ liệu trên toàn bộ hypervisor, hãy mở giao diện Longhorn UI và thiết lập lịch backup tự động tới một NFS export bên ngoài cụm hoặc một S3 bucket.