Vấn đề thực tế: Bùng nổ Telemetry và nguy cơ Vendor Lock-in trên Kubernetes
Hầu hết các cụm Kubernetes trong môi trường production đều bắt đầu khá tinh gọn. Bạn triển khai ba microservices, thu thập metrics bằng Prometheus, theo dõi container logs qua Fluent Bit và gắn thêm một SaaS APM agent để tracing. Ban đầu mọi thứ vận hành rất trơn tru. Nhưng rồi nền tảng dần mở rộng.
Chỉ trong vòng một năm, ba dịch vụ ban đầu đã nhân lên thành 40 deployment riêng biệt, trải dài trên tám namespace thuộc 20 worker node. Tình trạng phình to agent (agent bloat) nhanh chóng xuất hiện. Mỗi worker node phải chạy ba đến bốn sidecar và daemon agent, tiêu tốn tổng cộng từ 1,5 đến 2,5 GB RAM của node chỉ để vận chuyển dữ liệu telemetry.
Khi đội ngũ bảo mật yêu cầu che thông tin số thẻ tín dụng khỏi logs trước khi truyền đi, bạn nhận ra mỗi logging daemon lại đòi hỏi một cú pháp regex độc quyền riêng. Tệ hơn nữa, việc đánh giá một nền tảng thay thế nhằm cắt giảm hóa đơn giám sát 15.000 USD mỗi tháng lại đòi hỏi phải chỉnh sửa SDK trên hàng tá repository ứng dụng.
Sự bùng nổ mất kiểm soát đó gây ra ba điểm nghẽn tốn kém: lãng phí tài nguyên node, tiêu tốn hàng trăm USD phí truyền dữ liệu liên vùng (cross-AZ egress) từ các luồng telemetry dư thừa, và rơi vào bẫy vendor lock-in hoàn toàn.
Phân tích nguyên nhân gốc rễ: Khớp nối chặt chẽ trực tiếp với Backend
Tại sao các đội ngũ kỹ thuật lại vấp phải rào cản này? Vấn đề cốt lõi nằm ở sự liên kết chặt chẽ (tight coupling) giữa các workload tạo ra telemetry và các nền tảng tiêu thụ chúng.
Khi microservices gửi dữ liệu trực tiếp tới các endpoint bên ngoài, các cấu hình hạ tầng sẽ làm rối rắm logic của ứng dụng. Một ứng dụng chỉ nên ghi nhận các sự kiện nghiệp vụ và phát ra tín hiệu telemetry. Ứng dụng không nên phải xử lý nén gzip, cơ chế thử lại (backoff retries), bộ đệm theo lô (batch buffers) hay làm giàu metadata của Kubernetes.
Nếu thiếu một tầng định tuyến bên trong cụm (in-cluster routing layer), các đội ngũ sẽ phải đối mặt với ba rào cản kỹ thuật lớn:
- Định dạng dữ liệu không tương thích: Metrics, traces và logs sử dụng các quy ước đặt tên khác nhau (chẳng hạn như
service_nameso vớiservice.name), làm đứt gãy khả năng tương quan dữ liệu khi xảy ra sự cố. - Hoàn toàn không có khả năng làm sạch dữ liệu ở biên: Việc loại bỏ các span
/healthznhiễu hoặc che dữ liệu PII đòi hỏi phải sửa code trên từng dịch vụ hoặc phải tốn chi phí cho các quy tắc xử lý tại thời điểm tiếp nhận (ingest-time processing) của nhà cung cấp giải pháp giám sát. - Tần suất tạo/ngắt kết nối lớn và hao phí tài nguyên: Hàng trăm pod ứng dụng thiết lập các kết nối outbound TLS riêng lẻ, làm cạn kiệt giới hạn kết nối của NAT gateway và làm tăng vọt chi phí truyền dữ liệu giữa các zone.
So sánh kiến trúc: Ba chiến lược tiếp nhận dữ liệu
Trước khi viết các manifest, hãy đánh giá ba kiến trúc phổ biến để quản lý Kubernetes telemetry.
1. Direct In-App Exporters
Mỗi pod ứng dụng tích hợp một SDK độc quyền của nhà cung cấp và truyền dữ liệu trực tiếp đến các endpoint SaaS bên ngoài như Datadog, New Relic hoặc Dynatrace.
- Ưu điểm: Thiết lập ban đầu nhanh chóng cho các dịch vụ proof-of-concept ở giai đoạn đầu.
- Nhược điểm: Rơi vào bẫy vendor lock-in nghiêm trọng, hoàn toàn không có khả năng quản trị tập trung, và tiêu tốn thêm 50–100 MB bộ nhớ cho mỗi runtime của pod.
2. Phân mảnh theo từng Agent chuyên dụng (Prometheus + Fluent Bit + Jaeger Agent)
Các đội ngũ chạy các daemon mã nguồn mở chuyên biệt, riêng biệt trên mỗi node cho từng loại telemetry.
- Ưu điểm: Các công cụ trưởng thành, đã được kiểm chứng thực tế với tài liệu phong phú.
- Nhược điểm: Ba định dạng cấu hình riêng biệt, ba chu kỳ nâng cấp daemon độc lập, và không có khả năng tương quan ngữ cảnh liền mạch giữa trace và log.
3. OpenTelemetry Collector (Gateway & Pipeline hợp nhất)
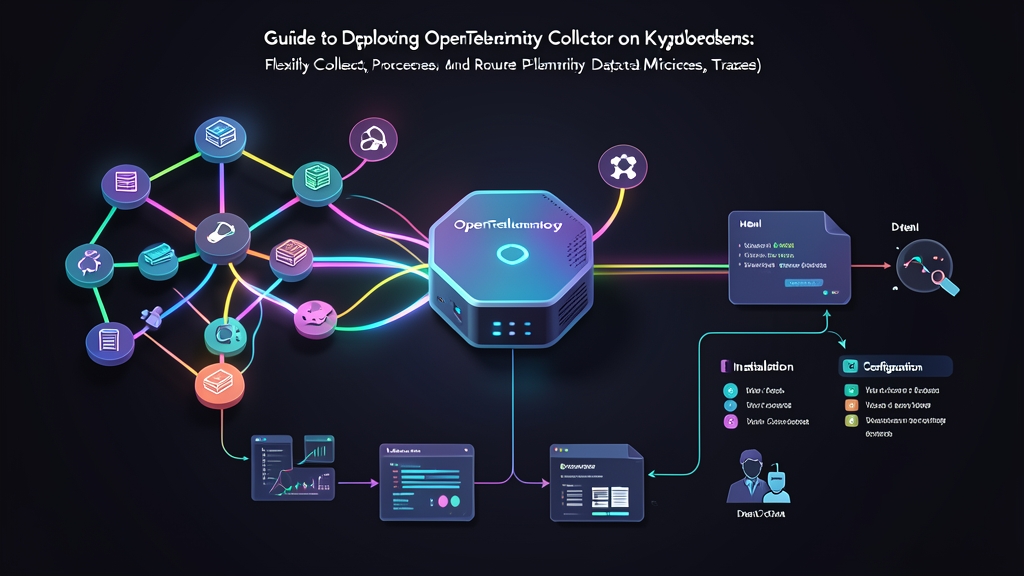
Một proxy trung lập duy nhất tiếp nhận telemetry thông qua các chuẩn mở (OTLP, Prometheus, Zipkin), xử lý dữ liệu ngay trong bộ nhớ và phân phối đến bất kỳ storage engine nào.
- Ưu điểm: Một pipeline YAML hợp nhất duy nhất, tự động chèn thuộc tính Kubernetes pod, lấy mẫu tập trung (centralized sampling) và chuyển đổi backend tức thì mà không cần cập nhật mã nguồn.
- Nhược điểm: Đòi hỏi thời gian làm quen với cú pháp pipeline của Collector và phải tinh chỉnh chính xác các ngưỡng memory limiter.
Mô hình khuyến nghị: Cấu trúc liên kết hai tầng Agent và Gateway
Đối với các môi trường Kubernetes production, kiến trúc lai hai tầng mang lại sự cân bằng tối ưu giữa hiệu năng và khả năng kiểm soát.
Chạy một DaemonSet gọn nhẹ trên mỗi node để thu thập metrics cgroup cục bộ và theo dõi container logs từ /var/log/pods. Node agent này sẽ định tuyến toàn bộ dữ liệu qua gRPC nội bộ tới một Deployment có khả năng tự động co giãn (autoscaling) hoạt động như một Gateway tập trung. Gateway sẽ xử lý các tác vụ nặng: truy vấn Kubernetes API server để lấy metadata của pod, áp dụng tail-based sampling, lọc PII và định tuyến đến các backend bên ngoài.
Bước 1: Thêm Helm Repository của OpenTelemetry
Sử dụng Helm chart chính thức của OpenTelemetry để đảm bảo việc triển khai có tính khai báo (declarative) và có thể tái lập trên nhiều môi trường:
helm repo add open-telemetry https://open-telemetry.github.io/opentelemetry-helm-charts
helm repo update
Bước 2: Cấu hình Collector Pipeline
Tạo file otel-collector-values.yaml tùy chỉnh. Collector pipeline tổ chức quá trình xử lý dữ liệu thành bốn thành phần: receivers (cách dữ liệu được tiếp nhận), processors (chuyển đổi và gom lô trong bộ nhớ), exporters (backend đích đến), và service pipelines (kết nối các thành phần lại với nhau).
mode: "deployment"
replicaCount: 2

resources:
  limits:
    cpu: 1000m
    memory: 1Gi
  requests:
    cpu: 250m
    memory: 512Mi

config:
  receivers:
    otlp:
      protocols:
        grpc:
          endpoint: 0.0.0.0:4317
        http:
          endpoint: 0.0.0.0:4318

  processors:
    memory_limiter:
      check_interval: 1s
      limit_percentage: 75
      spike_limit_percentage: 20

    batch:
      send_batch_size: 8192
      timeout: 1s

    k8sattributes:
      auth_type: "serviceAccount"
      passthrough: false
      extract:
        metadata:
          - k8s.pod.name
          - k8s.pod.uid
          - k8s.namespace.name
          - k8s.node.name
          - k8s.deployment.name
      pod_association:
        - sources:
            - type: ip

  exporters:
    debug:
      verbosity: basic
    otlp/jaeger:
      endpoint: "jaeger-collector.observability.svc.cluster.local:4317"
      tls:
        insecure: true
    prometheus:
      endpoint: "0.0.0.0:8889"
      namespace: "otel"

  service:
    pipelines:
      traces:
        receivers: [otlp]
        processors: [memory_limiter, k8sattributes, batch]
        exporters: [otlp/jaeger, debug]
      metrics:
        receivers: [otlp]
        processors: [memory_limiter, k8sattributes, batch]
        exporters: [prometheus]
      logs:
        receivers: [otlp]
        processors: [memory_limiter, k8sattributes, batch]
        exporters: [debug]
Hãy chú ý vị trí của memory_limiter, nó được đặt làm processor đầu tiên trong mỗi pipeline. Việc đặt lên đầu đảm bảo collector sẽ chủ động hạ tải trước khi tiêu tốn quá nhiều bộ nhớ và kích hoạt sự kiện OOMKill của Kubernetes.
Bước 3: Triển khai Gateway lên Kubernetes
Tạo namespace observability và cài đặt Helm chart với cấu hình vừa tạo:
kubectl create namespace observability

helm upgrade --install otel-collector open-telemetry/opentelemetry-collector \
  --namespace observability \
  -f otel-collector-values.yaml
Xác nhận các pod Gateway đang chạy và service nội bộ có thể truy cập được:
kubectl get pods -n observability -l app.kubernetes.io/name=opentelemetry-collector
kubectl get svc -n observability otel-collector
Bước 4: Cấu hình Workload với các biến OTLP tiêu chuẩn
Vì collector tiếp nhận các payload OTLP trung lập với nhà cung cấp, việc tích hợp công cụ đo lường vào workload không đòi hỏi bất kỳ đoạn mã đặc thù nào từ nhà cung cấp. Hãy truyền trực tiếp các biến môi trường OpenTelemetry tiêu chuẩn vào cấu hình pod của bạn:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: order-service
  namespace: default
spec:
  replicas: 2
  selector:
    matchLabels:
      app: order-service
  template:
    metadata:
      labels:
        app: order-service
    spec:
      containers:
        - name: app
          image: mycompany/order-service:1.2.0
          env:
            - name: OTEL_EXPORTER_OTLP_ENDPOINT
              value: "http://otel-collector.observability.svc.cluster.local:4317"
            - name: OTEL_EXPORTER_OTLP_PROTOCOL
              value: "grpc"
            - name: OTEL_SERVICE_NAME
              value: "order-service"
            - name: OTEL_RESOURCE_ATTRIBUTES
              value: "deployment.environment=production,service.version=1.2.0"
Bước 5: Kiểm tra việc tiếp nhận dữ liệu và làm giàu Metadata
Xem stream logs của collector pod để xác minh rằng traces, metrics và logs đang đi qua processor pipeline:
kubectl logs -n observability -l app.kubernetes.io/name=opentelemetry-collector -f --tail=50Bạn sẽ thấy các span gửi đến được gắn thêm các thông tin k8s.pod.name, k8s.namespace.name và service.version. Khi yêu cầu nghiệp vụ thay đổi, việc chuyển đổi đích đến—từ Jaeger sang Grafana Tempo, hay từ Prometheus sang Datadog—chỉ đơn giản là cập nhật cấu hình exporter. Các deployment ứng dụng của bạn hoàn toàn không bị ảnh hưởng.