想定外の本番障害
稼働中のデータベースでカラム名を変更することは、デプロイパイプラインが実行される瞬間までは一見些細な作業に思えます。PostgreSQLやMySQLに対してALTER TABLEによるマイグレーションを実行した数秒後、DatadogやGrafanaのダッシュボードにHTTP 500エラーのスパイクが発生します。ユーザーセッションは切断され、データベースのコネクションプールは枯渇し、アクティブなトランザクションが次々とロールバックに追い込まれます。
なぜこのような事態が起こるのでしょうか?多くのデプロイスクリプトは、アプリケーションコードとデータベーススキーマの更新がまったく同じミリ秒で同時に反映されることを前提としています。しかし現実には、現代のクラウドデプロイはKubernetesのPodやAuto ScalingされるEC2クラスター上でローリングアップデートとして実行されます。数分間にわたり、旧バージョンのインスタンスが新バージョンと並行してトラフィックを処理し続けます。古いコードが依然として旧カラムを参照している最中に、スキーマ側でカラムを削除またはリネームしてしまうと、それらのリクエストはその場で即座にエラーとなります。
リレーショナルデータベースは、すべてのアクティブな接続に対してスキーマを厳格に適用します。稼働中のサービスがSELECT full_name FROM usersを実行したとき、マイグレーションによってカラム名がnameに変更された直後であれば、そのクエリはcolumn "full_name" does not existというエラーで失敗します。
深夜2時のメンテナンス時間を設定することは社内向けツールなら許容されるかもしれませんが、99.99%のSLAを掲げる顧客向けプラットフォームでは不可能です。継続的な変更を安全にデプロイするために、エンジニアリングチームはExpand and Contractパターン(パラレルランやフェーズドマイグレーションとも呼ばれます)を採用しています。
基本概念:Expand and Contractパターンの理解
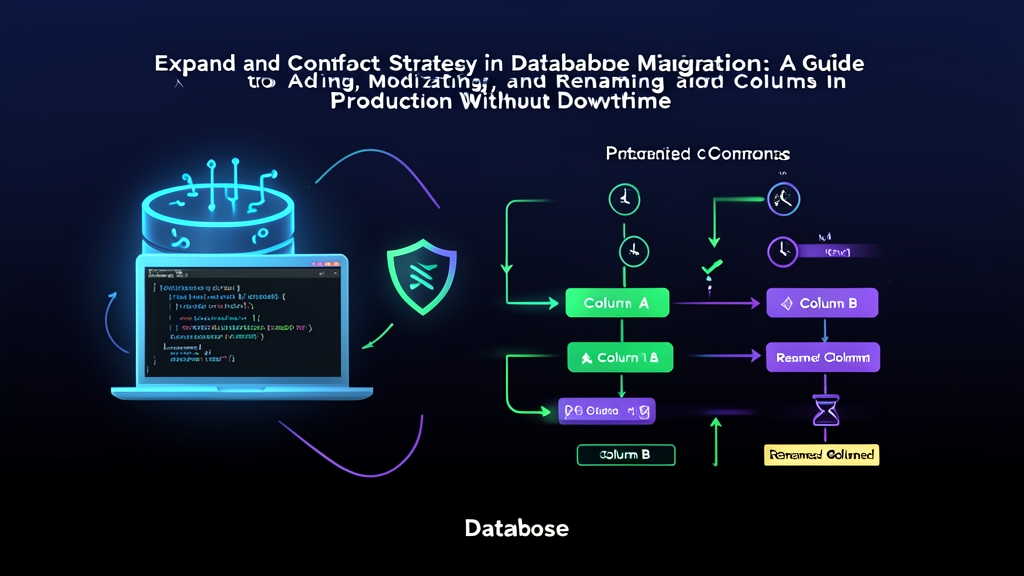
Expand and Contract戦略は、破壊的なスキーマ変更を下位互換性のある段階的なリリースに分割します。1回のリスクの高い操作を実行する代わりに、マイグレーションを個別のデプロイフェーズに切り分けます。これにより、古いコードと新しくリリースされたコードが摩擦なく共存できるようになります。
フェーズ1:Expand(拡張)
まず、既存の構造に変更を加えたり削除したりすることなく、新しいスキーマ要素を追加します。カラムのリネームやデータ型の変更が必要な場合は、既存のカラムと並行して新しいカラムを作成します。この際、新しいカラムがNULLを許容するか、安全なデフォルト値を持つように設定してください。これで、データベースは現在のコードと次回以降のビルドの両方の要求を満たす状態になります。
フェーズ2:Transition(デュアルライトとバックフィル)
次に、中間フェーズ用のアプリケーションコードをリリースします。すべてのINSERTおよびUPDATE処理で、両方のフィールドに同時に書き込み(デュアルライト)を行います。アプリケーションの読み取り(READ)処理は、引き続き既存カラムから取得するか、フォールバックとして処理します。本番環境でこのデュアルライトロジックを動かしながら、バックグラウンドのワーカースクリプトによって既存の過去レコードを一定のチャンクごとに新しいカラムへコピー(バックフィル)します。
フェーズ3:Contract(縮小・クリーンアップ)
過去レコードの移行が100%完了したことを確認したら、アプリケーションの読み取り先を新しいカラムへ切り替えます。本番環境の負荷状況をモニタリングした後、コードベースから旧カラムへの参照をすべて削除します。最後に、データベーススキーマから古いカラムを削除(DROP)します。テーブルロックもサービスのパフォーマンス低下も発生せず、ユーザーのトランザクションが失われることもありません。
実践演習:ダウンタイムなしでカラム名を変更する
1,500万行のusersテーブルを持つECプラットフォームを例に考えてみましょう。現在のシステムでは電話番号がphone_numberに格納されています。国際的なE.164規格をサポートするために、このカラム名をcontact_phoneに変更する必要があります。
ステップ1:スキーマの拡張(Expand)
テーブルに新しいカラムを追加します。カラムは必ずNULLを許容するか、デフォルト値を設定してください。デフォルト値なしでNOT NULL制約を設定してしまうと、古いコードを実行している既存コンテナで新規ユーザー登録のたびに制約違反エラーが発生します。
-- PostgreSQL / MySQL (InnoDB)
ALTER TABLE users
ADD COLUMN contact_phone VARCHAR(32) DEFAULT NULL;
最近のPostgreSQL(バージョン11以降)やMySQL 8.0では、NULL許容カラムや固定のデフォルト値を持つカラムの追加はメタデータの変更のみで瞬時に完了します。稼働中の本番Podは中断することなくphone_numberへのクエリを継続できます。
ステップ2:デュアルライトのアプリケーションロジックをデプロイ
データアクセス層を更新し、変更をデプロイします。ユーザーがプロファイルを作成または変更するたびに、phone_numberとcontact_phoneの両方に書き込みます。クエリ時はまずcontact_phoneを参照し、まだバックフィルされていないレコードの場合はphone_numberへフォールバックします。
以下は、SQLAlchemyまたは生のSQLを使用したPythonでの実装例です。
def save_user_phone(db_session, user_id: int, phone: str):
    # デュアルライトにより新旧両世代のコード間で整合性を維持する
    query = """
        UPDATE users
        SET phone_number = :phone,
            contact_phone = :phone
        WHERE id = :id
    """
    db_session.execute(query, {"phone": phone, "id": user_id})
    db_session.commit()

def get_user_phone(db_session, user_id: int) -> str:
    query = """
        SELECT contact_phone, phone_number
        FROM users
        WHERE id = :id
    """
    row = db_session.execute(query, {"id": user_id}).fetchone()
    if not row:
        return ""

    # 新しいカラムを優先し、未設定の場合は旧カラムへフォールバック
    return row["contact_phone"] or row["phone_number"] or ""
このリリースをサーバー群にロールアウトします。これにより、新規顧客やプロファイル更新時に両方のカラムへデータが書き込まれるようになります。
ステップ3:バッチ処理による過去レコードのバックフィル
1,500万行に対して条件指定のないUPDATE users SET contact_phone = phone_number;を実行してはいけません。一括更新を行うと数百万行がロックされ、トランザクションログ(WALまたはundoログ)が肥大化し、メモリバッファが枯渇して、リードレプリカのレプリケーション遅延が急増します。代わりに、インデックスを活用した予測可能なバッチ単位でレコードを移行します。
#!/usr/bin/env bash
# キーセットページネーションを活用したpsqlによる分割バックフィルスクリプト
BATCH_SIZE=2000
LAST_ID=0

echo "バックフィルを開始します..."

while true; do
  # フルテーブルスキャンを避け、主キーインデックスを利用して取得・更新
  UPDATED_INFO=$(psql -d production_db -t -A -c "
    WITH batch AS (
      SELECT id FROM users
      WHERE id > $LAST_ID
        AND contact_phone IS NULL
        AND phone_number IS NOT NULL
      ORDER BY id ASC
      LIMIT $BATCH_SIZE
    )
    UPDATE users
    SET contact_phone = users.phone_number
    FROM batch
    WHERE users.id = batch.id
    RETURNING users.id;
  ")

  # バッチの処理件数を判定
  COUNT=$(echo "$UPDATED_INFO" | sed '/^$/d' | wc -l)
  if [ "$COUNT" -eq 0 ]; then
    echo "バックフィルが正常に完了しました。"
    break
  fi

  LAST_ID=$(echo "$UPDATED_INFO" | tail -n 1)
  echo "ID $LAST_ID まで、$COUNT 件のレコードを移行しました..."

  # I/O負荷を軽減しレプリケーション遅延の回復を待つため250ミリ秒待機
  sleep 0.25
done
ステップ4:読み取りの切り替えと旧カラム参照の削除
SELECT COUNT(*) FROM users WHERE contact_phone IS NULL AND phone_number IS NOT NULL;を実行してカウント確認を行い、データ移行が100%完了したことを確認します。カウントが0になったら、contact_phoneに対してのみ読み書きを行う新しいアプリケーションをリリースします。
def save_user_phone(db_session, user_id: int, phone: str):
    query = "UPDATE users SET contact_phone = :phone WHERE id = :id"
    db_session.execute(query, {"phone": phone, "id": user_id})
    db_session.commit()

def get_user_phone(db_session, user_id: int) -> str:
    query = "SELECT contact_phone FROM users WHERE id = :id"
    row = db_session.execute(query, {"id": user_id}).fetchone()
return row["contact_phone"] if row else ""エラー追跡ツールやAPMダッシュボードを1〜2デプロイサイクルの間モニタリングします。残存しているワーカーやバッチスクリプトがphone_numberをクエリしていないことを確認してください。
ステップ5:データベーススキーマの縮小(Contract)
コードベースから旧カラムへの参照がすべて解消されたら、不要になったカラムを削除できます。事前に依存関係が残っているビュー、ストアドプロシージャ、レポート用クエリがないか確認してください。確認後、カラムを削除します。
-- 旧カラムを削除
ALTER TABLE users DROP COLUMN phone_number;
まとめと重要ポイント
ダウンタイムなしのデータベース移行を実現するには、スキーマの変更とアプリケーションのリリースを切り離して管理することが不可欠です。Expand and Contractパターンを採用することで、ロックの競合を回避し、ローリングデプロイ中も稼働中の接続を保護できます。
以下の基本原則を常に念頭に置いておきましょう。
- 代替カラムを導入するPull Requestと同じPR内で、既存カラムの変更や削除を行わないこと。
- リードレプリカの遅延やロック競合(スタベーション)を防ぐため、インデックス付き主キーを利用して過去レコードの更新を必ずバッチ化すること。
- 破壊的な変更はすべて、システム全体で3段階のフェーズに分けたデプロイサイクルとして設計すること。