クイックスタート:5分で始めるRAPTOR RAG
標準的なRAGは長い文書に対してひどく機能しません。200ページのPDFをチャンクに分割してベクトルストアに詰め込んでも、ユーザーが高レベルな質問をすると、リトリーバーは47ページのランダムな3つの段落を返すだけです。文脈なし。構造なし。ただのノイズです。
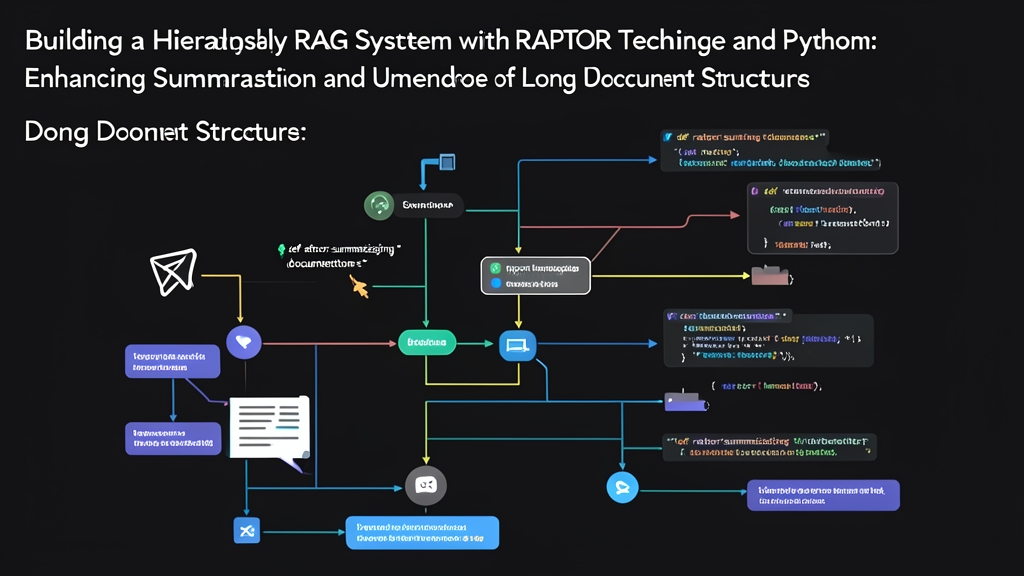
RAPTOR(Recursive Abstractive Processing for Tree-Organized Retrieval)は、徐々に抽象度が上がる要約のツリーを構築することでこれを解決します。リトリーバーは質問の内容に応じて、細粒度の詳細と全体像のコンテキストの両方を取得できます。
技術文書、法的契約書、研究論文——こうした文書タイプこそ、フラットな検索が本番環境で崩壊します。200ページの仕様書で答えがひどかった経験があり、その理由に頭を悩ませていたなら、あなたに足りないのはこのテクニックです。
まず依存関係をインストールします:
pip install anthropic sentence-transformers scikit-learn numpy tiktoken umap-learn次に、すべてが動作することを確認するための簡単な動作確認を行います:
import numpy as np
from sentence_transformers import SentenceTransformer
from sklearn.mixture import GaussianMixture

model = SentenceTransformer('all-MiniLM-L6-v2')
test_emb = model.encode(["RAPTOR test"])
print(f"埋め込みの形状: {test_emb.shape}")  # (1, 384) になるはずです
エラーなく実行できたら、ツリーを構築する準備完了です。
詳細解説:RAPTORの実際の仕組み
フラットなチャンキングの問題点
100ページのアーキテクチャ文書を読むとき、私たちは自然と複数のレベルでメンタルモデルを構築します——章のテーマ、セクションの論点、段落の詳細。標準的なRAGは段落レベルのチャンクしか保存しないため、章レベルの理解を完全に見落とします。「データベース戦略の全体像は?」と聞くと、63ページのコネクションプーリングに関するスニペットが返ってくるだけです。
RAPTORは実際の読み方を反映します。葉ノードが元のチャンクで、各親ノードがその子の要約となるツリーを作成します。クエリ時には葉だけでなく、ツリー全体を検索します。
3ステップのビルドループ
アルゴリズムはツリーが単一のルートノードに収束するまでループします:
- 埋め込み——現在のレベルのすべてのチャンクをベクトルにエンコードする
- クラスタリング——ガウス混合モデルを使って類似チャンクをグループ化する
- 要約——LLMを使って各クラスターの要約を1つ生成する
これらの要約が次のイテレーションの新しい「チャンク」になります。ノードが1つになるまでループを続けます。
import anthropic
from dataclasses import dataclass, field
from typing import List, Optional

@dataclass
class TreeNode:
    text: str
    level: int
    embedding: Optional[np.ndarray] = None
    children: List['TreeNode'] = field(default_factory=list)
    node_id: str = ""

client = anthropic.Anthropic()  # 環境変数から ANTHROPIC_API_KEY を読み込む

def summarize_cluster(texts: List[str]) -> str:
    combined = "\n\n---\n\n".join(texts)
    response = client.messages.create(
        model="claude-sonnet-4-6",
        max_tokens=512,
        system="あなたは技術的な要約者です。提供されたすべてのテキストセグメントから重要なポイントを捉えた、簡潔で情報密度の高い要約を作成してください。",
        messages=[{
            "role": "user",
            "content": f"以下の関連するテキストセグメントを1つのまとまった段落にまとめてください:\n\n{combined}"
        }]
    )
    return response.content[0].text
ガウス混合モデルによるクラスタリング
K-Meansと異なり、GMMはソフトなクラスター割り当てを行います——1つのチャンクが複数のクラスターに部分的に属することができ、段落が2つのトピックにまたがる場合に重要です。K-Meansはハードな割り当てを強制し、このニュアンスを失います。
def cluster_embeddings(embeddings: np.ndarray, max_clusters: int = 10) -> np.ndarray:
    n_samples = len(embeddings)
    n_clusters = min(max(2, n_samples // 3), max_clusters)

    if n_samples <= 2:
        return np.zeros(n_samples, dtype=int)

    # クラスタリング前に次元削減 — GMMは高次元空間で苦手
    from sklearn.decomposition import PCA
    n_components = min(10, n_samples - 1, embeddings.shape[1])
    reduced = PCA(n_components=n_components).fit_transform(embeddings)

    gmm = GaussianMixture(n_components=n_clusters, random_state=42)
    gmm.fit(reduced)
    return gmm.predict(reduced)
応用編:完全なRAPTORツリービルダー
生のテキストを受け取り、ツリーを構築し、検索関数を公開する完全な実装を紹介します:
import uuid
from collections import defaultdict

class RAPTORIndex:
    def __init__(self, embed_model='all-MiniLM-L6-v2'):
        self.embedder = SentenceTransformer(embed_model)
        self.all_nodes: List[TreeNode] = []

    def _chunk_text(self, text: str, chunk_size: int = 400) -> List[str]:
        words = text.split()
        chunks = []
        for i in range(0, len(words), chunk_size):
            chunk = " ".join(words[i:i + chunk_size])
            if chunk.strip():
                chunks.append(chunk)
        return chunks

    def build(self, document: str, max_levels: int = 3) -> None:
        # レベル0:生の文書からの葉チャンク
        chunks = self._chunk_text(document)
        current_nodes = []

        for i, chunk in enumerate(chunks):
            emb = self.embedder.encode([chunk])[0]
            node = TreeNode(
                text=chunk,
                level=0,
                embedding=emb,
                node_id=str(uuid.uuid4())
            )
            current_nodes.append(node)

        self.all_nodes.extend(current_nodes)

        # 上位レベルを反復的に構築
        for level in range(1, max_levels + 1):
            if len(current_nodes) < 2:
                break

            embeddings = np.array([n.embedding for n in current_nodes])
            cluster_labels = cluster_embeddings(embeddings)

            # クラスターごとにノードをグループ化
            clusters = defaultdict(list)
            for node, label in zip(current_nodes, cluster_labels):
                clusters[label].append(node)

            next_nodes = []
            for label, cluster_nodes in clusters.items():
                # このクラスターを要約
                cluster_texts = [n.text for n in cluster_nodes]
                summary = summarize_cluster(cluster_texts)

                summary_emb = self.embedder.encode([summary])[0]
                parent_node = TreeNode(
                    text=summary,
                    level=level,
                    embedding=summary_emb,
                    children=cluster_nodes,
                    node_id=str(uuid.uuid4())
                )
                next_nodes.append(parent_node)
                self.all_nodes.append(parent_node)

            print(f"レベル {level}: {len(current_nodes)} チャンク → {len(next_nodes)} 個の要約")
            current_nodes = next_nodes

    def retrieve(self, query: str, top_k: int = 5) -> List[TreeNode]:
        query_emb = self.embedder.encode([query])[0]

        # すべてのツリーレベルにわたってノードをスコアリング
        scores = []
        for node in self.all_nodes:
            if node.embedding is not None:
                similarity = np.dot(query_emb, node.embedding) / (
                    np.linalg.norm(query_emb) * np.linalg.norm(node.embedding) + 1e-9
                )
                scores.append((similarity, node))

        scores.sort(key=lambda x: x[0], reverse=True)
        return [node for _, node in scores[:top_k]]

    def answer(self, query: str, top_k: int = 5) -> str:
        relevant_nodes = self.retrieve(query, top_k=top_k)
        context = "\n\n".join([
            f"[レベル {n.level}] {n.text}" for n in relevant_nodes
        ])

        response = client.messages.create(
            model="claude-sonnet-4-6",
            max_tokens=1024,
            system="提供されたコンテキストのみに基づいて質問に回答してください。回答がどのレベル(葉の詳細か要約か)から引き出されたかを示してください。",
            messages=[{
                "role": "user",
                "content": f"コンテキスト:\n{context}\n\n質問:{query}"
            }]
        )
        return response.content[0].text
実際の文書でテストします:
with open("your_document.txt", "r") as f:
    doc_text = f.read()

index = RAPTORIndex()
index.build(doc_text, max_levels=3)

print(f"ツリー内のノード総数: {len(index.all_nodes)}")
print(f"  葉ノード: {sum(1 for n in index.all_nodes if n.level == 0)}")
print(f"  要約ノード: {sum(1 for n in index.all_nodes if n.level > 0)}")

answer = index.answer("全体的なアーキテクチャアプローチは何ですか?")
print(answer)
本番環境での実践的なヒント
ドキュメントタイプに合わせてチャンクサイズを調整する
400ワードのチャンクは技術文書に適しています。条文参照が密な法的契約書には150〜200ワードに落とし、各チャンクが意味的に独立したままにしましょう。ナラティブなテキスト(レポート、ホワイトペーパー)には600〜800ワードを使うと、クラスターごとに要約器がより多くの情報を処理できます。
ツリーをキャッシュする——リクエストごとに再構築しない
RAPTORツリーの構築は、すべてのレベルの各クラスター要約でLLM APIを呼び出します。200ページの文書では50〜100回のAPIコールになります。一度構築したらpickleでツリーをシリアライズするか、ノードのテキストと埋め込みをSQLiteに書き込み、起動時に再読み込みしましょう。
import pickle

# 保存
with open("raptor_index.pkl", "wb") as f:
    pickle.dump(index.all_nodes, f)

# 読み込み
with open("raptor_index.pkl", "rb") as f:
    index.all_nodes = pickle.load(f)
検索時にレベルの重みを混合する
検索時には、広い質問には上位レベルの要約を、具体的な事実確認には葉ノードを少し優先させましょう。シンプルなヒューリスティック:クエリが8ワード未満なら葉ノードのスコアを1.1倍に上げ、15ワード超なら要約ノードを優先します。
トークン予算を管理する
要約ループはすぐにコストが積み重なります。各要約コールにmax_tokensの上限を設定しましょう——512で通常は十分です。中間レベルには安価なモデルを使い、ルート要約と最終QAステップに最良のモデルを温存しましょう。大きな文書ではコストを60〜70%削減できます。
デプロイ前にツリーの品質を検証する
構築後は親子ペアをいくつかスポットチェックしましょう。親の要約はすべての子のキーポイントを実際に捉えているべきです——1つの子のコピーのように読める場合、クラスターが不均衡すぎます。max_clustersを上げるか、最小クラスターサイズのチェックを追加しましょう。