背景と必要性
本番環境におけるRetrieval-Augmented Generation(RAG)において、セマンティックベクトル検索は決して万能薬ではありません。密ベクトル(Dense Embedding)は、抽象的な意図や口語表現、言語をまたぐニュアンスを捉えることには長けています。しかし、厳密な技術用語や識別子に対しては途端に破綻します。たとえば、SKU-4821-Xのような正確な製品型番、SEC-4091のようなJiraチケットID、あるいはPostgreSQLのエラーコード42P01を埋め込みモデルに入力してみてください。完全一致する該当ドキュメントではなく、うっすらと関連がありそうな無関係なドキュメントを返したり、関連性を誤認(ハルシネーション)したりすることが珍しくありません。
従来のキーワード検索は、この精度問題を一挙に解決します。PostgreSQLのネイティブ全文検索(Full-Text Search: FTS)は、転置インデックスを活用して文字列の完全一致を数ミリ秒で抽出します。しかしその弱点として、同義語やユーザーの表現の揺れには一切対応できません。"how to repair a flat tyre"(パンクしたタイヤの直し方)と検索した場合、"fixing a punctured tire"と書かれたドキュメントに対してFTSのインデックスはヒット件数ゼロを返してしまいます。
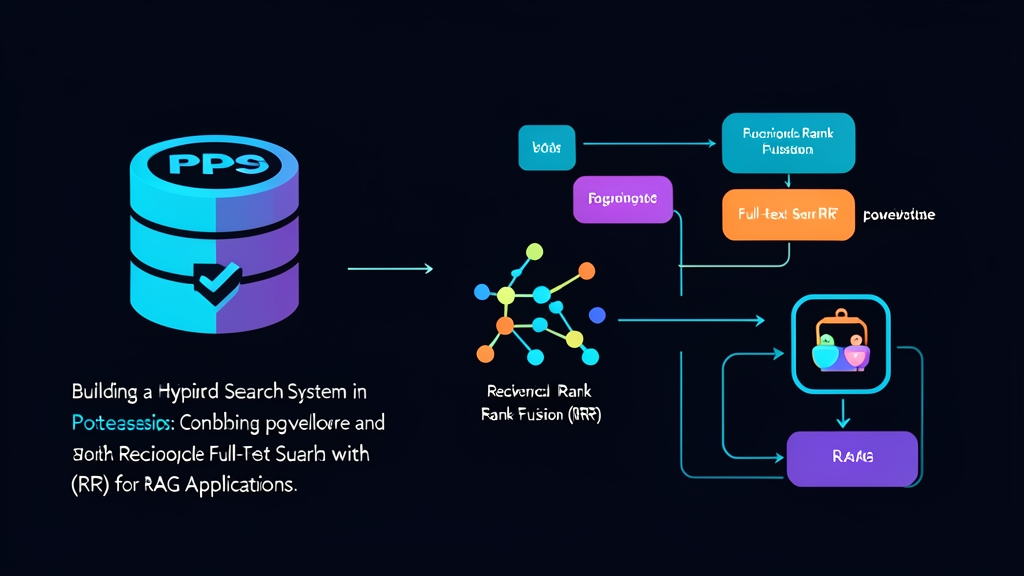
ハイブリッド検索はこの両者の溝を埋めます。語彙検索とベクトル検索を同時に実行し、それぞれの検索上位結果を統合して単一の候補リストを生成します。
しかし、両者の生のスコアを単純に合成しようとすると、悪名高いエンジニアリングの罠に陥ります。ベクトル距離(0.0から2.0の範囲をとるコサイン距離)と、語彙スコアであるts_rank(上限のない浮動小数点数)では、統計的な分布が全く異なります。0.7 * vector + 0.3 * ftsのようなヒューリスティックな重み付けは、新しいドキュメントを追加したり埋め込みモデルを変更したりした瞬間にバランスが崩壊してしまいます。
相互ランク融合(Reciprocal Rank Fusion: RRF)は、手動によるスコア調整の労力を不要にします。RRFは恣意的な関連度スコアを比較する代わりに、各検索メカニズムにおいて各ドキュメントが何位にランクインしたかを評価します。その算出式は極めてシンプルです。
RRF_Score(d) = Σ (1 / (k + rank(d)))ここで、rank(d)は検索結果リストにおける1始まりの順位であり、kは平滑化定数です。情報検索(IR)のベンチマークでは、特定の手法で1位になったドキュメントがスコアを過剰に支配しないよう、通常k = 60が設定されます。例えば、ベクトル検索で1位、全文検索で4位になったドキュメントを考えてみましょう。
その統合スコアは、(1 / (60 + 1)) + (1 / (60 + 4)) = 0.01639 + 0.01562 = 0.03201となります。双方の検索エンジンで上位に入ったドキュメントは急速に総合順位を上げます。一方で、片方のパイプラインでしか見つからなかったドキュメントであっても、最終的なプロンプトコンテキストに残る公平なチャンスが与えられます。
さらに、ベクトルとテキストをPostgreSQL内部に一元化することは、インフラ運用の面でも極めて有利です。二重書き込みによる競合状態を排除し、PineconeやQdrantなどの外部サードパーティ製ベクトルデータベースとの同期処理を不要にし、トランザクションの整合性を完全に維持できます。
インストール
PostgreSQL 15または16と、pgvector拡張機能が必要です。ローカル開発やCIテストにはDockerを利用するのが最も手軽です。
# pgvectorがプリインストールされたPostgreSQL 16を起動
docker run -d \
  --name postgres-hybrid \
  -e POSTGRES_USER=appuser \
  -e POSTGRES_PASSWORD=secretpassword \
  -e POSTGRES_DB=rag_knowledgebase \
  -p 5432:5432 \
  pgvector/pgvector:pg16
ベアメタルのUbuntu 22.04または24.04サーバーの場合は、公式のPGDGリポジトリからビルド済みバイナリを直接インストールできます。
sudo apt update
sudo apt install -y postgresql-16-pgvectorpsqlで対象のデータベースに接続し、拡張機能を有効化します。
CREATE EXTENSION IF NOT EXISTS vector;設定と実装
本番仕様のハイブリッドスキーマでは、テキスト原本に対して2つの検索エンジンを対応させます。キーワード検索用の生成されたtsvector列と、埋め込みベクトル用の固定次元vector列です。
1. スキーマ定義
CREATE TABLE documents (
    id BIGSERIAL PRIMARY KEY,
    title TEXT NOT NULL,
    content TEXT NOT NULL,
    tsv TSVECTOR GENERATED ALWAYS AS (
        setweight(to_tsvector('english', coalesce(title, '')), 'A') ||
        setweight(to_tsvector('english', coalesce(content, '')), 'B')
    ) STORED,
    embedding VECTOR(1536) -- OpenAIのtext-embedding-3-smallに対応
);
GENERATED ALWAYS AS ... STORED句により、INSERTやUPDATEのたびに語彙トークンが自動的に事前計算されます。setweightを使用してタイトルの一致に’A’、本文の一致に’B’の優先度を割り当てることで、見出しでのマッチが自然と上位にランクされるようになります。
2. インデックス戦略
低レイテンシの維持は不可欠です。専用インデックスがない場合、PostgreSQLは両方のクエリで50万行のシーケンシャルスキャンを実行してしまい、APIレスポンス時間が大幅に悪化します。
-- テキスト(キーワード)検索用のGIN(Generalized Inverted Index)インデックス
CREATE INDEX idx_documents_tsv ON documents USING GIN(tsv);

-- コサイン距離用のHNSW(Hierarchical Navigable Small World)インデックス
CREATE INDEX idx_documents_embedding_hnsw ON documents
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);
本番環境のRAGコレクションには、IVFFlatではなくHNSWの採用を推奨します。IVFFlatは事前のバッチ学習が必要で、動的にドキュメントが追加されると再現率(Recall)が低下します。対照的にHNSWはインクリメンタルにインデックスを構築し、予測可能な低レイテンシで95%以上の再現率を安定して提供します。
3. データの取り込み(インジェスト)
生データのエクスポートファイルの整形には手間がかかります。一括挿入のためにCSVダンプを構造化JSONへ迅速に変換したい場合、toolcraft.app/ja/tools/data/csv-to-jsonのようなブラウザ完結型のユーティリティを使えば、機密データを外部ネットワークに送信することなくローカルでファイルをパースできます。構造化した後は、PostgreSQLのCOPYコマンドやPythonのパラメータ付きバッチ挿入を使ってドキュメントを投入します。
4. 相互ランク融合(RRF)クエリの実装
共通テーブル式(CTE)とROW_NUMBER()を活用することで、RRFクエリをPostgreSQL内部だけで完結して実行できます。このクエリは双方から上位60件の候補を抽出し、それらを融合して最適化された上位10件の結果セットを返します。
WITH vector_candidates AS (
    SELECT
        id,
        title,
        content,
        ROW_NUMBER() OVER (ORDER BY embedding <=> '[0.012, -0.045, ... fill 1536 floats ... ]'::vector) AS rank
    FROM documents
    ORDER BY embedding <=> '[0.012, -0.045, ... fill 1536 floats ... ]'::vector
    LIMIT 60
),
text_candidates AS (
    SELECT
        id,
        title,
        content,
        ROW_NUMBER() OVER (ORDER BY ts_rank_cd(tsv, plainto_tsquery('english', 'database connection timeout')) DESC) AS rank
    FROM documents
    WHERE tsv @@ plainto_tsquery('english', 'database connection timeout')
    ORDER BY ts_rank_cd(tsv, plainto_tsquery('english', 'database connection timeout')) DESC
    LIMIT 60
)
SELECT
    COALESCE(v.id, t.id) AS id,
    COALESCE(v.title, t.title) AS title,
    COALESCE(v.content, t.content) AS content,
    (
        COALESCE(1.0 / (60 + v.rank), 0.0) +
        COALESCE(1.0 / (60 + t.rank), 0.0)
    ) AS rrf_score
FROM vector_candidates v
FULL OUTER JOIN text_candidates t ON v.id = t.id
ORDER BY rrf_score DESC
LIMIT 10;ここでFULL OUTER JOINを用いている点に注目してください。これにより、どちらか一方の手法でのみ取得されたドキュメントを取りこぼさず維持しつつ、両方でマッチしたドキュメントには加算スコアによる優位性を与えています。
5. RAG向けのPythonリトリーバル関数
最新のpsycopg(v3)を使用したエンドツーエンドの連携コード例です。Pythonの浮動小数点数リストをPostgreSQLのベクトルリテラル文字列に整形して渡しています。
import psycopg
from psycopg.rows import dict_row

def hybrid_search(
    db_url: str,
    query_text: str,
    query_embedding: list[float],
    limit: int = 5
) -> list[dict]:
    # 浮動小数点数配列をpgvectorのリテラル文字列 '[0.012,-0.045,...]' に変換
    vector_str = f"[{','.join(map(str, query_embedding))]}"

    sql = """
    WITH vector_candidates AS (
        SELECT id, title, content,
               ROW_NUMBER() OVER (ORDER BY embedding <=> %s::vector) AS rank
        FROM documents
        ORDER BY embedding <=> %s::vector
        LIMIT 60
    ),
    text_candidates AS (
        SELECT id, title, content,
               ROW_NUMBER() OVER (ORDER BY ts_rank_cd(tsv, plainto_tsquery('english', %s)) DESC) AS rank
        FROM documents
        WHERE tsv @@ plainto_tsquery('english', %s)
        ORDER BY ts_rank_cd(tsv, plainto_tsquery('english', %s)) DESC
        LIMIT 60
    )
    SELECT
        COALESCE(v.id, t.id) AS id,
        COALESCE(v.title, t.title) AS title,
        COALESCE(v.content, t.content) AS content,
        (
            COALESCE(1.0 / (60 + v.rank), 0.0) +
            COALESCE(1.0 / (60 + t.rank), 0.0)
        ) AS rrf_score
    FROM vector_candidates v
    FULL OUTER JOIN text_candidates t ON v.id = t.id
    ORDER BY rrf_score DESC
    LIMIT %s;
    """

    with psycopg.connect(db_url, row_factory=dict_row) as conn:
        with conn.cursor() as cur:
            cur.execute(
                sql,
                (vector_str, vector_str, query_text, query_text, query_text, limit)
            )
            return cur.fetchall()
検証とモニタリング
パイプラインを立ち上げたら、検索の関連性を検証し、並行トラフィック下でのクエリレイテンシをプロファイリングします。
検索動作の検証
RRFが両方のモダリティを適切に順位付けできているか確認するため、インデックスに対して以下の2つのサニティチェックを実行します。
- 完全一致テスト(SKU・エラーコード):
ORA-00942やERR-CONN-503のような固有の識別子で検索します。テキスト側のパイプラインが正確なログエントリを1位に配置し、埋め込みモデルによるセマンティックの揺らぎを抑え込めているか確認します。 - 概念・同義語テスト: "how do I prevent connection exhaustion in high concurrency web services?"(高並行Webサービスでコネクション枯渇を防ぐには?)のように、直接的なキーワードを含まない抽象的なプロンプトで検索します。ベクトル検索を経由して、PgBouncerのようなコネクションプーラーを解説したガイドが上位にランクインすることを確認します。
実行計画の分析
EXPLAIN (ANALYZE, BUFFERS)を用いて、psql内で実行パスを検査します。
EXPLAIN (ANALYZE, BUFFERS)
WITH vector_candidates AS (...) ...
出力結果で確認すべき3つの重要チェックポイントは以下の通りです。
- テキスト候補のCTEにおいて、
Bitmap Index Scan on idx_documents_tsvが表示されていること。もしSeq Scanになっている場合は、work_memを見直し、enable_seqscanが強制されていないか確認してください。 - ベクトル候補のCTEにおいて、
Index Scan using idx_documents_embedding_hnswが報告されていること。 - インデックス化された50万件のドキュメントテーブルに対して、全体の実行時間が4msから15msの間に収まっていること。
モニタリングとキャッシュチューニング
HNSWグラフは大量のメモリを消費します。クエリのたびにサーバーが低速なNVMeやブロックストレージからインデックスセグメントをフェッチせざるを得ない状況になると、レイテンシは8msから120ms以上へと跳ね上がります。
-- documentsテーブルとインデックスのディスク使用量を確認
SELECT
    c.relname AS object_name,
    pg_size_pretty(pg_relation_size(c.oid)) AS table_size,
    pg_size_pretty(pg_total_relation_size(c.oid)) AS total_size
FROM pg_class c
JOIN pg_namespace n ON n.oid = c.relnamespace
WHERE n.nspname = 'public' AND c.relname = 'documents';1536次元のベクトル25万件のインデックスの場合、HNSWインデックスは約1.8GBのRAMを消費します。インデックスがキャッシュに快適に収まるよう、postgresql.confを調整してください。
# アクティブなテーブルとHNSWインデックス構造をカバーできるようshared_buffersを確保
shared_buffers = 4GB

# ウィンドウ関数やCTEのソート処理向けに作業メモリを割り当て
work_mem = 64MB

# HNSWの探索深度を設定(デフォルトは40。80〜100でレイテンシ約10ms・再現率98%以上を達成)
# コネクションごとに動的設定も可能: SET hnsw.ef_search = 100;
hnsw.ef_search = 80
リレーショナルな状態とベクトル埋め込みの両方をPostgreSQL内に保持することで、RAGスタックから不要な複雑さを削ぎ落とせます。外部のベクトル特化型マイクロサービスを運用することなく、ACID特性の安全性、ゼロデータドリフト、そして15ms未満の高速なハイブリッド検索を実現できます。