Pandasが眠れない夜をもたらすとき
昨年、毎晩15GBのイベントログを解析するパイプラインを任された。スクリプトは数ヶ月間問題なく動いていた——データ量が倍になるまでは。突然、32GBのマシンでOOMが発生し、深夜2時に再起動、そしてread_csvをチャンク処理するという古典的な応急処置で20分の処理が90分の悪夢に変わった。
Pandasは探索的な作業や小〜中規模のデータセットには優れているが、このような用途向けには設計されていない。すべてをメモリに一括ロードし、操作間でデータをコピーし、デフォルトでは単一のCPUコアしか使用しない。その設計は2008年には理にかなっていた。しかし数億行のデータを扱う場合には通用しない。
Polarsはデータ処理に対する私の考え方を根本から変えた。そのパイプラインを移行した後、ピークメモリ使用量は70%削減され、実行時間は90分から8分以内になり、深夜2時のアラートは一度も来なくなった。これは魔法ではない——実行モデルが異なるのだ。一度理解すれば、おもちゃのデータセットを超えるあらゆる作業でPolarsを最初に選ぶようになる。
Polarsを他と差別化するコアコンセプト
遅延実行とクエリプランニング
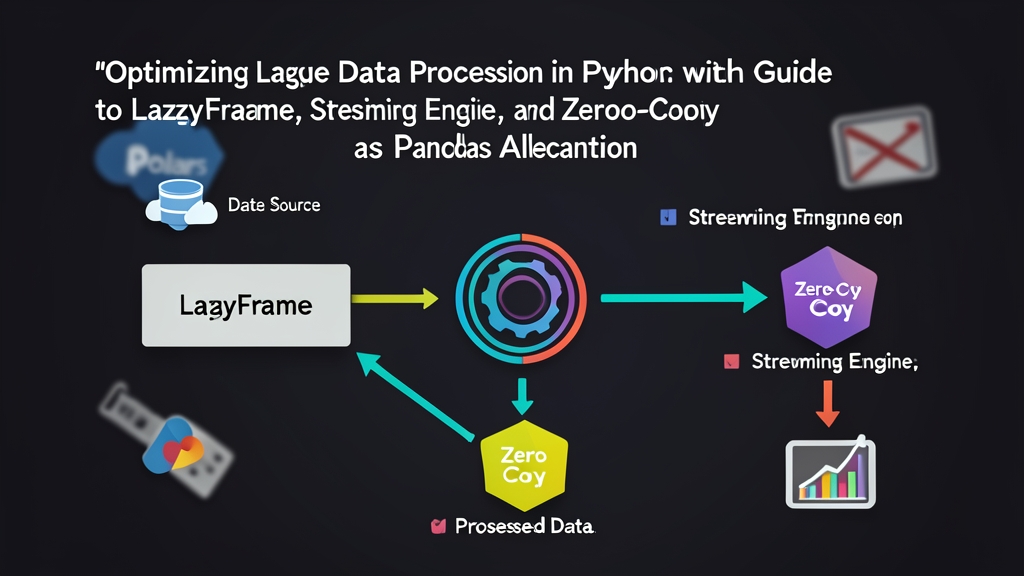
PolarsのLazyFrameを記述しても、実際には何も実行されない。クエリプラン——何を望むかの記述——を構築しているだけだ。Polarsはプラン全体を収集し、最適化(述語プッシュダウン、射影プッシュダウン、CSE除去)を行い、.collect()を呼び出したときにのみ実行する。
Pandasでは連鎖するメソッドごとに完全な中間DataFrameが具現化されるのとは対照的だ。PolarsのLazyFrameでは、プランの早い段階で5%の行にフィルタリングすると、以降のすべてのステップは100%ではなく5%のデータに対して動作する。
コア外処理のためのストリーミングエンジン
ストリーミングエンジンこそが、真に大きなファイルを扱いやすくするものだ。データセットを一度にメモリにロードする代わりに、Polarsは内部でチャンク単位で処理する——ただしPandasのチャンク処理と異なり、チャンキングロジックを自分で書く必要はない。.collect()にstreaming=Trueを追加するだけで、Polarsが残りを処理する。クエリプランは保持され、Polarsがチャンク間の作業分割方法を決定する。
内部のゼロコピーとApache Arrow
PolarsはメモリフォーマットとしてApache Arrowを使用して構築されている。Arrowはカラム型のゼロコピーデータフォーマットだ。カラムをスライスしたり、Arrowネイティブライブラリ——DuckDB、PyArrow、dtype_backend="pyarrow"のPandas 2.x——間でデータを受け渡す際、データはコピーされない。クローンではなく、ポインタを渡すだけだ。
プロファイラで追跡するまでは抽象的に聞こえる。私が最初にその違いに気づいたのは、DuckDB→Polars→scikit-learnパイプラインを構成したときだ:それらの引き渡し間でコピーされたバイトはゼロだった。それはマルチライブラリワークフローにおける最大の隠れたコストであり、Arrowはそれを完全に排除する。
デフォルトのSIMDとマルチコア
PolarsはRustで書かれており、スレッドベースの並列処理にRayonを使用している。集計、結合、変換は利用可能なすべてのCPUコアに自動的に展開される。オプトインする必要はない——必要な場合にオプトアウトする。
ハンズオン:実際のパイプラインを再構築する
インストール
pip install polars pyarrowLazyFrameの基本
まず、CSVをロードせずにスキャンしてみよう:
import polars as pl

# scan_csv はスキーマのみを読み込む — データはまだロードされていない
lf = pl.scan_csv("events.csv")

# クエリプランを構築する
result = (
    lf
    .filter(pl.col("status") == "error")
    .filter(pl.col("response_ms") > 500)
    .select(["timestamp", "endpoint", "user_id", "response_ms"])
    .group_by("endpoint")
    .agg(
        pl.col("user_id").count().alias("error_count"),
        pl.mean("response_ms").alias("avg_response_ms"),
        pl.max("response_ms").alias("p100_response_ms"),
    )
    .sort("error_count", descending=True)
)

# まだ何も実行されていない。今すぐ実行する:
df = result.collect()
print(df.head(10))filterの呼び出しはスキャンレベルにプッシュダウンされる——Polarsは一致しない行がメモリに触れる前にスキップする。selectによって、ファイル全体ではなく4列のみがディスクから読み取られる。これが述語プッシュダウンと射影プッシュダウンが自動的に機能する仕組みだ。
RAMに収まらないファイルのためのストリーミングエンジン
16GBのマシンで50GBのParquetファイルがある?ストリーミングモードが解決する:
import polars as pl

lf = pl.scan_parquet("huge_dataset/*.parquet")  # glob も使用可能

daily_summary = (
    lf
    .filter(pl.col("event_type").is_in(["purchase", "refund"]))
    .with_columns(
        pl.col("created_at").str.to_datetime().dt.date().alias("date")
    )
    .group_by(["date", "event_type"])
    .agg(
        pl.sum("amount").alias("total_amount"),
        pl.len().alias("event_count"),
    )
)

# streaming=True:Polarsはチャンク単位で処理し、メモリを一定に保つ
df = daily_summary.collect(streaming=True)
df.write_parquet("daily_summary.parquet")知っておくべき制約がひとつある:まだすべての操作がストリーム可能ではない。いくつかの複雑な結合は完全な具現化パスが必要だ。Polarsはそれらのステップではインメモリにフォールバックし、警告を発する。開発中にpl.Config.set_verbose(True)を実行すると、ストリーミングがどこで有効になるかを正確に確認できる。
他のツールへのゼロコピー引き渡し
クロスライブラリの引き渡しこそ、Arrowがその価値を発揮する場所だ。Arrowフォーマットを共有するライブラリのパターンを示す:
import polars as pl
import pyarrow as pa
import pandas as pd

# Polars → PyArrow:ゼロコピー
polars_df = pl.read_parquet("data.parquet")
arrow_table = polars_df.to_arrow()  # データはコピーされない

# PyArrow → Polars:ゼロコピー
polars_back = pl.from_arrow(arrow_table)

# Polars → Pandas(Arrowバックエンド使用、Pandas 2.x+):最小限のコピー
pandas_df = polars_df.to_pandas(use_pyarrow_extension_array=True)

# numpyを経由する必要がある場合(旧Pandas):ここで1回コピーが発生する
pandas_legacy = polars_df.to_pandas()  # numpyコピー、不可避
Pandasしか理解しないライブラリ(一部のsklearnエスティメータ、matplotlib)に引き渡す必要がある場合、できる限り最後までPolarsパイプラインを維持し、必要なスライスだけを変換する:
# 1000万行のデータセット全体を変換しない
# 集計結果のみを変換する(約1000行)
small_result = (
    pl.scan_csv("10M_rows.csv")
    .filter(pl.col("region") == "JP")
    .group_by("product_id")
    .agg(pl.sum("revenue"))
    .collect()
)

# 小さな結果をPandasに変換してプロットする
small_result.to_pandas().plot.bar(x="product_id", y="revenue")
Expression API:再利用可能な変換の記述
Polarsの式はファーストクラスPythonオブジェクトだ——Pandasが一度もうまく実現できなかったことだ。変換ロジックを再利用可能な変数として構築できる:
import polars as pl

# 再利用可能な式を定義する
revenue_per_visit = (pl.col("revenue") / pl.col("visits")).alias("revenue_per_visit")
bounce_rate = (pl.col("single_page_sessions") / pl.col("sessions")).alias("bounce_rate")
high_value = pl.col("revenue_per_visit") > 50

# どこでも適用できる
df = (
    pl.scan_csv("analytics.csv")
    .with_columns([revenue_per_visit, bounce_rate])
    .filter(high_value)
    .collect()
)これらは単純なExprオブジェクトだ。リストに格納したり、ループしたり、関数間で受け渡したりできる——DataFrameのモンキーパッチも、コードベース全体に散らばる文字列カラム参照も不要だ。
Pandasとのベンチマーク比較
500万行のCSVでの直接対決:
import time
import polars as pl
import pandas as pd

# Pandas
start = time.perf_counter()
df_pd = pd.read_csv("5M_rows.csv")
result_pd = (
    df_pd[df_pd["status"] == "active"]
    .groupby("region")["revenue"]
    .agg(["sum", "mean", "count"])
)
print(f"Pandas: {time.perf_counter() - start:.2f}s")

# Polars
start = time.perf_counter()
result_pl = (
    pl.scan_csv("5M_rows.csv")
    .filter(pl.col("status") == "active")
    .group_by("region")
    .agg([
        pl.sum("revenue"),
        pl.mean("revenue"),
        pl.len(),
    ])
    .collect()
)
print(f"Polars: {time.perf_counter() - start:.2f}s")
私のマシン(8コア、16GB RAM)では、Pandasは約4.2秒、Polarsは約0.7秒——まだRAMに余裕で収まるデータセットで6倍の高速化だ。5000万行に増やすと差はさらに大きくなる:Pandasは2分を超えて苦闘し、Polarsは通常5秒以内に収まる。
Pandasを使い続ける場面(そして切り替える場面)
Polarsはすべてのユースケースでそのまま代替できるわけではない。知っておくべきトレードオフを挙げる:
- Pandasを使い続ける場面:MLライブラリとの統合(scikit-learn、statsmodels)、QuantLibのような金融ライブラリ、Jupyterでのアドホックなインデックス操作を多用したインタラクティブなEDA。
- Polarsに切り替える場面:ETLパイプライン、ログ処理、約1GBを超えるファイル、プロダクションデータ変換、パフォーマンス改善のためにリファクタリングするパイプライン、スケジュールで実行されるあらゆるもの。
- 両方の長所を活かす:重い処理はPolarsで行い、ML/可視化の最終ステップで
to_pandas()に変換する。Arrowバックの変換は十分に高速なので、このハイブリッドアプローチは実際にうまく機能する。
移行後に変わったこと
あの夜間パイプラインに話を戻すと:書き直しには約2日かかり、主にPolarsのExpression APIの学習といくつかのストリーミングエッジケースのデバッグに費やした。見返りはすぐに現れた——ピークメモリが28GBから8GBへ、実行時間が90分から7分へ、そしてその後数ヶ月間OOMクラッシュはゼロだ。
最も重要な思考の転換は、遅延評価を例外ではなくデフォルトとして受け入れることだ。完全な変換を記述し、Polarsにプランを立てさせ、それからcollectする。その規律——何も実行する前にクエリ全体を構築する——こそが、オプティマイザが仕事をするための条件だ。それが腑に落ちると、APIはもはや抵抗しなくなる。
今日プロダクションでPythonデータパイプラインを動かしていてPolarsをまだ見ていないなら、午後一つ費やす価値はある。遅いスクリプトを一つ選んで、scan_csvとLazyFrameで書き直し、計測してみよう。数字が自ずと語ってくれる。