背景と導入の理由
半年前、弊社のセキュリティチームから厳格な方針が打ち出されました。顧客のソースコードや社内テレメトリデータをプライベートネットワークの外部へ送信することを一切禁止するというものです。これにより、OpenAIやAnthropicといったホスト型APIの利用肢は除外されました。既存の開発者向けワークステーションやオンプレミスサーバー上で、実用的な8Bや14Bクラスのモデルを自前で運用しなければならなくなったのです。そして私たちは即座に「VRAMの壁」に直面しました。
非量子化の16ビット(FP16/BF16)8Bモデルは、生ウェイトを保持するだけで約16 GBのVRAMを消費します。さらに8kコンテキストウィンドウ用のKVキャッシュを確保すると、追加で1.2 GBを消費します。これを一般的な12 GBのRTX 3060や4070で動かそうとすると、最初のトークンを1つ生成する前にOut-of-Memory(OOM)エラーでクラッシュしてしまいます。
Hugging Face上のコミュニティがアップロードした事前量子化済みのGGUFファイルを利用するのは、一見魅力的に思えます。私たちも初期段階ではそうしていましたが、ステージング環境で思わぬ落とし穴にはまりました。コミュニティ製の量子化モデルはバージョン管理が行き届いていないことが多く、古いチャットテンプレートが使われていたり、BOS/EOSトークンが破損していたり、汎用的な量子化マトリックスによって独自コードベースに対するパープレキシティが悪化していたりするケースが散見されたのです。大元のsafetensorsから自前で量子化を行えば、作業時間は10分程度で済み、生成されるバイナリを完全にコントロールできます。
これを現実的なものにしてくれるのがGGUFフォーマットです。旧来のGGMLとは異なり、GGUFはトークナイザー、アーキテクチャのハイパーパラメータ、テンソルデータを自己記述的な単一のバイナリに集約しています。また、mmapを介してメモリに直接マッピングされるため、ほぼ瞬時のロードが可能となり、システムRAMとGPU VRAMの間でクリーンなレイヤーごとのオフロードを実現できます。
環境構築
ビルド環境には、コンパイル済みのllama.cpp C/C++バイナリと、メタデータ変換用の独立したPython環境の2つが必要です。
1. ソースからllama.cppをビルドする
コンパイラがCPUのネイティブ命令セット(AVX-512やARM Neonなど)を最大限に活用できるよう、対象ハードウェア上で直接バイナリをコンパイルします。
# llama.cppリポジトリをクローン
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp

# CMakeでビルド設定(Nvidia GPU向けにCUDAを有効化)
cmake -B build -DGGML_CUDA=ON -DCMAKE_BUILD_TYPE=Release

# 全CPUコアを使用してバイナリをビルド
cmake --build build --config Release -j $(nproc)
Apple Siliconの場合は、-DGGML_CUDA=ONを-DGGML_METAL=ONに変更してMetalフレームワーク向けにコンパイルしてください。
2. Python変換環境のセットアップ
変換スクリプトは、Hugging Faceのsafetensorsをパースし、トークナイザー設定を読み込んで、非圧縮のFP16 GGUFコンテナへと再パッケージ化します。専用の仮想環境を作成してこれらの依存関係を隔離します。
python3 -m venv .venv
source .venv/bin/activate
pip install --upgrade pip
# GGUF変換に必要な依存パッケージをインストール
pip install -r requirements/requirements-convert_hf_to_gguf.txt
pip install huggingface_hub
3. ベースモデルのウェイトをダウンロードする
公式のsafetensorsファイルをアップストリームから直接取得します。本手順では、MetaのLlama-3.1-8B-Instructを変換対象とします。
huggingface-cli download meta-llama/Llama-3.1-8B-Instruct \
  --local-dir ./models/Llama-3.1-8B-Instruct \
  --local-dir-use-symlinks False
設定と量子化
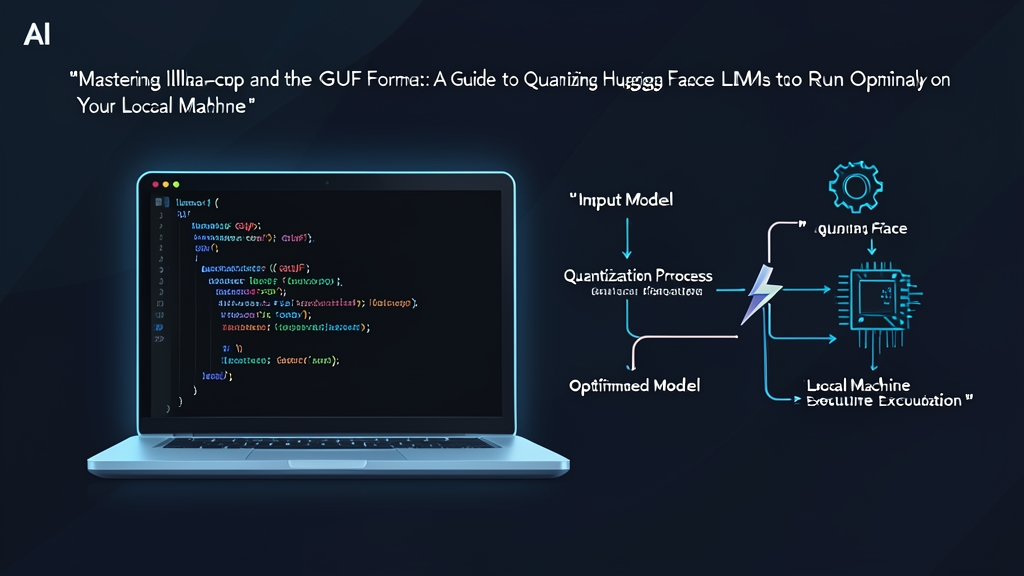
量子化は2つの段階で進めます。まず、分散されたウェイトを展開して非圧縮のFP16 GGUFコンテナに変換します。次に、そのウェイトを指定したビット深度の整数表現へと量子化します。
ステップ1:SafetensorsをベースラインGGUF(FP16)に変換
ダウンロードしたモデルディレクトリに対して変換ユーティリティを実行します。
python3 convert_hf_to_gguf.py ./models/Llama-3.1-8B-Instruct \
  --outfile ./models/llama-3.1-8b-fp16.gguf \
  --outtype f16
これにより、約16.1 GBの中間ファイルが出力されます。このファイルは複数の量子化レベルを生成するためのクリーンなマスターコピーとなるため、まだ削除しないでください。
ステップ2:ターゲットとなる量子化方式を選択
近年のllama.cppでは「k-quants(k量子化)」が採用されており、すべてのウェイトを一律に切り捨てるのではなく、レイヤーごとに異なる精度を適用します。トークン埋め込みやアテンション出力などのクリティカルなレイヤーには、感度の低いフィードフォワードテンソルよりも高いビット精度が割り当てられます。
- Q8_0(約8.5 GB): パープレキシティ保持率99.9%。16 GB以上のVRAMがあり、法務分析など極めて高い精度が求められるタスクでほぼ無劣化の出力を得たい場合に選択します。
- Q5_K_M(約5.7 GB): 開発者向けワークステーションにおける推奨デフォルト設定。元のファイルサイズを65%削減しながら、複雑なコーディングや段階的な推論能力を維持します。
- Q4_K_M(約4.9 GB): コンシューマー向けGPUにおける標準構成。8 GB VRAMのGPUにも余裕で収まり、8kコンテキストウィンドウ用に約3 GBの空き容量を確保できます。
- Q3_K_M(約4.0 GB): アグレッシブな圧縮方式。ハードウェアのリソースが極めて厳しい環境には適していますが、厳密なJSON生成で構文エラーが発生したり、関数呼び出し(Function Calling)のパラメータが欠落したりする現象が見られます。
ステップ3:llama-quantizeを実行
FP16のマスターファイルと目的の量子化ターゲットを、コンパイル済みの量子化ツールに渡します。
# 4ビット中精度(Medium)量子化モデルを生成
./build/bin/llama-quantize ./models/llama-3.1-8b-fp16.gguf \
  ./models/llama-3.1-8b-instruct-Q4_K_M.gguf Q4_K_M

# より高精度な5ビット中精度(Medium)量子化モデルを生成
./build/bin/llama-quantize ./models/llama-3.1-8b-fp16.gguf \
  ./models/llama-3.1-8b-instruct-Q5_K_M.gguf Q5_K_M
Ryzen 9 7900Xのような最新の12コアCPUであれば、処理は90秒未満で完了します。量子化ファイルのビルドが完了したら、ローカルディスク容量を空けるために16 GBのFP16ファイルを削除しても安全です。
検証とベンチマーク
トークンのフォーマットや持続的なメモリの安定性を検証せずに、新しく量子化したモデルを本番環境へそのまま投入してはいけません。
1. 動作確認(サニティチェック)
モデルが指示タグ、ストップトークン、システムプロンプトを正確に処理できることを確認します。
./build/bin/llama-cli \
  -m ./models/llama-3.1-8b-instruct-Q4_K_M.gguf \
  -p "<|start_header_id|>system<|end_header_id|>
あなたはLinuxカーネルエンジニアです。<|eot_id|><|start_header_id|>user<|end_header_id|>
epollがselectよりもスケーラビリティに優れている理由を2文で説明してください。<|eot_id|><|start_header_id|>assistant<|end_header_id|>" \
  -n 128 \
  -ngl 99 \
--temp 0.2初期化時のターミナルログを確認してください。-ngl 99フラグは、全レイヤーをGPUにオフロードするようエンジンに指示するものです。llm_load_tensorsによって全33レイヤーがCUDAまたはMetalにオフロードされていることを確認します。
2. llama-benchによるスループットのベンチマーク測定
目分量での推測は避け、制御されたバッチ構成下でプロンプト処理(PP)およびテキスト生成(TG)の正確な速度を測定します。
./build/bin/llama-bench \
  -m ./models/llama-3.1-8b-instruct-Q4_K_M.gguf \
  -p 512,2048 \
  -n 128 \
  -ngl 99
RTX 4070(12 GB VRAM)におけるLlama-3.1-8B-Instruct Q4_K_Mのベースライン値は、プロンプト取り込み(PP 512)で2,140トークン/秒、生成(TG 128)で104トークン/秒を記録しました。VRAMの総割り当て量は5.4 GBで安定しており、複数ユーザーの同時リクエストにも十分な余裕があります。
3. 監視すべき運用の落とし穴
短いテストプロンプトを通過したモデルであっても、持続的な高負荷下で問題を起こすことがあります。実際の運用では、次の3点に注意してください。
- KVキャッシュの肥大化: 会話が16kトークン近くまで伸びると、KVキャッシュだけで2.5 GBのVRAMを占有することがあります。これがシステムメモリへ溢れ出すと、スループットは100+トークン/秒から一桁台へと急落します。オーバーヘッドを半減させるために、8ビットKVキャッシュ量子化(
-ctk q8_0 -ctv q8_0)の有効化を検討してください。 - パープレキシティの低下(回帰): 特化型のファインチューニングモデル(医療系やSQLモデルなど)を量子化する場合は、ドメイン検証データセットに対して
./build/bin/llama-perplexityを使用してパープレキシティを測定してください。検証もせずに一般的なQ4_K_Mがニッチな専門用語の精度を維持できると思い込んではいけません。 - サーマルスロットリング: ケース内のエアフローが不十分な小型ワークステーションでは、バッチ処理を連続実行している間にGPUクロックが15%〜25%低下することがよくあります。
nvidia-smi dmonを使用してクロックとファンカーブを監視してください。
独自の量子化パイプラインを構築する手間はごくわずかであり、データの保護境界を維持しながら、社内ハードウェア上で稼働するすべてのモデルを要求通りのレイテンシと精度要件に適合させることができます。