セルフホスト環境に潜む「サイレント障害」問題
半年前の金曜日の午後、外出中に自宅でセルフホストしていたNextcloudインスタンスが突然停止しました。しかし、誰もそれに気付きませんでした。クライアントフォルダーの同期を試みてエラーに直面するまで、丸10時間も放置されていたのです。原因は、定期的なOSパッケージアップデートの裏でMariaDBコンテナがサイレントにハングアップしていたことでした。その間も、Nginxは何食わぬ顔で空っぽの「502 Bad Gateway」ページを返し続けていました。
サイレント障害は、複数のミニPCやハイパーバイザー上で何十ものコンテナを稼働させているすべてのホームラボ運用者にとって悩みの種です。HomerやDashyのようなダッシュボードは見栄えの良いブックマークを提供してくれますが、データベースがデッドロックに陥ったときや、内部ワーカーがクラッシュしたとき、あるいは来週火曜日にSSL証明書の期限が切れるといった事態までは教えてくれません。Better StackやUptimeRobotなどのクラウド型監視ツールは公開ドメインには最適ですが、ファイアウォールに穴を開けない限り、192.168.1.50:8080のようなプライベートサブネット内を監視することは不可能です。
私に必要だったのは内部監視役(ウォッチドッグ)でした。LAN内に常駐し、主要なサービスを60秒ごとにポーリングして、ユーザーから苦情が出る前にスマートフォンへ通知してくれる仕組みです。
基本概念:Uptime Kumaの仕組み
Uptime Kumaは、Node.jsとVue 3で構築されたオープンソースの監視ツールです。PrometheusやGrafanaのようなエンタープライズ向けの可観測性スタックは専用ストレージや無視できないCPUリソースを消費しますが、対照的にKumaのRAM消費量はわずか130MB〜180MB程度です。古いIntel NUCやRaspberry Pi 4でも負荷をほとんどかけることなく、WebSocket経由で1秒未満のダッシュボード更新を実現します。
監視タイプとプローブ戦略
ICMP pingはOSが応答しているかどうかしか分かりません。アプリケーションが正常に動作しているかまでは把握できないのです。Uptime Kumaは、実践的なホームラボ環境向けに設計された多様なプローブに対応しています:
- HTTP(s) キーワード監視:
200 OKなどのステータスコードを検証するだけでなく、HTMLペイロード内に特定の文字列(NextcloudやDashboardなど)が含まれているかをスキャンします。これにより、Webサーバーが真っ白な画面やリバースプロキシのエラーではなく、アプリケーションを正しくレンダリングしていることを確認できます。 - TCPポートとPing:ハイパーバイザーのポート、ネットワークスイッチ、さらにPostgreSQL(ポート5432)やRedis(ポート6379)といったデータベースのRAWソケットを監視します。
- DNSクエリ監視:Pi-holeやAdGuard Homeなどのローカルリゾルバーに問い合わせを行い、名前解決の失敗や150msを超える高レイテンシを検知します。
- TLS/SSL有効期限トラッキング:証明書の有効期間を自動で解析します。Let’s Encryptの自動更新失敗を見落とす前に、有効期限の14日前に警告を発行します。
- プッシュ監視(ハートビート):cronタスクやバックアップジョブのデッドマンスイッチとして機能します。毎晩実行されるBorgやResticのバックアップスクリプトが、指定したWebhookへのcurlリクエストを25時間以内に送信しなかった場合、Kumaがアラートをトリガーします。
疎結合な通知アーキテクチャ
Kumaはプローブのロジックとアラートのルーティングを完全に切り離しています。エンドポイントがリトライ回数上限に達して失敗すると、独立した通知ドライバーを介してイベントが発火します。個々の監視設定に手を加えることなく、Discord、Telegram、Pushover、Gotify、Signal、または汎用Webhookへ同時にアラートを配信できます。
実践ガイド:DockerでUptime Kumaをデプロイする
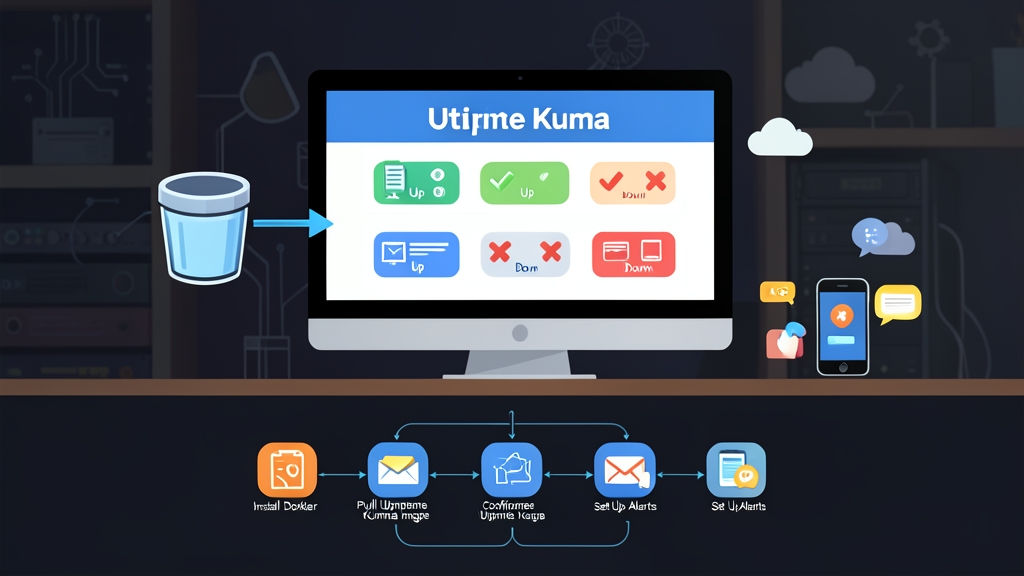
Uptime Kumaをコンテナ化することで、アップグレードが容易になり、すべてのステート(状態)を単一のディレクトリに閉じ込めることができます。以下は、私のUbuntu 24.04サーバーで実際に動作しているCompose構成です。
ステップ1:Docker Composeによるデプロイ
Dockerホスト上にプロジェクトディレクトリを作成し、新規設定ファイルを開きます:
mkdir -p /opt/uptime-kuma && cd /opt/uptime-kuma
nano docker-compose.yml
以下の構成定義を貼り付けます:
services:
  uptime-kuma:
    image: louislam/uptime-kuma:1
    container_name: uptime-kuma
    restart: always
    volumes:
      - ./kuma-data:/app/data
    ports:
      - "3001:3001"
    security_opt:
      - no-new-privileges:true
コンテナをバックグラウンド(デタッチモード)で起動します:
docker compose up -d
コンテナの状態を確認し、正常に起動したかをチェックします:
docker compose ps
ブラウザを開き、http://<サーバーのIPアドレス>:3001にアクセスします。初期セットアップウィザードが表示され、管理者ユーザー名とパスワードの作成を求められます。フォームを送信してメインダッシュボードに入室してください。
ステップ2:エッジ検証を含むモニターの設定
単純なHTTPステータスコードだけに頼るのは避けましょう。TraefikやCaddyなどの内部リバースプロキシは、背後にあるアプリケーションコンテナが完全に停止していても200 OKを返してしまうことがあるためです。代わりにキーワード検証を活用します。
ナビゲーションヘッダーの「Add New Monitor(新しいモニターを追加)」をクリックし、以下の通り設定します:
- Monitor Type(監視タイプ):HTTP(s) – Keyword
- Friendly Name(表示名):Nextcloud Core
- URL:
https://cloud.local.internal/login - Heartbeat Interval(チェック間隔):60 seconds(60秒)
- Retries(リトライ回数):2(一時的なWi-Fiの瞬断を吸収するため、2回連続で失敗した段階でアラートを発行)
- Keyword(キーワード):
Nextcloud - Certificate Expiry Notification(証明書期限切れ通知):有効化(証明書の有効期限が14日未満になったら通知)
「Save(保存)」をクリックします。Kumaは直ちに最初のプローブを実行し、レスポンスレイテンシのグラフを更新してステータスバッジを緑色に点灯させます。
ステップ3:DiscordとTelegramのインシデント通知設定
リアルタイムで通知が届かない監視システムには何の意味もありません。日頃からチェックしているチャットプラットフォームへ障害イベントを直接ルーティングしましょう。
「Settings(設定)」>「Notifications(通知)」>「Setup Notification(通知の設定)」に移動します。
選択肢A:Telegram Botによる通知
- Telegramを開き、
@BotFatherとのチャットを開始して/newbotを実行し、Botトークンを生成します。 - 管理者用のチャンネルまたはグループを作成し、作成したBotをメンバーとして追加してテストメッセージを送信します。
@userinfobotを使用するか、https://api.telegram.org/bot<YOUR_TOKEN>/getUpdatesをcurlで叩いて数値のChat IDを取得します。- Kumaで「Telegram」を選択し、トークンとChat IDを入力して「Test(テスト)」をクリックします。2秒以内にスマホに通知音が鳴るはずです。
選択肢B:Discord Webhookの統合
- Discordサーバーで「サーバー設定」>「連携」>「ウェブフック」に移動します。
- 「新しいウェブフック」をクリックし、通知先のアラートチャンネル(例:
#homelab-alerts)を選択して、生成されたWebhook URLをコピーします。 - Kumaの通知リストから「Discord」を選択し、URLを貼り付けて保存します。
「Default enabled on all existing monitors(すべての既存モニターでデフォルト有効)」をチェックしておけば、今後追加するプローブにも自動的に通知チャンネルが適用されます。
ステップ4:洗練されたステータスページの公開
家族や同居ユーザーにインフラダッシュボードへの完全な管理者権限を与えることなく、稼働状況を共有できます。Kumaには美しく独立したステータスページ機能が標準搭載されています。
- 上部メニューの「Status Pages(ステータスページ)」をクリックし、「New Status Page(新しいステータスページ)」を選択します。
servicesなどのわかりやすいスラッグを設定します(これにより/status/servicesというパスが生成されます)。- タイトルを指定し、カスタムロゴをアップロードして、「Media Stack(Plex、Jellyfin)」「Network Core(Pi-hole、ルーター)」「Storage(TrueNAS、Nextcloud)」などのサービスグループを作成します。
- ホストのカーネルアップデートや物理ディスクの交換を計画している場合は、説明文を追加したり定期メンテナンスの告知をピン留めしたりできます。
ホームラボで半年間本番運用して得られた知見
現在私のKumaインスタンスは34のエンドポイントを常時監視しています。SQLiteデータベース(./kuma-data/kuma.db)は、標準の90日間保持設定で約110MB程度に収まっています。Intel Celeron N5105上でのCPU負荷も常に0.5%未満を維持しています。
試行錯誤の末に見出した、導入すべきチューニングのルールをいくつか紹介します:
- 5秒間隔のポーリングはやめる:間隔が短すぎると、Dockerのガベージコレクションや重いバックアップスナップショットの実行中に誤検知を引き起こします。60秒間隔+リトライ2回の設定にすることで、無駄な通知ノイズを排除しつつ、実際のクラッシュを3分以内に検知できます。
- データベースのバックアップを自動化する:認証情報、プローブ履歴、ステータス設定に至るまで、Kumaが保持する全データは
kuma.dbに保存されています。./kuma-dataフォルダーに対してrsyncやBorgを使った日次バックアップを実行しておきましょう。 - 死活監視とホストテレメトリを分離する:Kumaはステータス検知(「サービスが応答しているか?」)専用として運用してください。メモリの飽和度、CPUスパイク、IOPSグラフなどのメトリクス監視は、PrometheusやNetdata、Grafanaに任せるのが得策です。
Docker ComposeとWebhook通知の設定にかける30分は、将来の何時間ものデバッグ作業を節約してくれます。夕食時に誰かから苦情を言われる前に、コンテナのクラッシュをその場で把握できるようにしましょう。