Bối cảnh & Lý do
Vào lúc 2:14 sáng, PagerDuty đánh thức tôi dậy với hàng loạt cảnh báo dồn dập từ bot báo cáo điều hành. Các lãnh đạo cấp cao đang hỏi những câu hỏi cơ bản về doanh thu quý 3, và hệ thống thì tự bịa ra những con số từ hư không. Xem lại trace log, nguyên nhân đổ vỡ đã quá rõ ràng.
Worker OCR của chúng tôi đã phá hỏng hoàn toàn một bảng tài chính ba cột có các chú thích lồng nhau. Nó ép phẳng mọi thứ thành một chuỗi văn bản thô rời rạc, rồi pipeline của chúng tôi cứ thế chia chunk và nhúng mù quáng vào pgvector. LLM nhận về ngữ cảnh hoàn toàn là rác. Dĩ nhiên, nó bắt đầu ảo giác (hallucinate) với sự tự tin tuyệt đối.
Hầu hết các hệ thống RAG trên môi trường production vẫn phụ thuộc vào pipeline mỏng manh này. Bạn trích xuất luồng PDF thô hoặc chạy PaddleOCR, dọn dẹp markdown, chia nhỏ văn bản thành các chunk 500 token tùy ý, tính toán dense embedding và chạy vector search. Mọi thứ vẫn ổn cho đến khi bạn gặp phải các bố cục (layout) phức tạp. Bảng cân đối kế toán bị mất tọa độ cột. Tài liệu whitepaper hai cột bị đọc ngang qua các cột thay vì đọc dọc xuống. Biểu đồ và infographic đơn giản là biến mất hoàn toàn.
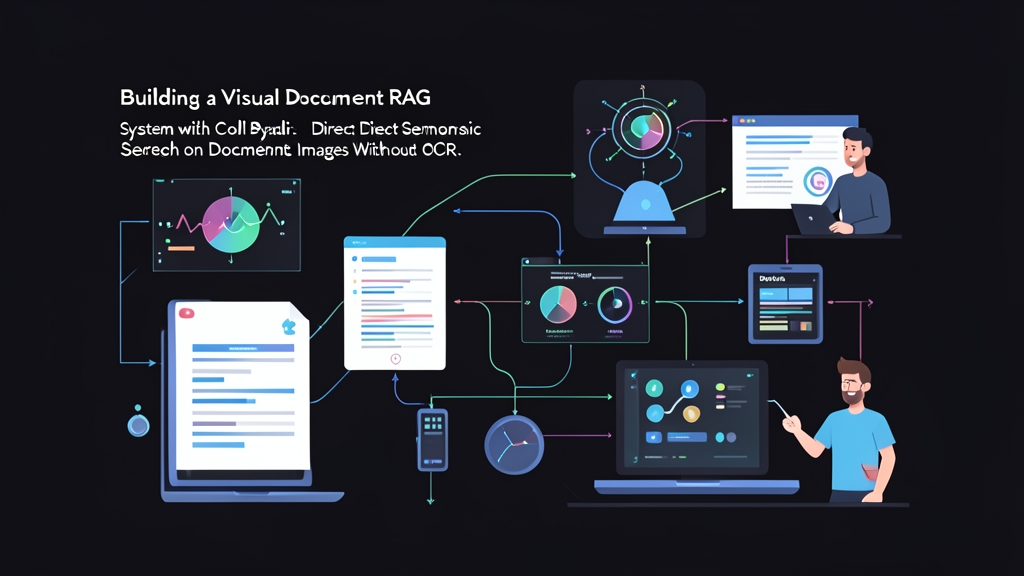
ColPali loại bỏ hoàn toàn bước trích xuất văn bản. Thay vì phải đoán luồng bố cục, nó rasterize từng trang PDF thành một hình ảnh 448×448 và đưa trực tiếp vào một Vision-Language Model (xây dựng trên nền PaliGemma-3B).
Mô hình xuất ra các patch embedding dạng multi-vector—khoảng 1.030 vector mỗi trang với 128 chiều—sử dụng cơ chế late interaction theo phong cách ColBERT (MaxSim). Byaldi là thư viện wrapper bằng Python đóng gói ColPali thành một công cụ index mà bạn có thể chạy chỉ với vài dòng code. Bảng biểu, kiểu chữ, tiêu đề và biểu đồ thu nhỏ (sparkline) vẫn được neo trực quan đúng vị trí vốn có của chúng.
Việc từ bỏ các bộ trích xuất văn bản để chuyển sang visual late-interaction đã giảm triệt để lỗi phân tích tài liệu về con số 0 đối với các báo cáo 10-K và tài liệu kỹ thuật phức tạp. Dưới đây là cách triển khai giải pháp này trên hạ tầng của riêng bạn.
Cài đặt
ColPali tính toán biểu diễn token trên các patch hình ảnh. Mặc dù quá trình inference tương đối nhanh, nhưng việc xây dựng index đòi hỏi dung lượng bộ nhớ GPU đáng kể. Bạn sẽ cần một card NVIDIA có ít nhất 16GB VRAM—RTX 4090, A5000, hoặc một cloud instance A10G đều hoạt động tốt.
Bắt đầu bằng cách cài đặt các gói render PDF ở cấp hệ thống. Bên dưới tầng xử lý, Byaldi chuyển đổi các trang thành hình ảnh bằng pdf2image, thư viện này yêu cầu poppler-utils.
# Thiết lập trên Ubuntu / Debian
sudo apt-get update && sudo apt-get install -y poppler-utils libgl1-mesa-glx

# Xác nhận binary poppler đã tồn tại
pdftoppm -v
Thiết lập một môi trường ảo cô lập với PyTorch và CUDA. Đảm bảo phiên bản CUDA runtime khớp với phiên bản PyTorch wheel để tránh các lỗi segmentation fault phiền toái trong quá trình tính toán tensor.
# Tạo và kích hoạt môi trường ảo
python3 -m venv venv-byaldi
source venv-byaldi/bin/activate

# Cài đặt PyTorch với hỗ trợ CUDA 12.1
pip install --upgrade pip
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121

# Cài đặt Byaldi và Flash Attention 2 để tăng tốc forward pass
pip install byaldi
pip install flash-attn --no-build-isolation
Bị kẹt ở lỗi biên dịch flash-attn? Hãy đảm bảo đường dẫn CUDA_HOME của bạn trỏ tới bản cài đặt đầy đủ của CUDA toolkit (ví dụ: /usr/local/cuda). Nếu bạn chạy trong môi trường không có sẵn các công cụ build, bạn có thể bỏ qua flash-attn; cơ chế SDPA mặc định của PyTorch sẽ tự động được sử dụng để thay thế.
Cấu hình
Byaldi tự động xử lý toàn bộ việc tải tài liệu, tạo embedding và lưu trữ index. Checkpoint cơ sở vidore/colpali-v1.2 mang lại độ chính xác zero-shot rất tốt trên nhiều loại tài liệu đa ngôn ngữ, bản scan và các báo cáo dày đặc dữ liệu.
Lưu script này thành indexer.py để index hàng loạt toàn bộ một thư mục chứa các file PDF:
import os
from byaldi import RAGMultiModalModel

INDEX_NAME = "financial_reports_index"
DOCS_DIR = "/var/data/pdf_vault"

def build_document_index():
    print("[INIT] Đang tải mô hình ColPali vào VRAM...")
    RAG = RAGMultiModalModel.from_pretrained(
        "vidore/colpali-v1.2",
        verbose=1
    )

    print(f"[INDEX] Đang quét {DOCS_DIR} và index các trang...")
    RAG.index(
        input_path=DOCS_DIR,
        index_name=INDEX_NAME,
        store_collection_with_index=True,
        overwrite=True
    )
    print(f"[SUCCESS] Đã ghi index vào .byaldi/{INDEX_NAME}")

if __name__ == "__main__":
    os.makedirs(DOCS_DIR, exist_ok=True)
    build_document_index()
Sau khi xây dựng index, hãy tạo dịch vụ truy vấn (search.py). Bước này sẽ truy vấn các vector đã được tính toán trước mà không cần nạp lại các tài liệu PDF gốc vào bộ nhớ. Nó trả về số trang khớp nhất, ID file và ảnh chụp toàn bộ trang.
from byaldi import RAGMultiModalModel

INDEX_NAME = "financial_reports_index"

def query_visual_rag(query_text: str, top_k: int = 3):
    # Tải index đã được tuần tự hóa
    RAG = RAGMultiModalModel.from_index(INDEX_NAME)

    # Chạy tìm kiếm late-interaction MaxSim
    results = RAG.search(query=query_text, k=top_k)

    print(f"\nTruy vấn: '{query_text}'")
    print(f"Đã trả về {len(results)} kết quả khớp:\n" + "-" * 45)

    for rank, hit in enumerate(results, start=1):
        doc_id = hit.doc_id
        page_num = hit.page_num
        score = hit.score
        print(f"#{rank} | Tài liệu: {doc_id} | Trang: {page_num} | Điểm số: {score:.3f}")

        # Mẹo: Gửi trực tiếp hit.base64 tới một mô hình đa phương thức như Claude 3.5 Sonnet hoặc GPT-4o
        # page_base64 = hit.base64

    return results

if __name__ == "__main__":
    # Truy vấn thử nghiệm với dữ liệu bảng lồng nhau
    query_visual_rag("Biên lợi nhuận hoạt động ròng của chúng ta trên toàn châu Âu trong quý 3 năm 2024 là bao nhiêu?")
Kiểm thử & Giám sát
Đừng vội đưa visual retrieval lên production mà chưa có các benchmark đối chuẩn ban đầu. Bạn cần xác minh cả độ liên quan của kết quả tìm kiếm lẫn tính ổn định của GPU dưới tải thực tế.
1. Kiểm tra độ chính xác truy xuất bố cục
Hãy viết integration test với những câu truy vấn thường xuyên làm khó các bộ parser văn bản tiêu chuẩn. Những mục tiêu kiểm tra lý tưởng bao gồm giá trị ô nằm sâu trong các bảng không có viền, các chú thích chân trang và phần chú giải trong biểu đồ.
# Đo độ trễ thực thi truy vấn
python -m timeit -n 10 -s "from search import query_visual_rag" "query_visual_rag('Biên lợi nhuận EBITDA năm tài chính 2024')"
Trong thực tế, điểm tương đồng MaxSim của ColPali dao động từ 12.0 đến 28.0. Điểm số trên 19.5 cho thấy sự tương quan chặt chẽ và đáng tin cậy cả về mặt ngữ nghĩa lẫn hình ảnh trực quan. Nếu các kết quả hàng đầu của bạn chỉ quanh quẩn dưới 14.0, khả năng cao là tài liệu không chứa câu trả lời, hoặc câu truy vấn cần được diễn đạt lại.
2. Giám sát VRAM GPU và kích thước batch
Quá trình rasterize các file PDF độ phân giải cao (chẳng hạn như bản scan 300–600 DPI) tiêu tốn lượng bộ nhớ GPU rất lớn trong lúc nạp dữ liệu hàng loạt. Nếu không kiểm soát, điều này sẽ dẫn thẳng tới sự cố lỗi tràn bộ nhớ CUDA OOM.
Hãy mở một terminal để theo dõi lượng tiêu thụ VRAM trong quá trình nạp dữ liệu:
watch -n 1 nvidia-smi --query-gpu=timestamp,utilization.gpu,memory.used,memory.total --format=csvNếu mức sử dụng bộ nhớ vượt quá 85% trên GPU 16GB, hãy downsample các tài liệu PDF trước khi nạp. Một lượt xử lý nhanh bằng Ghostscript sẽ giúp giảm dung lượng file mà vẫn giữ nguyên độ rõ nét cho PaliGemma:
# Giảm độ phân giải bản scan nặng 600 DPI xuống 150 DPI cho màn hình
gs -sDEVICE=pdfwrite -dCompatibilityLevel=1.4 -dPDFSETTINGS=/ebook \
   -dNOPAUSE -dQUIET -dBATCH -sOutputFile=optimized_doc.pdf raw_input.pdf
3. Độ trễ production và hoạch định dung lượng
Visual retrieval sẽ thay đổi các điểm nghẽn hạ tầng của bạn. Hãy ghi nhớ các chỉ số benchmark trên production sau:
- Độ trễ truy vấn (Query Latency): Dự kiến các truy vấn sẽ hoàn tất trong khoảng 120ms đến 280ms trên một GPU A10G đơn lẻ. Độ trễ tăng đột biến trên 600ms thường là dấu hiệu của việc tranh chấp luồng CPU trong quá trình nhân ma trận.
- Dung lượng lưu trữ: Khác với embedding dạng single-vector chỉ tiêu tốn khoảng ~3KB mỗi trang, ColPali lưu trữ biểu diễn dạng multi-vector. Dự kiến mức sử dụng đĩa sẽ rơi vào khoảng ~25MB đến 40MB cho mỗi 100 trang được index khi dùng chuẩn nén binary/PLAID của Byaldi.
- Xử lý lỗi mềm dẻo (Graceful Degradation): Hãy bọc
RAG.search()trong khối try/except bắt lỗitorch.cuda.OutOfMemoryError. Nếu hết VRAM, hãy giải phóng bộ nhớ đệm của PyTorch bằngtorch.cuda.empty_cache()và chuyển hướng dự phòng về index từ khóa BM25 sẵn có thay vì làm gián đoạn yêu cầu của người dùng.
Visual document retrieval khắc phục mắt xích yếu nhất trong các hệ thống RAG hiện đại. Bằng cách xem các trang tài liệu như những khung hình trực quan thay vì các chuỗi văn bản phẳng, ColPali và Byaldi mang lại câu trả lời đáng tin cậy từ những bố cục phức tạp mà không cần đến các biểu thức chính quy (regex) mong manh hay các tác vụ OCR dễ lỗi.