Sự Cố Lúc 2:00 Sáng: Chuyện Gì Xảy Ra Khi Gateway Sập
Sáu tháng trước, API gateway chính của chúng tôi gặp sự cố hỏng nguồn nghiêm trọng ngay giữa đợt flash sale với lưu lượng lên tới 14.000 requests mỗi giây. Phía sau reverse proxy, bốn node ứng dụng vẫn hoàn toàn khỏe mạnh. Nhưng điều đó chẳng có ý nghĩa gì. Toàn bộ nền tảng bị sập trong suốt 42 phút chỉ vì toàn bộ traffic từ client đều trỏ về một địa chỉ IP vật lý duy nhất trên chiếc máy chủ bị chết đó.
Lưu lượng truy cập ập vào như đâm đầu vào tường đá. PagerDuty đánh thức nửa đội ngũ kỹ thuật, các kỹ sư trực on-call cuống cuồng chỉnh sửa DNS A-record, và chúng tôi phải bất lực nhìn độ trễ phân giải TTL thiêu rụi toàn bộ error budget. Sự cố này đã phơi bày một sự thật cay đắng: hệ thống dự phòng backend trở nên hoàn toàn vô nghĩa nếu ingress gateway của bạn là một điểm nghẽn chịu lỗi đơn lẻ (single point of failure).
Vì Sao Các Giải Pháp Failover Thông Thường Không Hiệu Quả
Trước khi bắt tay vào triển khai giải pháp, chúng tôi đã rà soát lại các phương án failover phổ biến để xem chúng bộc lộ điểm yếu ở đâu trong pipeline của mình:
- DNS Round Robin và GeoDNS: Failover dựa trên DNS nghe có vẻ đơn giản trên lý thuyết. Nhưng trong thực tế, các public resolver, nhà mạng di động và proxy doanh nghiệp thường phớt lờ mức TTL 30 giây của bạn. Họ lưu cache các bản ghi cũ hàng giờ liền, khiến người dùng bị kẹt lại ở các IP đã chết.
- Gán Lại IP Tĩnh Qua Cloud API: Việc gán lại secondary IP bằng các công cụ CLI hoặc API webhook của nhà cung cấp đám mây mất từ 25 đến 90 giây. Khoảng thời gian trễ này đủ để làm rớt hàng nghìn kết nối TCP đang hoạt động và gây đột biến lỗi HTTP 502/504.
- Kiểm Tra Ping Cơ Bản: ICMP ping chỉ cho bạn biết kernel Linux có đang chạy hay không. Chúng không thể phát hiện tiến trình HAProxy hoặc Nginx bị chết khi máy chủ bên dưới vẫn phản hồi bình thường.
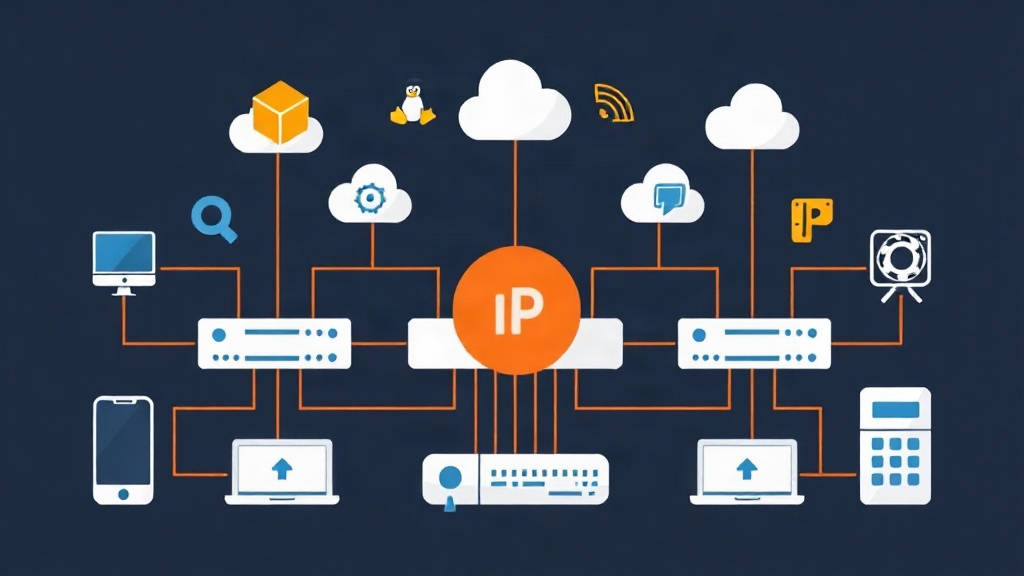
Chúng tôi cần một cơ chế tự động ở Layer 3 và Layer 4. Cơ chế này phải chia sẻ một Virtual IP (VIP) nổi (floating) duy nhất giữa các máy chủ, phát gói tin heartbeat liên tục và kích hoạt chuyển đổi dự phòng (failover) trong vòng chưa đầy một giây mà không cần can thiệp vào DNS của client.
So Sánh Các Giải Pháp Failover
Chúng tôi đã đánh giá hiệu năng của ba giải pháp phổ biến trên môi trường bare-metal Linux và private VPC của mình:
| Giải pháp | Tốc độ Failover | Độ phức tạp | Phù hợp nhất |
|---|---|---|---|
| Pacemaker + Corosync | 1–3 giây | Cao (Yêu cầu STONITH/fencing) | Dịch vụ stateful, cụm database active-passive |
| BGP Anycast (FRR) | <500 ms | Rất cao (Yêu cầu BGP peering & quyền kiểm soát router) | Edge đa trung tâm dữ liệu, mạng transit ISP |
| Keepalived (VRRP) | <1 giây (~800 ms) | Thấp đến Trung bình | Stateless gateway, tầng ingress HAProxy/Nginx |
Pacemaker rất vững chắc cho các cụm PostgreSQL nhằm tránh split-brain gây hỏng dữ liệu ổ đĩa, nhưng nó lại quá phức tạp (overkill) cho tầng web ingress stateless. BGP Anycast rất tuyệt vời nhưng đòi hỏi phải phối hợp chặt chẽ với đội ngũ mạng và chạy routing daemon trên từng node. Keepalived kết hợp cùng VRRP (Virtual Router Redundancy Protocol) chính là điểm cân bằng hoàn hảo: khôi phục gần như tức thì, tiêu tốn cực ít tài nguyên CPU và chỉ cần một file cấu hình duy nhất.
Từng Bước Triển Khai: Cài Đặt Keepalived Với Health Check Chủ Động
Trong suốt sáu tháng qua, cấu hình này đã xử lý trơn tru các đợt cập nhật kernel, khởi động lại node theo lịch trình và cả một sự cố hỏng switch top-of-rack đột xuất mà không làm rớt bất kỳ request nào của client.
1. Thông Số Mạng Cơ Bản
Cụm staging của chúng tôi sử dụng hai node Ubuntu 24.04 đóng vai trò làm load balancer HAProxy:
- Node chính (Node-01):
192.168.10.11(Interface:eth0) - Node phụ (Node-02):
192.168.10.12(Interface:eth0) - VIP dùng chung:
192.168.10.100
2. Cho Phép Socket Binding Địa Chỉ Non-Local
Khi Node-02 khởi động ở chế độ backup, VIP chưa được gán vào interface cục bộ của nó. Theo mặc định, Linux sẽ từ chối các nỗ lực bind dịch vụ vào địa chỉ IP mà máy chủ hiện không sở hữu. Chúng ta cần bật cờ kernel ip_nonlocal_bind để HAProxy có thể bind vào 192.168.10.100:443 trên cả hai máy chủ cùng một lúc:
# Áp dụng ngay lập tức
sudo sysctl -w net.ipv4.ip_nonlocal_bind=1

# Lưu cấu hình sau khi reboot
echo "net.ipv4.ip_nonlocal_bind = 1" | sudo tee /etc/sysctl.d/99-keepalived.conf
sudo sysctl --system
3. Cài Đặt Package
Cài đặt Keepalived trên cả hai máy:
# Debian / Ubuntu
sudo apt update && sudo apt install -y keepalived

# RHEL / Rocky / AlmaLinux
sudo dnf install -y keepalived
4. Cấu Hình Master Node
Ghi cấu hình này vào file /etc/keepalived/keepalived.conf trên Node-01. Chúng ta cấu hình một script health check để kiểm tra trực tiếp PID của HAProxy. Nếu daemon ngừng phản hồi, Keepalived sẽ hạ priority của Node-01 xuống thấp hơn Node-02, kích hoạt quá trình chuyển giao mượt mà:
global_defs {
    router_id lb-node-01
    enable_script_security
    script_user root
}

# Kiểm tra xem tiến trình HAProxy có đang chạy không
vrrp_script check_proxy {
    script "/usr/bin/killall -0 haproxy"
    interval 2     # Chạy kiểm tra mỗi 2 giây
    weight -20     # Giảm priority đi 20 nếu kiểm tra thất bại
    fall 2         # Yêu cầu 2 lần thất bại liên tiếp
    rise 2         # Yêu cầu 2 lần thành công liên tiếp để phục hồi
}

vrrp_instance VI_GATEWAY {
    state MASTER
    interface eth0
    virtual_router_id 51
    priority 101   # Trọng số khởi tạo cao hơn giúp Node-01 làm node chính
    advert_int 1

    authentication {
        auth_type PASS
        auth_pass VrrpP@ss  # Giới hạn tối đa 8 ký tự theo RFC2338
    }

    virtual_ipaddress {
        192.168.10.100/24 dev eth0 label eth0:vip
    }

    track_script {
        check_proxy
    }
}
5. Cấu Hình Backup Node
Trên Node-02, đặt cấu hình tương ứng với priority cơ bản là 100 và state được đặt thành BACKUP:
global_defs {
    router_id lb-node-02
    enable_script_security
    script_user root
}

vrrp_script check_proxy {
    script "/usr/bin/killall -0 haproxy"
    interval 2
    weight -20
    fall 2
    rise 2
}

vrrp_instance VI_GATEWAY {
    state BACKUP
    interface eth0
    virtual_router_id 51
    priority 100   # Thấp hơn mức 101 của Node-01
    advert_int 1

    authentication {
        auth_type PASS
        auth_pass VrrpP@ss
    }

    virtual_ipaddress {
        192.168.10.100/24 dev eth0 label eth0:vip
    }

    track_script {
        check_proxy
    }
}
6. Khởi Động Dịch Vụ Và Kiểm Tra Trạng Thái
Khởi động Keepalived trên cả hai máy chủ:
sudo systemctl enable --now keepalivedChạy lệnh ip addr show eth0 trên Node-01. IP alias ảo sẽ xuất hiện ngay lập tức:
inet 192.168.10.11/24 brd 192.168.10.255 scope global eth0
inet 192.168.10.100/24 scope global secondary eth0:vip
Chạy cùng lệnh đó trên Node-02. IP alias này sẽ không xuất hiện. Nó sẽ ở trạng thái chờ cho đến khi sự cố failover xảy ra.
7. Kiểm Thử Tải và Kịch Bản Failover
Đừng bao giờ mặc định cụm cluster hoạt động tốt trừ khi bạn đã chủ động giả lập sự cố. Chúng tôi đã thực hiện hai kịch bản lỗi thực tế trong quá trình kiểm thử:
- Giả Lập Sập Dịch Vụ: Chúng tôi dừng HAProxy trên Node-01 (
sudo systemctl stop haproxy). Sau 4 giây (hai lần kiểm tra thất bại cách nhau 2 giây), priority hiệu dụng của Node-01 giảm từ 101 xuống 81. Node-02 tiếp quản vai trò Master và ngay lập tức phát broadcast một frame Gratuitous ARP (GARP). Công cụ benchmark HTTP liên tục của chúng tôi ghi nhận chính xác 0 kết nối bị rớt và chỉ có một độ trễ nhỏ tăng 12 ms duy nhất. - Sự Cố Phần Cứng Đột Ngột: Chúng tôi rút dây nguồn của Node-01 một cách đột ngột. Node-02 mất 3 gói tin advertisement liên tiếp (3 giây) và tự động nắm quyền điều khiển
192.168.10.100.
Những Bài Học Đắt Giá Sau 6 Tháng Vận Hành Production
Triển khai Keepalived đã dạy cho chúng tôi một số trường hợp biên (edge case) mà tài liệu hướng dẫn hiếm khi đề cập chi tiết:
- Môi Trường Public Cloud Chặn Multicast: VRRP tiêu chuẩn sử dụng địa chỉ multicast
224.0.0.18. AWS VPC, GCP và Azure loại bỏ hoàn toàn các frame multicast ở Layer 2. Nếu triển khai trong VPC đám mây, hãy thêm các blockunicast_src_ipvàunicast_peer { <peer-ip> }vào bên trongvrrp_instancecủa bạn. - Cho Phép Giao Thức Protocol 112 Một Cách Rõ Ràng: Nếu tường lửa cục bộ (UFW hoặc firewalld) chặn IP protocol 112, cả hai node sẽ không nhận được các gói tin advertisement của nhau. Khi đó, cả hai sẽ tự thăng cấp lên làm Master cùng lúc (split-brain) và tranh chấp phản hồi ARP. Hãy thêm một rule tường lửa rõ ràng:
sudo ufw allow proto 112 from 192.168.10.0/24. - Giữ Mật Khẩu Dưới 8 Ký Tự: Chuẩn VRRP (RFC 2338) cắt ngắn mật khẩu cleartext xuống còn 8 byte. Các ký tự thừa sẽ bị tự động loại bỏ trên một số bản phân phối Linux, dẫn đến lỗi bất đồng bộ xác thực rất khó hiểu trong các buổi diễn tập failover thủ công.