午前2時の障害:ゲートウェイが停止したときに何が起きるか
6ヶ月前、秒間14,000リクエストを処理するフラッシュセールの真っ只中に、プライマリAPIゲートウェイで電源装置の致命的な故障が発生しました。リバースプロキシの背後には4台の正常なアプリケーションノードが稼働していましたが、何の意味もありませんでした。すべてのクライアントトラフィックが、ダウンしたマシン上の単一の物理IPアドレスへとルーティングされていたため、プラットフォーム全体が42分間にわたり完全に停止したのです。
流入トラフィックは行き場を失いました。PagerDutyのアラートでエンジニアリングチームの半数が叩き起こされ、オンコール担当者はDNSのAレコード書き換えに奔走しましたが、TTLの伝播遅延によってエラーバジェットはみるみる消費されていきました。このインシデントは、厳しい現実を浮き彫りにしました。Ingressゲートウェイが単一障害点(SPOF)になっている場合、バックエンドをいくら冗長化していても全く役に立たないということです。
一般的なフェイルオーバー手法が通用しない理由
解決策の選定に入る前に、一般的なフェイルオーバー手法を検証し、私たちのパイプラインにおいてどこに問題があるのかを洗い出しました。
- DNSラウンドロビンとGeoDNS: DNSベースのフェイルオーバーは机上ではシンプルに見えます。しかし実際には、パブリックリゾルバやモバイルキャリア、企業内プロキシが30秒のTTL設定を無視することがよくあります。古いレコードが数時間キャッシュされ、アクティブなユーザーがダウンしたIPに取り残されてしまいます。
- クラウドAPI経由の静的IP再割り当て: クラウドベンダーのCLIツールやAPI Webhookを使ってセカンダリIPを付け替える処理には、25〜90秒ほどかかります。この遅延によって数千ものアクティブなTCP接続が切断され、HTTP 502/504エラーが急増します。
- 単純なPingプローブ: ICMP PingはLinuxカーネルが生存しているかどうかしか確認できません。基盤ホスト自体が応答していても、HAProxyやNginxプロセスが停止している場合には検知できません。
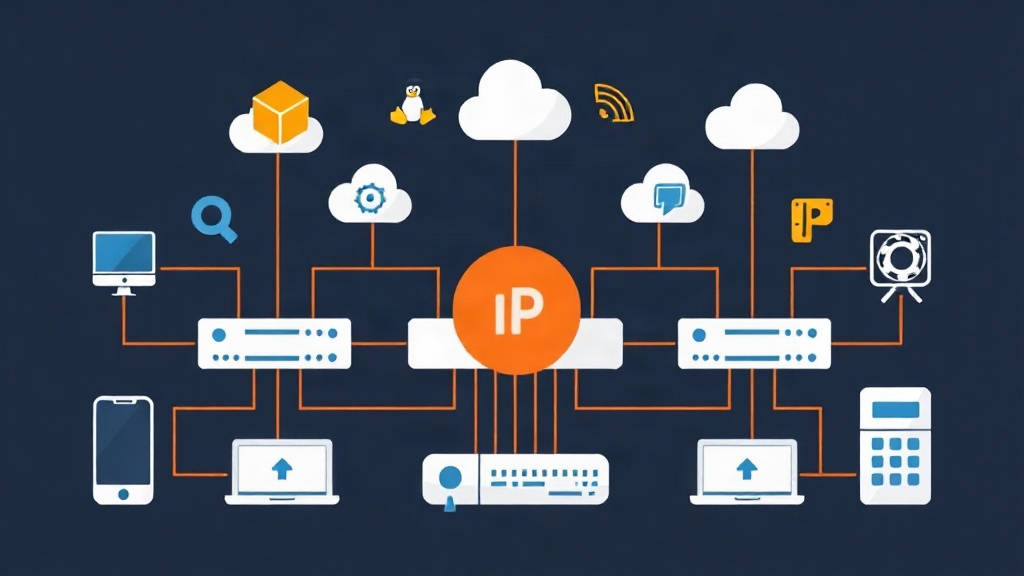
私たちが必要としていたのは、自動化されたレイヤー3およびレイヤー4の仕組みでした。サーバー間で単一のフローティングVirtual IP(VIP)を共有し、ハートビートパケットをブロードキャストして、クライアント側のDNSに依存することなく1秒未満でフェイルオーバーを実行できる構成です。
フェイルオーバー構成の比較
Linuxベアメタル環境およびプライベートVPC環境において、代表的な3つのアプローチをベンチマーク比較しました。
| ソリューション | フェイルオーバー速度 | 複雑さ | 最適な用途 |
|---|---|---|---|
| Pacemaker + Corosync | 1〜3秒 | 高(STONITH/フェンシングが必要) | ステートフルなサービス、アクティブ-パッシブ構成のデータベースペア |
| BGP Anycast (FRR) | <500 ms | 極めて高(BGPピアリングとルーター制御が必要) | マルチデータセンターのエッジ、ISPトランジットネットワーク |
| Keepalived (VRRP) | <1秒(約800 ms) | 低〜中程度 | ステートレスゲートウェイ、HAProxy/NginxのIngress層 |
Pacemakerは、スプリットブレインによる書き込みでディスク状態が破損するリスクがあるPostgreSQLクラスターなどには堅牢な選択肢ですが、ステートレスなWeb Ingressに対してはオーバースペックです。BGP Anycastは優れていますが、ネットワークチームとの調整や各ノードでのルーティングデーモン運用が必要です。VRRP(Virtual Router Redundancy Protocol)を採用したKeepalivedは、瞬時のリカバリ、極めて小さいCPUオーバーヘッド、単一の設定ファイルという点で、まさにベストな落としどころでした。
実践ガイド:アクティブヘルスチェックを備えたKeepalivedのデプロイ手順
この6ヶ月間、この構成によってカーネルアップデート、計画的なノード再起動、そして予期せぬトップオブラックスイッチの障害が発生した際も、クライアントリクエストを1件も落とすことなく乗り切ることができました。
1. ネットワーク前提条件
検証クラスターでは、HAProxyロードバランサーとして動作する2台のUbuntu 24.04ノードを使用しています。
- プライマリノード (Node-01):
192.168.10.11(インターフェース:eth0) - バックアップノード (Node-02):
192.168.10.12(インターフェース:eth0) - 共有VIP:
192.168.10.100
2. ノンローカルソケットバインドの許可
Node-02がバックアップモードで起動している際、VIPはまだローカルインターフェースに割り当てられていません。デフォルトのLinuxでは、ホストが現在保持していないアドレスへのサービスバインドを拒否します。HAProxyが両方のマシンで192.168.10.100:443に同時にバインドできるようにするため、ip_nonlocal_bindカーネルパラメータを有効化する必要があります。
# 即時適用
sudo sysctl -w net.ipv4.ip_nonlocal_bind=1

# 再起動後も永続化
echo "net.ipv4.ip_nonlocal_bind = 1" | sudo tee /etc/sysctl.d/99-keepalived.conf
sudo sysctl --system
3. パッケージのインストール
両方のマシンにKeepalivedをインストールします。
# Debian / Ubuntu
sudo apt update && sudo apt install -y keepalived

# RHEL / Rocky / AlmaLinux
sudo dnf install -y keepalived
4. マスターノードの設定
Node-01の/etc/keepalived/keepalived.confに以下の設定を記述します。ここではHAProxyのPIDを直接確認するヘルスチェックスクリプトを設定しています。デーモンが応答を停止した場合、KeepalivedはNode-01の優先度(priority)をNode-02よりも低く引き下げ、正常なハンドオーバーをトリガーします。
global_defs {
    router_id lb-node-01
    enable_script_security
    script_user root
}

# HAProxyプロセスが実行中か確認
vrrp_script check_proxy {
    script "/usr/bin/killall -0 haproxy"
    interval 2     # 2秒ごとにチェックを実行
    weight -20     # チェック失敗時に優先度を20下げる
    fall 2         # 2回連続失敗で障害と判定
    rise 2         # 2回連続成功で復旧と判定
}

vrrp_instance VI_GATEWAY {
    state MASTER
    interface eth0
    virtual_router_id 51
    priority 101   # 初期優先度を高く設定しNode-01をプライマリに維持
    advert_int 1

    authentication {
        auth_type PASS
        auth_pass VrrpP@ss  # RFC2338に準拠し最大8文字に制限
    }

    virtual_ipaddress {
        192.168.10.100/24 dev eth0 label eth0:vip
    }

    track_script {
        check_proxy
    }
}
5. バックアップノードの設定
Node-02には、基本優先度を100に設定し、stateをBACKUPにした対応する設定を配置します。
global_defs {
    router_id lb-node-02
    enable_script_security
    script_user root
}

vrrp_script check_proxy {
    script "/usr/bin/killall -0 haproxy"
    interval 2
    weight -20
    fall 2
    rise 2
}

vrrp_instance VI_GATEWAY {
    state BACKUP
    interface eth0
    virtual_router_id 51
    priority 100   # Node-01の101より低い値
    advert_int 1

    authentication {
        auth_type PASS
        auth_pass VrrpP@ss
    }

    virtual_ipaddress {
        192.168.10.100/24 dev eth0 label eth0:vip
    }

    track_script {
        check_proxy
    }
}
6. サービスの起動と状態確認
両方のホストでKeepalivedを起動します。
sudo systemctl enable --now keepalivedNode-01でip addr show eth0を実行します。仮想IPエイリアスが即座に表示されます。
inet 192.168.10.11/24 brd 192.168.10.255 scope global eth0
inet 192.168.10.100/24 scope global secondary eth0:vipNode-02でも同じコマンドを実行します。こちらにはエイリアスが表示されないはずです。フェイルオーバーが発生するまで待機状態を維持します。
7. フェイルオーバー動作のストレステスト
意図的に障害を発生させて検証するまで、クラスターが正常に動作していると思い込んではいけません。テストでは2つの実践的な障害シナリオを実行しました。
- サービスクラッシュのシミュレーション: Node-01上のHAProxyを停止しました(
sudo systemctl stop haproxy)。4秒後(2秒間隔のチェックが2回失敗)、Node-01の実効優先度は101から81に低下しました。Node-02がMasterに昇格して即座にGARP(Gratuitous ARP)フレームをブロードキャストしました。継続的なHTTP合成ベンチマークにおいて、切断された接続はゼロ件で、記録されたのは一度の12ミリ秒のレイテンシスパイクのみでした。 - 物理ハードウェア障害: Node-01の電源ケーブルを不意に引き抜きました。Node-02は3回連続でアドバタイズメントを受信できず(3秒間)、自動的に
192.168.10.100の制御を引き継ぎました。
本番環境での6ヶ月運用から得られた教訓
Keepalivedを運用する中で、公式ドキュメントではあまり強調されていないエッジケースに遭遇しました。
- パブリッククラウド環境はマルチキャストをブロックする: 標準のVRRPはマルチキャストアドレス
224.0.0.18を使用します。AWS VPC、GCP、Azureなどはレイヤー2のマルチキャストフレームを完全に破棄します。クラウドVPC内にデプロイする場合は、vrrp_instance内にunicast_src_ipとunicast_peer { <peer-ip> }の設定ブロックを追加してください。 - プロトコル112を明示的に許可する: ローカルファイアウォール(UFWやfirewalld)がIPプロトコル112をブロックしていると、両ノードがお互いのアドバタイズメントを受信できなくなります。その結果、両方が同時にMasterに昇格(スプリットブレイン)し、ARP応答の競合が発生します。
sudo ufw allow proto 112 from 192.168.10.0/24のように明示的な許可ルールを追加してください。 - パスワードは8文字以内に抑える: VRRP標準(RFC 2338)では、プレーンテキストパスワードは8バイトに切り詰められます。一部のディストリビューションでは8文字を超える文字が警告なしに破棄され、手動フェイルオーバー訓練時に認証の不一致エラーが発生して混乱の原因となります。