So sánh các phương pháp tiếp cận: Pure Vector vs. Keyword vs. Hybrid Search
Dữ liệu đầu vào quyết định chất lượng đầu ra (Garbage in, garbage out). Trong Retrieval-Augmented Generation (RAG), chất lượng nội dung sinh ra phụ thuộc trực tiếp vào ngữ cảnh được truy xuất.
Các đội ngũ kỹ sư thường bắt đầu với dense vector search vì những mô hình như text-embedding-3-small của OpenAI nắm bắt rất tốt ý định ngữ nghĩa tổng thể. Thế nhưng, vector lại tỏ ra yếu thế trước các truy vấn khớp chính xác. Khi tìm kiếm một mã SKU như SKU-9921-X, một mã lỗi như ERR_AUTH_4019, hay tên hàm như pthread_mutex_lock, tìm kiếm thuần vector thường trả về những chunk tài liệu có liên quan về mặt ngữ cảnh nhưng hoàn toàn vô dụng về mặt chức năng.
Lexical search (thường là BM25) hoạt động theo hướng ngược lại. Nó tính toán tần suất xuất hiện của từ (term frequency) và tần suất nghịch đảo trong tài liệu (inverse document frequency) trên toàn bộ kho ngữ liệu để xếp hạng các token khớp chính xác. Phương pháp này nhanh và dễ đoán. Tuy nhiên, nó sẽ mất tác dụng ngay khi người dùng tìm kiếm bằng từ đồng nghĩa, cách diễn đạt tự nhiên hoặc các câu hỏi mô tả không trùng khớp từng chữ với tài liệu của bạn.
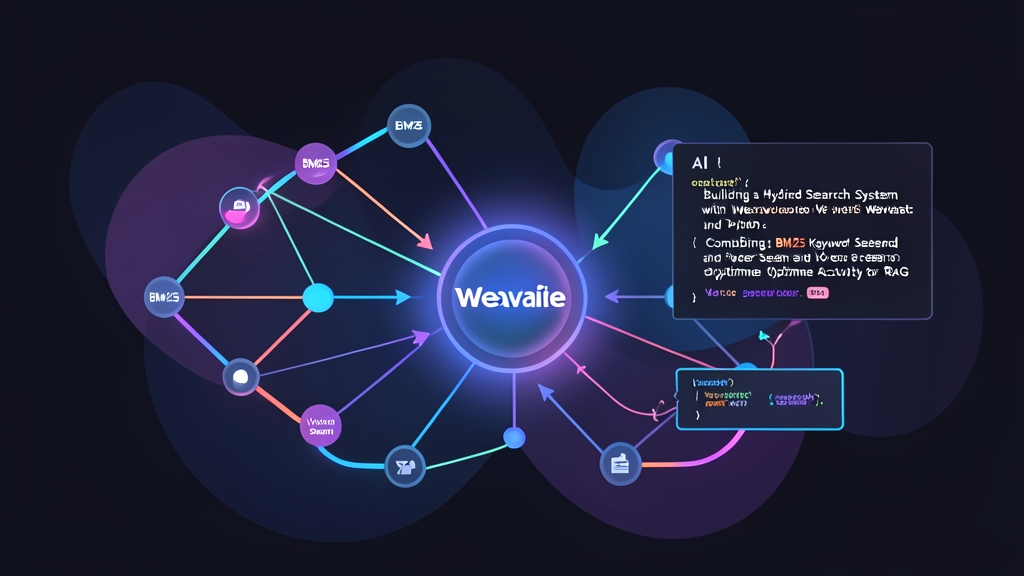
Hybrid search ra đời để thu hẹp khoảng cách này. Nó thực thi song song cả dense vector search và sparse BM25 retrieval, sau đó hợp nhất danh sách điểm số thành một bảng xếp hạng duy nhất. Trong các bài benchmark trên tài liệu kỹ thuật, hybrid retrieval thường xuyên cải thiện Recall@10 từ 15% đến 25% so với tìm kiếm thuần vector. Weaviate hỗ trợ cơ chế hợp nhất này theo cách native, mặc định sử dụng relative score fusion hoặc Reciprocal Rank Fusion (RRF).
Cách Weaviate xử lý công thức Hybrid
Weaviate kiểm soát sự cân bằng giữa từ khóa và embedding thông qua một tham số trọng số duy nhất: alpha.
alpha = 1.0: 100% vector search. Độ tương đồng ngữ nghĩa sẽ quyết định thứ hạng, bỏ qua hoàn toàn các từ khóa chính xác.alpha = 0.0: 100% BM25 keyword search. Bỏ qua hoàn toàn dense embedding.alpha = 0.5: Chia đều tỷ lệ 50/50 giữa điểm khớp từ khóa và điểm ngữ nghĩa vector.
Ưu và nhược điểm của từng chiến lược truy xuất
Việc lựa chọn phương pháp truy xuất phù hợp đòi hỏi phải cân bằng giữa latency (độ trễ), mức tiêu tốn tài nguyên và tính đặc thù của từng lĩnh vực.
Tìm kiếm thuần BM25
- Ưu điểm: Độ trễ truy vấn dưới 5ms, không tốn chi phí inference, khớp rất chuẩn xác các token hiếm, mã hex và mã định danh sản phẩm.
- Nhược điểm: Hoàn toàn không nhận biết ngữ nghĩa. Phương pháp này bỏ sót các từ đồng nghĩa trực tiếp (như "crash" và "exception") và thất bại khi gặp lỗi chính tả trừ khi bạn cấu hình fuzzy matching thủ công.
Tìm kiếm thuần Vector
- Ưu điểm: Xử lý tốt các truy vấn lộn xộn từ người dùng, truy vấn đa ngôn ngữ và các câu hỏi mang tính khái niệm mà không cần khớp từ khóa.
- Nhược điểm: Bắt buộc phải tạo embedding cho mỗi truy vấn (làm tăng thêm 30ms đến 120ms vào độ trễ p95), gặp khó khăn với các định danh kỹ thuật nằm ngoài từ vựng (out-of-vocabulary), đồng thời phát sinh chi phí tính toán API hoặc GPU.
Hybrid Search với Weaviate
- Ưu điểm: Mang lại độ phủ (recall) cao hơn trên nhiều dạng truy vấn hỗn hợp. Bạn có thể tự động điều chỉnh
alphatheo từng truy vấn dựa trên ý định của người dùng. - Nhược điểm: Dung lượng lưu trữ tăng khoảng 20% đến 35% vì Weaviate phải duy trì đồng thời cả HNSW vector index và inverted index cho từ khóa trên ổ đĩa.
Kiến trúc đề xuất
Khi triển khai production, hãy kết hợp Weaviate trong Docker Compose với Python client v4 chính thức (weaviate-client >= 4.9.0). Client v4 giao tiếp qua cả REST (cổng 8080) và gRPC (cổng 50051). Thiết kế kênh đôi này giúp tăng tốc đáng kể quá trình nạp dữ liệu hàng loạt (batch ingestion) và phân tích truy vấn so với client v3 cũ vốn chỉ dùng REST.
Yêu cầu tiên quyết
- Python 3.10 trở lên
- Docker và Docker Compose
- OpenAI API key có quyền truy cập vào
text-embedding-3-smallvàgpt-4o-mini
1. Khởi chạy Weaviate với Docker Compose
Tạo file docker-compose.yml trong thư mục làm việc của bạn:
services:
  weaviate:
    image: cr.weaviate.io/semitechnologies/weaviate:1.27.0
    restart: on-failure:0
    ports:
      - "8080:8080"
      - "50051:50051"
    environment:
      QUERY_DEFAULTS_LIMIT: 25
      AUTHENTICATION_ANONYMOUS_ACCESS_ENABLED: 'true'
      PERSISTENCE_DATA_PATH: '/var/lib/weaviate'
      ENABLE_MODULES: 'text2vec-openai'
      CLUSTER_HOSTNAME: 'node1'
Khởi động container ở chế độ chạy ngầm (detached mode):
docker compose up -d2. Cài đặt các thư viện Python phụ thuộc
Cài đặt client v4 và SDK của OpenAI:
pip install "weaviate-client>=4.9.0" "openai>=1.40.0"Các bước triển khai chi tiết
Dưới đây là cách kết nối, định nghĩa collection đã bật vector hóa, thêm các tài liệu kỹ thuật mẫu và thực thi các truy vấn hybrid.
Bước 1: Kết nối tới Weaviate và định nghĩa Collection
Tạo file hybrid_rag.py. Weaviate v4 giới thiệu mô hình collection với type hinting gốc và cấu hình schema rõ ràng.
import os
import weaviate
from weaviate.classes.config import Configure, Property, DataType

os.environ["OPENAI_APIKEY"] = "api-key-openai-cua-ban-o-day"

client = weaviate.connect_to_local(
    headers={
        "X-OpenAI-Api-Key": os.environ["OPENAI_APIKEY"]
    }
)

print(f"Đã kết nối: {client.is_ready()}")

if client.collections.exists("TechnicalDocs"):
    client.collections.delete("TechnicalDocs")

docs_collection = client.collections.create(
    name="TechnicalDocs",
    vectorizer_config=Configure.Vectorizer.text2vec_openai(
        model="text-embedding-3-small"
    ),
    properties=[
        Property(name="title", data_type=DataType.TEXT),
        Property(name="content", data_type=DataType.TEXT),
        Property(name="code_snippet", data_type=DataType.TEXT),
    ]
)

print("Đã tạo collection TechnicalDocs thành công.")
Bước 2: Nạp các tài liệu kỹ thuật mẫu
Nạp dữ liệu vào collection với ba đoạn trích tài liệu hỗ trợ thực tế. Hãy chú ý cách chúng kết hợp giữa phần mô tả chung với chuỗi mã lỗi chính xác và đoạn code mẫu:
documents = [
    {
        "title": "Hết hạn Token xác thực",
        "content": "Người dùng gặp lỗi ERR_AUTH_4019 khi token JWT vượt quá 3600 giây mà không bật tính năng tự động làm mới trong phiên gateway.",
        "code_snippet": "jwt.verify(token, secret, { maxAge: '1h' });"
    },
    {
        "title": "Cạn kiệt Connection Pool cơ sở dữ liệu",
        "content": "Dưới lưu lượng truy cập đồng thời cao, connection pool của PostgreSQL sẽ trả về lỗi ERR_CONN_5003 khi kích thước pool vẫn để mặc định là 10.",
        "code_snippet": "pool = new Pool({ max: 20, idleTimeoutMillis: 30000 });"
    },
    {
        "title": "Rò rỉ bộ nhớ trong cơ chế dọn Cache",
        "content": "Việc cache bằng map không giới hạn kích thước gây tiêu tốn bộ nhớ tăng dần cho đến khi container nhận tín hiệu OOM kill từ trình điều phối.",
        "code_snippet": "const cache = new LRUCache({ max: 500 });"
    }
]

with docs_collection.batch.dynamic() as batch:
    for doc in documents:
        batch.add_object(properties=doc)

print(f"Đã thêm {len(documents)} tài liệu.")
Bước 3: Truy vấn với các chế độ Vector, BM25 và Hybrid
Hãy xét một câu hỏi hỗ trợ điển hình: "Làm thế nào để xử lý timeout phiên ERR_AUTH_4019?" Truy vấn này kiểm tra hai yêu cầu cùng lúc. Nó đòi hỏi khả năng hiểu ngữ nghĩa của cụm "timeout phiên" bên cạnh việc khớp chính xác token ERR_AUTH_4019.
query = "Làm thế nào để xử lý timeout phiên ERR_AUTH_4019?"

# 1. Tìm kiếm thuần BM25 (alpha = 0)
response_bm25 = docs_collection.query.bm25(
    query=query,
    limit=1
)

# 2. Tìm kiếm thuần Vector
response_vector = docs_collection.query.near_text(
    query=query,
    limit=1
)

# 3. Tìm kiếm Hybrid (alpha = 0.5 cân bằng giữa từ khóa và ngữ nghĩa)
response_hybrid = docs_collection.query.hybrid(
    query=query,
    alpha=0.5,
    limit=1
)

print("--- Kết quả Hybrid Search ---")
for item in response_hybrid.objects:
    print(f"Tiêu đề: {item.properties['title']}")
    print(f"Đoạn trích: {item.properties['content']}")
Bước 4: Đưa các kết quả hàng đầu vào LLM
Đưa kết quả hybrid có điểm số cao nhất vào context window của LLM để tạo câu trả lời cuối cùng:
from openai import OpenAI

ai_client = OpenAI(api_key=os.environ["OPENAI_APIKEY"])

retrieved_context = "\n".join([
    f"{obj.properties['title']}: {obj.properties['content']}"
    for obj in response_hybrid.objects
])

system_prompt = f"""Bạn là một trợ lý hỗ trợ kỹ thuật. Hãy trả lời câu hỏi của người dùng chỉ dựa trên ngữ cảnh được cung cấp.

Ngữ cảnh:
{retrieved_context}
"""

completion = ai_client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "system", "content": system_prompt},
        {"role": "user", "content": query}
    ]
)

print("\n--- Câu trả lời cuối cùng từ LLM ---")
print(completion.choices[0].message.content)

client.close()
Tinh chỉnh tham số Alpha trong môi trường Production
Đừng bao giờ coi alpha là một thiết lập "cấu hình một lần rồi bỏ đó". Hãy bắt đầu với alpha=0.5 làm mốc chuẩn (baseline) trong quá trình phát triển. Nếu các truy vấn của bạn chủ yếu là tra cứu mã SKU, trace log hoặc các ký hiệu code chính xác, hãy giảm alpha xuống 0.3 hoặc 0.4. Điều này sẽ ưu tiên các kết quả khớp chính xác của BM25 và ngăn mô hình hallucinate (bịa đặt) các cách sửa lỗi cho những mã lỗi có câu chữ tương tự. Ngược lại, đối với thanh tìm kiếm dạng hội thoại nơi người dùng đặt câu hỏi bằng văn bản tự do, hãy tăng alpha lên 0.7 để ưu tiên các sắc thái ngữ nghĩa.