Bối cảnh & Lý do: Vượt qua giới hạn của CronJob và các CI Engine cồng kềnh
Hầu hết các đội ngũ kỹ thuật đều bắt đầu xử lý tác vụ theo lô (batch processing) theo cách đơn giản: dùng manifest CronJob chuẩn của Kubernetes hoặc các job Jenkins chuyên dụng. Cách thiết lập này vẫn hoạt động tốt khi cần chạy vacuum cơ sở dữ liệu lúc 2 giờ sáng hoặc kích hoạt các tiến trình đồng bộ đơn bước. Tuy nhiên, một khi pipeline của bạn phân nhánh thành các quy trình ETL nhiều giai đoạn, mọi thứ sẽ nhanh chóng trở nên rắc rối.
Kubernetes CronJob chạy từng pod riêng lẻ hoàn toàn cô lập. Chúng hoàn toàn không nhận biết được sự phụ thuộc giữa các tác vụ upstream hay downstream. Nếu tác vụ B cần tác vụ A chạy thành công trước, hoặc nếu tác vụ C phải chờ 20 worker pod chạy song song hoàn tất, CronJob sẽ khiến bạn rơi vào ngõ cụt.
Cuối cùng, bạn phải chắp vá các script Redis lock, vòng lặp polling và webhook callback mong manh. Đẩy các khối lượng công việc xử lý dữ liệu này sang Jenkins hoặc GitLab CI cũng chẳng khá hơn. Các Jenkins JVM runner thường ngốn từ 2 đến 4 GB RAM ngay cả khi chạy không tải (idle), và việc điều phối các Kubernetes agent động thường xuyên gây ra lỗi đồng bộ plugin cũng như làm bùng nổ node pool ngoài tầm kiểm soát.
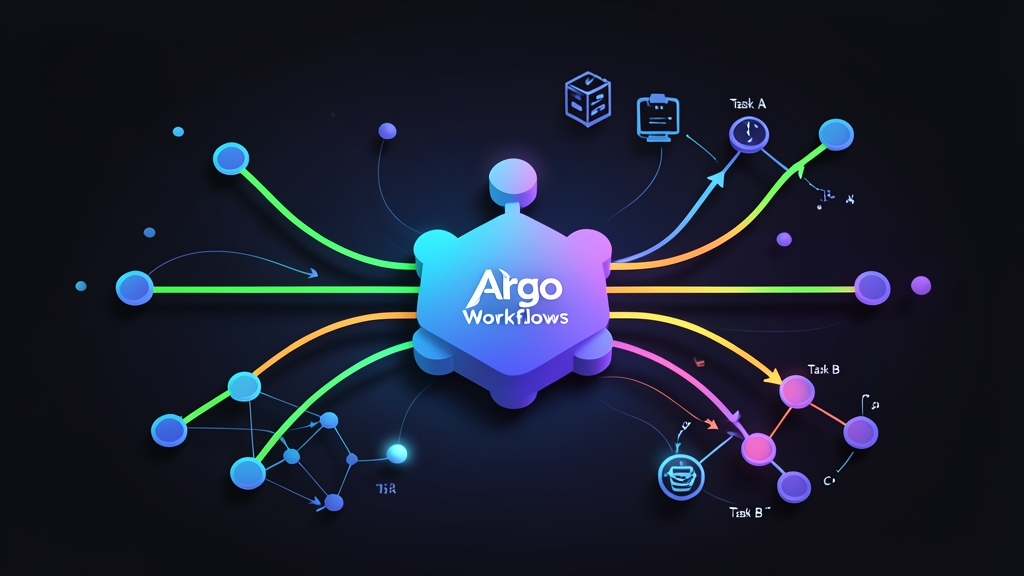
Argo Workflows thay thế các giải pháp chắp vá này bằng Custom Resource Definition (CRD) gốc của Kubernetes. Mỗi bước trong pipeline của bạn chạy dưới dạng một pod độc lập. Khi một bước hoàn thành, container của nó sẽ lập tức thoát ra, giải phóng CPU và bộ nhớ cho các workload khác.
Các workflow được khai báo dưới dạng Đồ thị có hướng không chu trình (DAG). Điều này cho phép các nhánh độc lập chạy đồng thời mà không cần đến cơ chế lock bên ngoài. Trong đợt chuyển đổi môi trường production của chúng tôi trên 40 batch job chạy hàng ngày, mô hình này đã giúp cắt giảm khoảng 35% chi phí tài nguyên tính toán của cụm và rút ngắn thời gian chạy ETL hàng đêm từ 3,5 giờ xuống chỉ còn 50 phút.
Cài đặt: Thiết lập Argo Workflows chuẩn chỉ
Bạn sẽ cần một cụm Kubernetes đang hoạt động (phiên bản v1.26 trở lên) và kubectl có quyền cluster-admin.
1. Tạo Namespace và triển khai các tài nguyên cốt lõi
Hãy cô lập workflow controller và các dịch vụ hỗ trợ của nó trong một namespace riêng. Triển khai controller, UI server và các CRD cần thiết bằng manifest chính thức:
# Tạo một namespace chuyên dụng
kubectl create namespace argo

# Triển khai Argo Workflows controller, UI server và các CRD
kubectl apply -n argo -f https://github.com/argoproj/argo-workflows/releases/download/v3.5.5/quick-start-minimal.yaml
2. Cấu hình quyền RBAC cho các Pipeline Pod
Các bước trong workflow chạy dưới dạng pod, và các pod đó cần quyền để báo cáo trạng thái của chúng về cho workflow controller. Service account mặc định không có các đặc quyền này. Hãy tạo một service account chuyên dụng và liên kết nó với các quyền hạn thích hợp trong namespace mục tiêu của bạn:
kubectl create serviceaccount argo-runner -n default

kubectl create rolebinding argo-runner-admin \
  --clusterrole=admin \
  --serviceaccount=default:argo-runner \
  --namespace=default
Sử dụng admin rất tiện lợi khi thử nghiệm. Trong các cụm production được thắt chặt bảo mật, hãy thay thế bằng một Role theo nguyên tắc đặc quyền tối thiểu (least privilege), chỉ cấp quyền truy cập vào các ConfigMap, Secret và Pod artifact cần thiết.
3. Cài đặt Argo CLI
Bạn có thể kiểm tra workflow bằng lệnh kubectl get wf, nhưng công cụ Argo CLI chuyên dụng sẽ giúp việc gỡ lỗi trở nên đơn giản hơn nhiều. Nó hỗ trợ stream log trực tiếp, kiểm tra artifact và hiển thị đồ thị trực quan bằng ký tự ASCII ngay trong shell của bạn:
# Tải bản binary Linux x86_64
curl -sLO https://github.com/argoproj/argo-workflows/releases/download/v3.5.5/argo-linux-amd64.gz

# Giải nén và cài đặt vào PATH
gunzip argo-linux-amd64.gz
chmod +x argo-linux-amd64
sudo mv argo-linux-amd64 /usr/local/bin/argo

# Kiểm tra cài đặt
argo version --short
Cấu hình: Thiết kế Pipeline DAG chạy song song
Pipeline chạy tuần tự gây lãng phí tài nguyên tính toán. Trong một DAG workflow, các bước không phụ thuộc lẫn nhau sẽ được kích hoạt ngay khi dữ liệu đầu vào của chúng sẵn sàng, giúp phân bổ các phép tính toán nặng trên toàn bộ các node sẵn sàng trong cụm.
Định nghĩa một DAG Workflow cho môi trường Production
Lưu manifest này với tên parallel-dag-pipeline.yaml. Nó sẽ lấy dữ liệu thô, phân nhánh (fan-out) thành hai worker phân tích chạy song song, rồi gom các kết quả đã tính toán vào một bước tổng hợp cuối cùng:
apiVersion: argoproj.io/v1alpha1
kind: Workflow
metadata:
  generateName: distributed-analytics-dag-
  namespace: default
spec:
  entrypoint: analytics-pipeline
  serviceAccountName: argo-runner
  templates:
  - name: analytics-pipeline
    dag:
      tasks:
      - name: fetch-raw-data
        template: data-fetcher

      # Bước song song A: Kích hoạt ngay khi dữ liệu thô sẵn sàng
      - name: compute-user-metrics
        dependencies: [fetch-raw-data]
        template: processor
        arguments:
          parameters:
          - name: job-type
            value: "user-metrics"

      # Bước song song B: Chạy đồng thời với Bước A
      - name: compute-billing-metrics
        dependencies: [fetch-raw-data]
        template: processor
        arguments:
          parameters:
          - name: job-type
            value: "billing-metrics"

      # Bước tổng hợp: Chờ cho đến khi cả hai worker hoàn thành
      - name: generate-summary-report
        dependencies: [compute-user-metrics, compute-billing-metrics]
        template: reporter

  # Template cho các tác vụ
  - name: data-fetcher
    container:
      image: alpine:3.19
      command: [sh, -c]
      args: ["echo 'Đang lấy bản dump cơ sở dữ liệu...' && sleep 5 && echo 'Hoàn tất chuẩn bị dữ liệu thô.'"]

  - name: processor
    inputs:
      parameters:
      - name: job-type
    container:
      image: python:3.11-alpine
      command: [python, -c]
      args:
      - |
        import sys, time
        job = "{{inputs.parameters.job-type}}"
        print(f"Đang xử lý phân vùng cho: {job}")
        time.sleep(8)
        print(f"Đã xử lý xong phân vùng phân tích: {job}")

  - name: reporter
    container:
      image: alpine:3.19
      command: [sh, -c]
      args: ["echo 'Đang tổng hợp kết quả từ các worker song song...' && echo 'Pipeline đã hoàn thành thành công.'"]
Khởi chạy và quản lý Pipeline
Kích hoạt workflow bằng Argo CLI kèm tùy chọn theo dõi log trực tiếp:
argo submit -n default --watch parallel-dag-pipeline.yaml
Hãy quan sát đồ thị thực thi trong terminal của bạn. Ngay khi fetch-raw-data hoàn thành, controller sẽ khởi chạy compute-user-metrics và compute-billing-metrics cùng một lúc. Nếu bạn sử dụng công cụ autoscaler cho cụm như Karpenter, các pod này sẽ kích hoạt tính năng tự động co giãn node theo nhu cầu và thu hồi node ngay khi khối lượng công việc kết thúc.
Kiểm tra & Giám sát: Vận hành Workflow một cách tin cậy
Các pipeline rồi cũng sẽ có lúc thất bại do dữ liệu upstream bị lỗi hoặc do timeout mạng. Khả năng quan sát (observability) tốt sẽ tạo nên sự khác biệt giữa một lần khắc phục trong 5 phút và một sự cố kéo dài 2 giờ.
1. Truy cập Web Dashboard
Argo tích hợp sẵn một giao diện web trực quan để kiểm tra sơ đồ tác vụ và log của pod. Chuyển tiếp cổng 2746 về máy trạm của bạn:
kubectl port-forward -n argo svc/argo-server 2746:2746
Mở https://localhost:2746 trong trình duyệt. Chấp nhận chứng chỉ tự ký nếu được yêu cầu. Dashboard sẽ kết xuất đồ thị thực thi theo thời gian thực, hiển thị mã thoát (exit code) của container và cung cấp tính năng chạy lại các bước bị lỗi chỉ với một cú nhấp chuột.
2. Kiểm tra trạng thái bằng dòng lệnh
Khi thao tác qua bastion host hoặc viết các script cảnh báo, bạn có thể kiểm tra trạng thái pipeline trực tiếp thông qua CLI:
# Liệt kê các lượt chạy pipeline mới nhất và trạng thái thực thi của chúng
argo list -n default

# Xem thông tin chi tiết về thời gian, trạng thái từng bước và ID của pod
argo get -n default @latest

# Stream log từ một container cụ thể trong DAG
argo logs -n default @latest -c processor
3. Danh sách kiểm tra (Checklist) cho môi trường Production
- Cấu hình dọn dẹp Pod (Garbage Collection): Thêm
podGC.strategy: OnWorkflowCompletionvào workflow spec. Việc giữ lại hàng nghìn pod đã hoàn tất sẽ làm phình dung lượng lưu trữ của etcd và làm chậm API server của bạn. - Thiết lập giới hạn tài nguyên rõ ràng: Luôn khai báo
requestsvàlimitscho bộ nhớ và CPU trên từng template. Nếu không có giới hạn, việc phân nhánh đột ngột 50 tác vụ có thể làm cạn kiệt tài nguyên của các pod hệ thống quan trọng như CoreDNS. - Áp dụng Retry Policy cho các bước dễ chập chờn: Gắn
retryStrategyvới thuật toán exponential backoff cho các bước phụ thuộc vào mạng. Một phản hồi lỗi 503 tạm thời từ API bên ngoài không nên làm gián đoạn cả một pipeline đang chạy 40 phút.