LLMアプリケーションのテスト手法:手動レビュー vs カスタムスクリプト vs 専用フレームワーク
6か月前、私たちが運用するカスタマーサポートボットが本番環境でサイレント障害を起こしました。ある開発者がtemperatureを0.7から0.2に下げ、より親しみやすいトーンにするため3単語ほど修正したことが原因でした。この何気ない変更によってレスポンスのJSONから末尾の閉じ括弧が欠落し、Zendeskの取り込み用Webhookが4時間にわたってクラッシュしてしまったのです。
本番環境の破損を再発させないため、私たちは一般的な3つのプロンプト評価戦略を比較検討しました。
- 手動によるスポットチェック:エンジニアがプルリクエストを作成する前に、OpenAI Playgroundへ5〜10件のサンプルクエリを貼り付けて確認する方法です。開発初日は問題なく機能しますが、エッジケースの見落としが発生しやすく、トークン数の肥大化も追跡できず、500件規模のデータセット全体におけるリグレッションを検知することは不可能です。
- カスタムPythonテストハーネス:OpenAIやAnthropicのSDKをラップし、社内用のpytestスイートを構築する方法です。テストフィクスチャを完全に制御できる利点があるものの、レート制限のリトライ処理、トークンコストの追跡、レポート生成ツールの保守に毎四半期数十時間もの工数が奪われることになります。
- 宣言型評価エンジン(Promptfoo):プロンプトをコンパイル対象コードのように扱うために設計された、軽量なCLI兼ライブラリです。テスト入力、モック変数、アサーションルールを単一のYAMLファイルに宣言します。Promptfooがプロバイダーへのルーティングを処理し、複数モデル間でアサーションを並行実行して、CIパイプライン内で標準の終了コードを返します。
メリットとデメリット:本番環境で6か月間Promptfooを運用した評価
エンドユーザー向けの14のワークフローでPromptfooを運用したことで、このツールが優れた威力を発揮する領域と、チームが直面する課題についての確かなデータが得られました。
Promptfooが優れている点
- 定型コード不要のマトリクステスト:GPT-4o-mini、Claude 3.5 Haiku、社内のOllamaエンドポイントを対象に、3種類のプロンプトバリエーションをテストしたい場合でも、40行のテストケースとともにYAMLへ定義するだけで済みます。Promptfooがグルーコードなしで120通りの順列マトリクスを並列実行します。
- 組み込みの決定論的アサーション:独自の検証ロジックをコーディングすることなく、JSONスキーマ、正規表現パターン、セマンティック類似度のしきい値、レスポンスレイテンシ(1,800ミリ秒未満)、1呼び出しごとの予算上限などを即座に検証できます。
- ローカルかつエアギャップでの実行:本番データを外部のクラウドデータベースに取り込むSaaS型評価プラットフォームとは異なり、PromptfooはローカルターミナルやプライベートCIランナー内で動作します。顧客の機密データが評価ベンダーのサーバーに送信されることは一切ありません。
- CIで活用しやすい出力形式:テスト失敗時にはステータスコード100で終了し、トークンコストを1セント未満の単位まで追跡できるほか、単一ファイルのHTMLダッシュボードやプルリクエスト用のMarkdownサマリーを出力できます。
現場で直面する注意点
- LLM-as-a-Judgeの累積コスト:トーンや自由形式の推論を評価するために
llm-rubricを使用すると、各テストケースごとに追加のAPI呼び出しが発生します。1日10件のプルリクエストで100件のテストスイートを実行した場合、これらのジャッジ呼び出しだけでOpenAIの利用料が週あたり45ドル増加しました。 - マルチターンの対話テストにおけるオーバーヘッド:シングルターンの抽出処理は簡単にテストできます。一方で、複数ターンの対話フローを正確に検証するには、セッション履歴をモックするための手動ステート管理やカスタムPython拡張フックが必要になります。
本番CI/CDテスト戦略
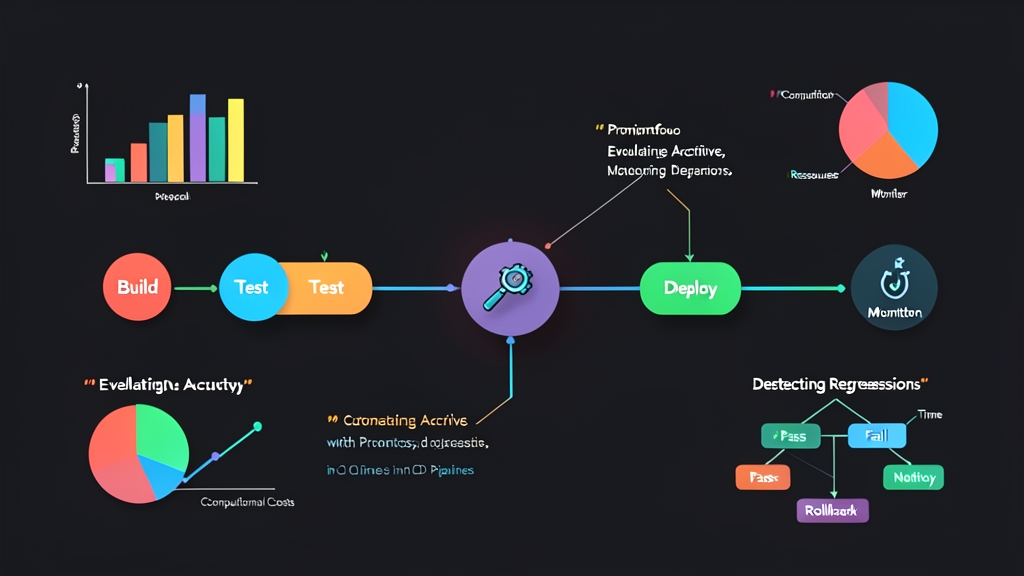
すべてのgit pushに対して200件の網羅的なテストマトリクスを実行すると、APIクレジットを浪費し開発速度を低下させてしまいます。そこで、私たちはプロンプト検証を3段階のゲートに分割しました。
- ローカルのPre-commit(30秒):
gpt-4o-miniまたはローカルのモックレスポンスに対して実行する、5件のサニティチェックからなる軽量なスモークテストです。コードが開発者のPCから離れる前に、構文エラーや不正なJSONスキーマを検知します。 - プルリクエスト時のゲートテスト(2〜3分):JSONスキーマ、正規表現の境界値、トークン制限、レイテンシのしきい値を検証する40〜60件の決定論的アサーションスイートです。mainブランチを対象とするすべてのプルリクエストで実行されます。
- 夜間リグレッションスイート(15分):匿名化された300件以上の本番サンプルを使用した大規模な評価です。この段階では、モデルによるルーブリック評価、有害性スキャン、モデルアップグレード前後のコスト比較を実行します。
過去6か月間で400件以上のプルリクエストをマージしてきましたが、この階層化パイプラインにより、ステージング環境にデプロイされる前に18件のスキーマ破壊変更を未然に防ぐことができました。
実装ガイド:GitHub ActionsでPromptfooをセットアップする
以下の手順に沿って、自動プロンプトテストをゼロから構成し、厳格なレイテンシ・予算上限を設定して、プルリクエストごとに自動チェックを実行できるようにしましょう。
1. インストールとプロジェクトの初期化
リポジトリの開発用依存関係としてPromptfooをインストールします。
# プロジェクトにPromptfooをインストール
npm install --save-dev promptfoo

# スターター構成ディレクトリを初期化
npx promptfoo init
2. プロンプトの作成とアサーションの定義
本番用プロンプトテンプレートをprompts/support_agent.txtに保存します。
あなたは社内クラウドプラットフォームのITサポートアシスタントです。
ユーザーからの問い合わせ内容を、"category"、"severity"、"action_required"のキーを持つ構造化されたJSONレスポンスに変換してください。
JSONの外部には会話テキストやMarkdownフォーマットを含めないでください。

ユーザーの問い合わせ: {{issue}}次に、promptfooconfig.yamlでモデルプロバイダー、ベースラインのしきい値、テストケースを定義します。
description: "サポートチケット向けプロンプト評価"

prompts:
  - file://prompts/support_agent.txt

providers:
  - id: openai:gpt-4o-mini
    config:
      temperature: 0.1
  - id: anthropic:messages:claude-3-5-haiku-20241022
    config:
      temperature: 0.1

defaultTest:
  assert:
    # レスポンスレイテンシを1,800ミリ秒未満に制限
    - type: latency
      threshold: 1800
    # 1リクエストあたりのコストを0.0015ドル未満に制限
    - type: cost
      threshold: 0.0015

tests:
  - description: "データベース接続エラーを高(high)または重大(critical)の深刻度に分類する"
    vars:
      issue: "本番環境のPostgresクラスタレプリカが、コネクションプールのタイムアウトによりヘルスチェックに失敗しています。"
    assert:
      - type: is-json
      - type: javascript
        value: "['critical', 'high'].includes(JSON.parse(output).severity)"
      - type: javascript
        value: "JSON.parse(output).category === 'database'"

  - description: "パスワードリセットを低(low)の深刻度に分類する"
    vars:
      issue: "ステージング環境のGrafanaダッシュボードのパスワードをリセットしてもらえますか?"
    assert:
      - type: is-json
      - type: javascript
        value: "JSON.parse(output).severity === 'low'"
      - type: not-icontains
        value: "sudo"
3. ローカルでの評価実行と結果確認
API認証情報を環境変数にエクスポートし、ターミナルから直接評価スイートを実行します。
export OPENAI_API_KEY="sk-..."
export ANTHROPIC_API_KEY="sk-ant-..."

# 設定されたプロバイダーに対してアサーションを実行
npx promptfoo eval

# ローカルのビジュアル比較UIを起動
npx promptfoo viewターミナル上には、モデルごとのトークン消費量、合否ステータス、レイテンシを示すASCIIサマリーが即座に出力されます。npx promptfoo viewを実行するとローカルWebサーバー(デフォルトはポート15500)が立ち上がり、失敗したアサーションの詳細確認や、生の生成テキストを並べて比較・分析できます。
4. GitHub Actions CIパイプラインへの統合
プロンプトテンプレートやテストファイルが変更されたプルリクエストごとにテストをトリガーするため、.github/workflows/prompt-tests.ymlを作成します。
name: LLMプロンプト評価

on:
  pull_request:
    paths:
      - 'prompts/**'
      - 'promptfooconfig.yaml'

jobs:
  evaluate-prompts:
    runs-on: ubuntu-latest
    steps:
      - name: リポジトリのチェックアウト
        uses: actions/checkout@v4

      - name: Node.jsのセットアップ
        uses: actions/setup-node@v4
        with:
          node-version: 20
          cache: 'npm'

      - name: 依存関係のインストール
        run: npm ci

      - name: Promptfooによる評価を実行
        env:
          OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
run: npx promptfoo eval --no-cacheもし開発者がプロンプトを変更し、JSONスキーマを破壊したり、1,000トークンもの高コストなハルシネーションを発生させたりした場合、Promptfooは非ゼロコードで終了します。GitHub Actionsは即座にチェック失敗とマークし、プルリクエストのマージをブロックします。