現場の課題:Kubernetesにおけるテレメトリの肥大化とベンダーロックイン
本番運用のKubernetesクラスターの多くは、最初はシンプルに始まります。3つほどのマイクロサービスをデプロイし、Prometheusでメトリクスをスクレイピングし、Fluent Bitでコンテナログを収集し、トレーシング用にSaaS APMエージェントを組み込みます。最初はこれでもうまく機能しますが、プラットフォームが拡張するにつれて問題が生じます。
1年も経てば、それらの3つのサービスは20台のワーカーノード、8つのネームスペースにまたがる40もの個別デプロイメントへと膨れ上がります。するとエージェントの肥大化が急速に進行します。各ワーカーノードでは3〜4個のサイドカーやデーモンエージェントが稼働し、テレメトリの転送だけでノードのRAMを合計1.5〜2.5GBも消費するようになってしまいます。
さらにセキュリティ要件により、送信前にログからクレジットカード番号をマスキングする必要が生じた場合、ログ収集デーモンごとに異なる独自の正規表現方言が要求されることに気づかされます。さらに厄介なことに、月額15,000ドルの監視コストを削減するために代替プラットフォームを検証しようとすると、数十ものアプリケーションリポジトリでSDKの改修が必要になります。
このような無秩序な肥大化は、ノードリソースの浪費、冗長なテレメトリストリームによる数万円規模のアベイラビリティゾーン(AZ)間エグレス料金、そして完全なベンダーロックインという、高コストをもたらす3大ボトルネックを引き起こします。
根本原因の分析:バックエンドとの直接的な密結合
なぜ多くのエンジニアリングチームがこの壁に突き当たるのでしょうか。その根本原因は、テレメトリを生成するワークロードと、それを消費するプラットフォームとの間の密結合にあります。
マイクロサービスが外部エンドポイントへ直接データを送信していると、インフラ関連の処理がアプリケーションロジックを汚染してしまいます。本来、アプリケーションはビジネスイベントを記録し、テレメトリシグナルを発行するだけに専念すべきです。gzip圧縮、バックオフリトライ、バッチバッファ、あるいはKubernetesメタデータの付与といった処理まで担うべきではありません。
クラスター内にルーティング層が存在しない場合、チームは主に以下の3つの技術的課題に直面します。
- 互換性のないデータ形式: メトリクス、トレース、ログの間で命名規則が異なり(例:
service_nameとservice.name)、インシデント発生時の相関分析が困難になります。 - エッジでのデータクレンジングの欠如: ノイズとなる
/healthzスパンの除外やPII(個人情報)のマスキングを行うには、各サービス内のコード修正か、監視プロバイダー側での高価なインジェスト時処理ルールが必要になります。 - コネクションの乱立とオーバーヘッド: 数百ものアプリケーションPodが個別に外部向けTLS接続を確立するため、NATゲートウェイの接続上限を圧迫し、ゾーン間エグレス料金を急増させます。
アーキテクチャ比較:3つのインジェスト戦略
マニフェストを作成する前に、Kubernetesテレメトリを管理するための一般的な3つのアーキテクチャを比較検討しましょう。
1. アプリケーション内直接エクスポーター(Direct In-App Exporters)
各アプリケーションPodがベンダー固有のSDKを組み込み、Datadog、New Relic、Dynatraceなどの外部SaaSエンドポイントへ直接データを送信します。
- メリット: 初期のPoC(概念実証)段階のサービスにおいて迅速にセットアップできる。
- デメリット: 深刻なベンダーロックイン、中央でのガバナンスが皆無、Podのランタイムごとに50〜100MBの余計なメモリを消費する。
2. 個別特化型エージェントの併用(Prometheus + Fluent Bit + Jaeger Agent)
各テレメトリの種類ごとに、特化した個別のオープンソースデーモンを各ノードで稼働させます。
- メリット: 実績豊富で安定しており、ドキュメントが充実している。
- デメリット: 3種類の個別設定フォーマット、3系統のデーモンアップグレードサイクル、トレースとログの統一されたコンテキスト相関が取れない。
3. OpenTelemetry Collector(統合ゲートウェイ&パイプライン)
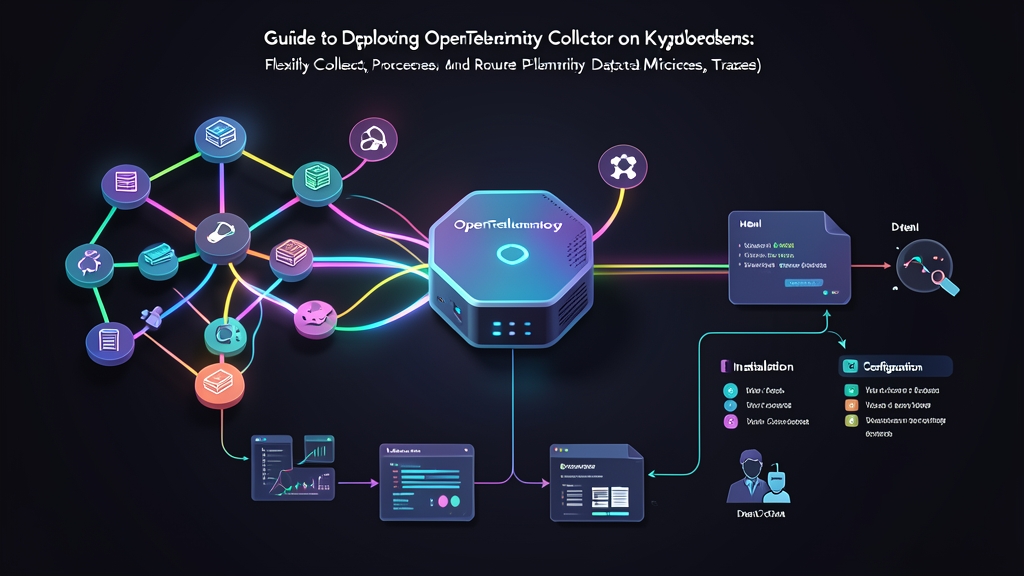
ベンダー中立の単一プロキシが標準規格(OTLP、Prometheus、Zipkinなど)経由でテレメトリを受け取り、メモリ内で処理した上で、任意のストレージエンジンへファンアウト(分散送信)します。
- メリット: 統一された1つのYAMLパイプライン、Kubernetes Pod属性の自動注入、集中サンプリング、コード変更不要での即座のバックエンド切り替え。
- デメリット: Collectorのパイプライン構文の習得と、memory_limiterの閾値の適切なチューニングが必要。
推奨パターン:Agent-Gatewayの2層トポロジー
本番のKubernetes環境では、パフォーマンスと制御性のバランスが最も優れた2層ハイブリッドアーキテクチャが推奨されます。
各ノードで軽量なDaemonSetを実行し、ローカルのcgroupメトリクスをスクレイピングするとともに、/var/log/pods からコンテナログファイルを収集します。このノードエージェントはローカルgRPC経由ですべてのデータを、中央ゲートウェイとして動作する自動スケーリング構成のDeploymentへ転送します。Gateway側では、Kubernetes APIサーバーへのPodメタデータの問い合わせ、テールベースサンプリングの適用、PIIのフィルタリング、外部バックエンドへのルーティングなど、負荷の高い処理を一括して担います。
ステップ1: OpenTelemetryのHelmリポジトリを追加する
公式のOpenTelemetry Helmチャートを使用することで、環境全体で再現可能かつ宣言的なデプロイを維持できます。
helm repo add open-telemetry https://open-telemetry.github.io/opentelemetry-helm-charts
helm repo update
ステップ2: Collectorパイプラインを設定する
カスタマイズした otel-collector-values.yaml ファイルを作成します。Collectorのパイプラインは、データ処理を4つのコンポーネントで構成します。receivers(データの受信方法)、processors(インメモリでの変換やバッチ処理)、exporters(送信先バックエンド)、および service pipelines(コンポーネント同士の結合)です。
mode: "deployment"
replicaCount: 2

resources:
  limits:
    cpu: 1000m
    memory: 1Gi
  requests:
    cpu: 250m
    memory: 512Mi

config:
  receivers:
    otlp:
      protocols:
        grpc:
          endpoint: 0.0.0.0:4317
        http:
          endpoint: 0.0.0.0:4318

  processors:
    memory_limiter:
      check_interval: 1s
      limit_percentage: 75
      spike_limit_percentage: 20

    batch:
      send_batch_size: 8192
      timeout: 1s

    k8sattributes:
      auth_type: "serviceAccount"
      passthrough: false
      extract:
        metadata:
          - k8s.pod.name
          - k8s.pod.uid
          - k8s.namespace.name
          - k8s.node.name
          - k8s.deployment.name
      pod_association:
        - sources:
            - type: ip

  exporters:
    debug:
      verbosity: basic
    otlp/jaeger:
      endpoint: "jaeger-collector.observability.svc.cluster.local:4317"
      tls:
        insecure: true
    prometheus:
      endpoint: "0.0.0.0:8889"
      namespace: "otel"

  service:
    pipelines:
      traces:
        receivers: [otlp]
        processors: [memory_limiter, k8sattributes, batch]
        exporters: [otlp/jaeger, debug]
      metrics:
        receivers: [otlp]
        processors: [memory_limiter, k8sattributes, batch]
        exporters: [prometheus]
      logs:
        receivers: [otlp]
        processors: [memory_limiter, k8sattributes, batch]
        exporters: [debug]
各パイプラインの先頭に memory_limiter が配置されている点に注目してください。これを先頭に置くことで、過剰なメモリを消費してKubernetesのOOMKillイベントが発生する前に、Collectorが適切に負荷を逃がす(ロードシェディングする)ことが保証されます。
ステップ3: GatewayをKubernetesにデプロイする
observability ネームスペースを作成し、作成した設定を使ってHelmチャートをインストールします。
kubectl create namespace observability

helm upgrade --install otel-collector open-telemetry/opentelemetry-collector \
  --namespace observability \
  -f otel-collector-values.yaml
GatewayのPodが正常に稼働し、内部Serviceにアクセス可能であることを確認します。
kubectl get pods -n observability -l app.kubernetes.io/name=opentelemetry-collector
kubectl get svc -n observability otel-collector
ステップ4: 標準OTLP環境変数でワークロードを設定する
Collectorはベンダー非依存のOTLPペイロードを受け付けるため、ワークロードの計装にベンダー固有のコードは一切不要です。Podの仕様(spec)に標準のOpenTelemetry環境変数を直接注入します。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: order-service
  namespace: default
spec:
  replicas: 2
  selector:
    matchLabels:
      app: order-service
  template:
    metadata:
      labels:
        app: order-service
    spec:
      containers:
        - name: app
          image: mycompany/order-service:1.2.0
          env:
            - name: OTEL_EXPORTER_OTLP_ENDPOINT
              value: "http://otel-collector.observability.svc.cluster.local:4317"
            - name: OTEL_EXPORTER_OTLP_PROTOCOL
              value: "grpc"
            - name: OTEL_SERVICE_NAME
              value: "order-service"
            - name: OTEL_RESOURCE_ATTRIBUTES
              value: "deployment.environment=production,service.version=1.2.0"
ステップ5: データ収集とメタデータ付与の検証
Collector Podのログをストリーミングして、トレース、メトリクス、ログがプロセッサパイプラインを正常に通過していることを確認します。
kubectl logs -n observability -l app.kubernetes.io/name=opentelemetry-collector -f --tail=50受信したスパンに k8s.pod.name、k8s.namespace.name、service.version が付与されていることが確認できるはずです。将来的にビジネス要件が変化した場合でも、送信先の変更(JaegerからGrafana Tempoへ、あるいはPrometheusからDatadogへなど)はエクスポーターの設定を更新するだけで完了します。アプリケーションのデプロイメントに手を加える必要は一切ありません。