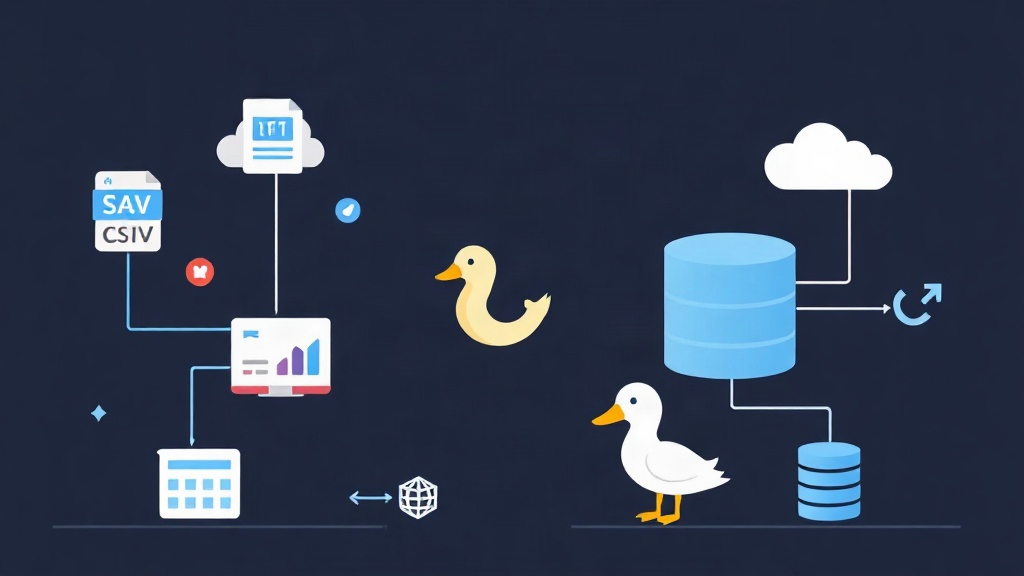
Cách đây vài tuần, tôi phải tổng hợp một tệp xuất raw event log dung lượng 15GB được chia nhỏ thành hàng chục file CSV và Parquet. Cách làm thông thường là khởi tạo một warehouse trên Snowflake hoặc nạp toàn bộ vào một instance PostgreSQL cục bộ. Cả hai hướng tiếp cận đều rất phiền toái. Việc nạp 15GB vào Postgres mất hơn 18 phút, trong khi Snowflake lại kéo theo độ trễ mạng, chi phí egress và gánh nặng quản lý cluster chỉ để trả lời năm câu hỏi phân tích nhanh.
Tại sao quy trình này lại cồng kềnh với các công cụ truyền thống? Các cơ sở dữ liệu giao dịch đọc dữ liệu theo từng dòng (OLTP). Điều này gây lãng phí CPU cache line khi bạn chỉ cần tính trung bình cộng hai cột trong số năm mươi cột. Ở chiều ngược lại, các cloud data warehouse đòi hỏi thiết lập phức tạp, chi phí duy trì liên tục và truyền tải dữ liệu liên tục qua mạng. DuckDB loại bỏ hoàn toàn những rào cản này. Nó chạy nhúng trực tiếp bên trong process ứng dụng của bạn như một engine OLAP dạng cột (columnar) với cơ chế vector hóa (vectorized execution).
1. So sánh phương pháp: Các công cụ truyền thống vs. In-Process OLAP
Mỗi công cụ được thiết kế để giải quyết những bài toán khác nhau. PostgreSQL xử lý các transaction đồng thời một cách đáng tin cậy, còn MongoDB giúp việc lưu trữ nested document trở nên dễ dàng. Nhưng khi bạn cần xử lý 80 triệu dòng từ các flat file trên một chiếc laptop cá nhân, các engine này sẽ chạm ngưỡng giới hạn.
Dưới đây là so sánh giữa các lựa chọn xử lý dữ liệu phổ biến:
- Pandas / Polars: Tiện lợi cho các script, nhưng Pandas rất dễ gặp lỗi Out-Of-Memory (OOM) với các tập dữ liệu lớn hơn dung lượng RAM. Polars xử lý streaming tốt hơn nhiều, nhưng việc viết các phép SQL join nhiều bảng phức tạp hoặc window function trên nhiều file phân tán vẫn khá bất tiện.
- PostgreSQL / MySQL: Các SQL engine đáng tin cậy, nhưng bạn phải định nghĩa schema, tạo bảng và đợi các lệnh
COPYhàng loạt hoàn tất trước khi có thể chạy truy vấn đầu tiên. - Cloud Data Warehouses (Snowflake, BigQuery): Được xây dựng cho các đội ngũ xử lý quy mô petabyte, nhưng lại quá mức cần thiết đối với việc khám phá dữ liệu ad-hoc. Bạn phải trả phí cho thời gian compute nhàn rỗi, cấu hình quyền IAM phức tạp và upload hàng gigabyte dữ liệu qua mạng.
- DuckDB: Truy vấn trực tiếp các flat file với cơ chế zero-copy read, xử lý các tập dữ liệu lớn hơn RAM khả dụng thông qua cơ chế out-of-core streaming và hoàn toàn không cần thiết lập daemon/server.
2. Ưu và nhược điểm khi sử dụng DuckDB
DuckDB rất nhanh, nhưng nó không phải là giải pháp vạn năng cho mọi bài toán cơ sở dữ liệu. Dưới đây là những điểm mạnh vượt trội và những mặt còn hạn chế của nó.
Ưu điểm
- Không cần hạ tầng: Chạy như một thư viện in-process cho C++, Python hoặc Node.js. Không có server nào cần phải vá lỗi, bảo mật hay giám sát.
- Hỗ trợ định dạng file gốc: Đọc và ghi trực tiếp các file CSV, Parquet, JSON, Arrow và các remote bucket S3/GCS ngay trong câu lệnh truy vấn SQL.
- Columnar Vectorized Execution: Xử lý dữ liệu theo từng khối 2.048 giá trị bằng các chỉ lệnh SIMD. Điều này tối đa hóa thông lượng CPU và duy trì mức sử dụng bộ nhớ ở mức thấp.
- Truy vấn đa nguồn: Join trực tiếp một bảng SQLite hoặc PostgreSQL đang hoạt động với các file Parquet cục bộ chỉ trong một câu truy vấn SQL duy nhất.
Nhược điểm
- Giới hạn Single-Writer: DuckDB tuân theo mô hình concurrency của SQLite. Nhiều process không thể cùng ghi vào một file database tại cùng một thời điểm.
- Không thiết kế cho OLTP tần suất cao: Các tác vụ point lookup, chèn từng dòng liên tục và cập nhật giao dịch với mức độ đồng thời cao vẫn nên được xử lý bởi PostgreSQL hoặc MySQL.
3. Thiết lập và kiến trúc khuyến nghị
Cách thiết lập phụ thuộc vào tác vụ của bạn. Hãy sử dụng file nhị phân CLI độc lập để khám phá tương tác và kiểm tra nhanh các file dữ liệu. Đối với các pipeline ETL tự động và backend service, hãy cài đặt thư viện Python.
Cài đặt
# Cài đặt DuckDB CLI độc lập trên Linux/macOS
curl https://install.duckdb.org | sh

# Hoặc cài đặt qua Python
pip install duckdb pandas pyarrow
Sau khi được cài đặt trong Python, DuckDB có thể truy vấn trực tiếp các Pandas DataFrame và bảng Apache Arrow trong bộ nhớ mà không cần tuần tự hóa (serialization) hay sao chép trùng lặp dữ liệu.
4. Hướng dẫn triển khai: Truy vấn file và dữ liệu đa nguồn
Hãy cùng xem xét các ví dụ thực tế: truy vấn các raw file, tự động hóa pipeline tổng hợp dữ liệu và liên kết các nguồn dữ liệu giữa các cơ sở dữ liệu khác nhau.
Truy vấn trực tiếp file CSV và Parquet bằng SQL
Hãy tạm quên đi các bước migration schema. DuckDB sẽ tự động kiểm tra các dòng mẫu để suy luận tên cột và kiểu dữ liệu tương ứng.
-- Khởi chạy CLI ở chế độ bộ nhớ in-process:
-- duckdb

-- Truy vấn SQL trực tiếp trên nhiều file CSV bằng glob pattern
SELECT
    category,
    COUNT(*) AS total_orders,
    ROUND(AVG(price), 2) AS avg_price,
    ROUND(SUM(price * quantity), 2) AS total_revenue
FROM 'sales_data_*.csv'
WHERE order_status = 'COMPLETED'
GROUP BY category
ORDER BY total_revenue DESC
LIMIT 5;
Với các file Parquet, hiệu năng thậm chí còn ấn tượng hơn. DuckDB đọc metadata của row-group và thống kê cột để bỏ qua hoàn toàn các khối dữ liệu không cần thiết (predicate pushdown), chỉ lấy đúng các cột được yêu cầu từ ổ đĩa:
-- Lọc dữ liệu Parquet mà không cần quét toàn bộ tập dữ liệu
SELECT
    customer_id,
    SUM(amount) AS total_spent
FROM 'transactions.parquet'
WHERE transaction_date >= '2026-01-01'
GROUP BY customer_id
HAVING total_spent > 5000;
Tự động hóa pipeline trong Python
Trong Python, DuckDB đóng vai trò như một bước chuyển đổi (transformation) siêu nhanh và ghi trực tiếp kết quả ngược trở lại ổ đĩa:
import duckdb

# Kết nối tới một session trong bộ nhớ
con = duckdb.connect()

# Tổng hợp hàng triệu dòng log và xuất trực tiếp ra file Parquet đã nén
query = """
    COPY (
        SELECT
            date_trunc('month', timestamp) AS month,
            country,
            count(DISTINCT user_id) AS active_users,
            sum(bytes_sent) / (1024 * 1024) AS total_mb
        FROM 'logs/*.parquet'
        WHERE status_code = 200
        GROUP BY 1, 2
    ) TO 'aggregated_metrics.parquet' (FORMAT PARQUET, COMPRESSION ZSTD);
"""

con.execute(query)
print("Hoàn tất tổng hợp: kết quả đã được ghi vào aggregated_metrics.parquet")
Kết nối dữ liệu đa nguồn mà không cần ETL
Thay vì phải xây dựng một pipeline ETL để kết hợp dữ liệu giữa các hệ thống, bạn có thể attach các cơ sở dữ liệu bên ngoài một cách linh hoạt:
-- Cài đặt và nạp extension SQLite
INSTALL sqlite;
LOAD sqlite;

-- Gắn (attach) cơ sở dữ liệu ứng dụng
ATTACH 'app_users.db' AS sqlite_db (TYPE SQLITE);

-- Join bảng users từ CSDL giao dịch với các file sự kiện phân tích
SELECT
    u.username,
    u.email,
    count(e.event_id) AS total_events
FROM sqlite_db.users u
JOIN 'events_2026.parquet' e ON u.id = e.user_id
GROUP BY u.username, u.email
ORDER BY total_events DESC
LIMIT 10;
DuckDB là cầu nối hoàn hảo giữa các raw file và các hệ cơ sở dữ liệu phức tạp. Bạn có được hiệu năng chuẩn data warehouse ngay trên máy cục bộ, không tốn chi phí cloud cho các tác vụ phân tích local và không có server nào cần phải duy trì bảo trì.