ベアメタルの壁
AWS EKSのようなマネージドサービスからベアメタル環境への移行は、通常、非常に快適に感じられます。――サービスを外部に公開しようとする瞬間までは。type: LoadBalancer でServiceを作成し、kubectl get svc を実行して待ちます。5分、10分と経過しても、EXTERNAL-IP 列は <pending> のまま一向に変わりません。
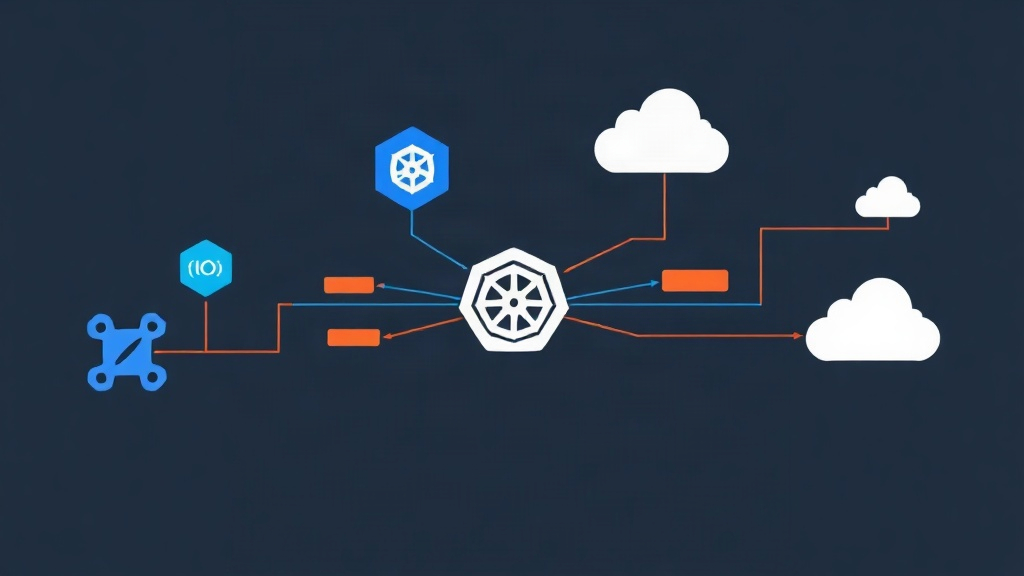
次にControl Planeの悩みがあります。本番環境において、単一のマスターノードは「時限爆弾」を抱えているようなものです。しかし、3つのマスターノードをデプロイする場合、ワーカーノードや kubectl クライアントには、単一で安定したエントリポイントが必要です。クラウドであればNLBをプロビジョニングするだけですが、オンプレミスでは、高価なハードウェアロードバランサーを購入せずにこのギャップをどう埋めるかという課題に直面します。
私は、高トラフィックな環境向けのプライベートクラウドを構築する中で、まさにこの問題と格闘してきました。ここで紹介する手法は、3ノードのホームラボから20ノードの本番用ラックまで、さまざまなクラスターで安定性が証明されています。これにより、物理ハードウェアを一流のクラウドプロバイダーと同じような柔軟性で扱うことが可能になります。
なぜIPが「Pending」のままなのか
Kubernetesはモジュール設計を採用しています。実は、Kubernetes自体はロードバランサーを「作成」する方法をネイティブには知りません。代わりに、Cloud Controller Manager(CCM)がAWSやOpenStackなどの外部APIと通信してネットワークリソースをプロビジョニングし、そのIPを報告することを期待しています。
物理サーバー上でバニラな(標準の)クラスターを実行する場合、そのCCMが存在しません。クラスターには、ローカルネットワークに対して「192.168.1.50へのトラフィックをこれらの特定のノードにルーティングしてください」と伝える手段がないのです。レイヤー2(ARP)またはレイヤー3(BGP)のアドバタイズ(広報)を行う仕組みがなければ、サービスが外部IPを受け取ることはありません。また、Control Planeにも統合された高可用なアドレスが欠如することになります。
選択肢の比較
Kube-vipに決める前に、いくつかのソリューションをテストしました。それぞれの特徴は以下の通りです。
- Keepalived + HAProxy: 伝統的なLinuxのアプローチです。信頼性は高いですが、Kubernetesの外部で設定ファイルを管理する必要があります。これは「Infrastructure as Code」の流れを分断し、ノードのスケーリング時に手動のオーバーヘッドを発生させます。
- MetalLB: ServiceにIPを提供するための強力なツールです。しかし、MetalLBはクラスターが存在する前にControl Plane用の仮想IP(VIP)を提供することを目的としていません。そのため、マスターノードのブートストラップのためだけに別のツールが必要になることがよくあります。
- Kube-vip: これがオールインワンの決定版です。Static Podを介してControl PlaneにVIPを提供し、DaemonSetを介してService의 LoadBalancerを管理します。軽量で高速、かつ完全にKubernetesエコシステム内で完結します。
解決策:すべてにKube-vipを使用する
Kube-vipはネットワークのマルチツールとして機能します。APIサーバーの高可用性とService LoadBalancerのロジックを単一のバイナリで処理します。それでは、新しいクラスターでセットアップしてみましょう。
1. Control Plane VIPのブートストラップ
高可用(HA)クラスターにおいて最も難しいのは、最初の起動です。kubeadm init を実行する前にVIPが存在している必要があります。Kube-vipは、Static Podとして動作することでこれを解決します。Kubeletは、クラスターの残りの部分がオンラインになる前に、自動的にKube-vipを起動します。
サブネット内の未使用のIPを選択します。この例では 192.168.1.50 を使用します。まず、環境変数を設定します。
export VIP=192.168.1.50
export INTERFACE=eth0
KVVERSION=$(curl -sL https://api.github.com/repos/kube-vip/kube-vip/releases/latest | jq -r " .tag_name")
次に、Static Podのマニフェストを生成します。Kube-vipのイメージ自体を使用して設定を構築します。
docker run --network host --rm ghcr.io/kube-vip/kube-vip:$KVVERSION \
    manifest pod \
    --interface $INTERFACE \
    --address $VIP \
    --controlplane \
    --services \
    --arp \
    --leaderElection | tee /etc/kubernetes/manifests/kube-vip.yaml
kubeadm init --control-plane-endpoint "192.168.1.50:6443" を実行すると、Kubeletは /etc/kubernetes/manifests/ 内のファイルを検出します。コンテナを起動し、即座にARPを介してVIPのアドバタイズを開始します。これで、クラスターに対する耐障害性の高いエントリポイントが確保されました。
2. Service LoadBalancerの有効化
クラスターが稼働したら、アプリケーションの <pending> ステータスを解消する必要があります。Static Podがマスターを処理する一方で、DaemonSet がサービスを処理します。これにより、Kube-vipがすべてのノードで実行され、新しい LoadBalancer リクエストを監視するようになります。
まず、RBACの設定をインストールします。これにより、Kube-vipにサービスを監視するために必要な権限が付与されます。
kubectl apply -f https://kube-vip.io/manifests/rbac.yaml次に、Kube-vip Cloud Providerをデプロイします。この小さなコントローラーが、実際のIP割り当てを管理します。
kubectl apply -f https://raw.githubusercontent.com/kube-vip/kube-vip-cloud-provider/main/manifest/kube-vip-cloud-controller.yaml3. IPプールの定義
Kube-vipは、どのIPが使用可能かを知る必要があります。この範囲をConfigMapを使用して定義します。ネットワークに適合する範囲を指定した global-config.yaml というファイルを作成します。
apiVersion: v1
kind: ConfigMap
metadata:
  name: kubevip
  namespace: kube-system
data:
range-global: 192.168.1.100-192.168.1.150これを適用します:kubectl apply -f global-config.yaml。これで、サービスをデプロイするたびに、Kube-vipはこの51個のIPプールから自動的にIPを取得します。
セットアップのテスト
仕組みが正しく動作しているか確認するために、標準的なNginxウェブサーバーをデプロイします。確認には数秒しかかかりません。
kubectl create deployment nginx-test --image=nginx
kubectl expose deployment nginx-test --port=80 --type=LoadBalancerステータスを確認します:kubectl get svc nginx-test。次のような結果が表示されるはずです。
NAME         TYPE           CLUSTER-IP   EXTERNAL-IP     PORT(S)        AGE
nginx-test   LoadBalancer   10.96.0.45   192.168.1.100   80:31234/TCP   5s
ネットワーク上の別のマシンから curl 192.168.1.100 が実行できれば、セットアップは成功です。自身のハードウェア上でクラウド環境をシミュレートすることに成功しました。
現場で学んだ教訓
Kube-vipを本番環境で運用する中で、ローカルネットワークに関するいくつかの重要な教訓を得ました。
- インターフェースの一貫性: ネットワークインターフェース名(
eth0やenp0s3など)がすべてのノードで同一であることを確認してください。1つのノードでも異なる名前を使用していると、その特定のホストでKube-vipポッドがクラッシュします。 - DHCPの予約: VIPの範囲(
192.168.1.100-150)は、必ずDHCPサーバーのプールから除外してください。オフィスのプリンターが本番環境のデータベースと同じIPを偶然取得してしまうことほど、クラスターを瞬時に崩壊させるものはありません。 - フェイルオーバースピード: レイヤー2モードでは、フェイルオーバーは通常10秒以内に行われます。大規模なスケールで1秒未満のフェイルオーバーが必要な場合は、BGP対応のスイッチが必要になりますが、BGPモードへの移行を検討してください。
ベアメタルでの高可用性は、山のような複雑な設定を必要としません。Kube-vipを使用することで、ネットワークロジックをクラスター内部に保持できます。これにより、インフラのメンテナンス、スケーリング、トラブルシューティングが容易になります。ついに、物理サーバーでも「クラウドネイティブ」な体験が可能になったのです。