背景と課題:単一ノードMySQLの限界を突破する
モノリシックなMySQLデータベースで80,000 QPS(Query Per Second)を超えようとすると、垂直スケーリング(スケールアップ)は壁に突き当たります。本番クラスタにおいて、4.2 TBのordersテーブルがAWSのr6i.16xlargeインスタンス(64 vCPU、512 GB RAM)を圧迫していました。プロビジョンドIOPSを40,000まで引き上げても、トラフィック急増時にはディスクのキュー長(Queue Depth)が急上昇しました。書き込みのレプリケーション遅延は日常的に15秒を超え、セカンダリレプリカで古いデータが読み取られるリスクが生じていました。
アプリケーションレベルでのシャーディングは典型的な回避策です。しかし、アプリケーションコードにシャードキーを組み込むことは運用の罠となります。バックエンドサービスはすぐに、独自のコネクションプール、壊れやすい分散トランザクション、ハードコードされたシャードマップが複雑に絡み合った状態に陥ってしまいます。Vitessはよりクリーンなアプローチを採用しています。
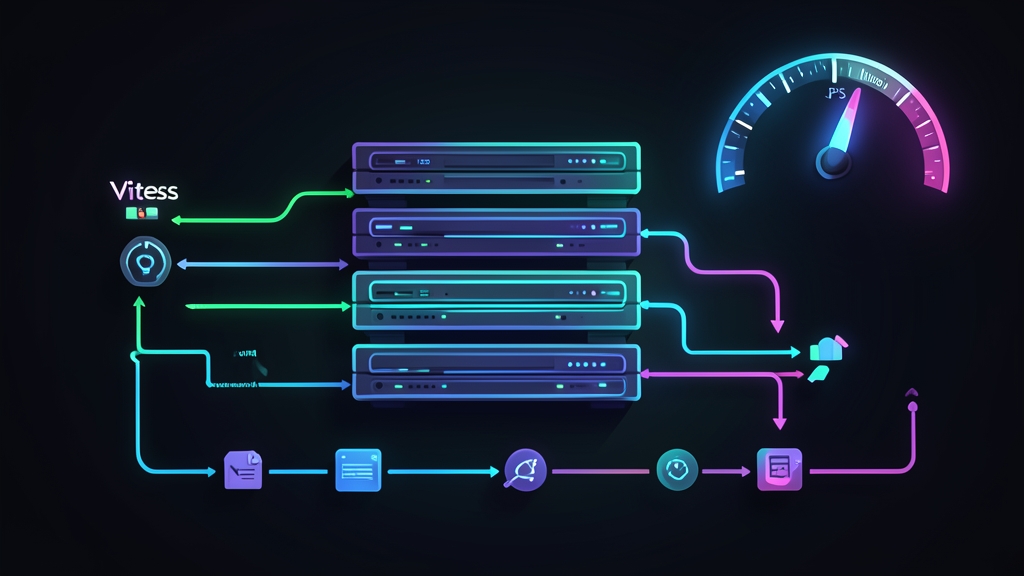
元々はYouTubeで数千ノードにわたる1日数百億回もの動画再生を処理するために開発されたVitessは、抽象化プロキシとして機能します。マイクロサービスは、まるで単一のモノリシックデータベースに接続しているかのように、標準のMySQLプロトコルドライバ経由でVitessと通信できます。内部では、Vitessは運用上の責務を専用の層(ティア)に分割しています。
- VTGate: パブリックフロントエンドとして機能するステートレスプロキシです。受信したSQL構文を解析し、クラスタメタデータからパーティションターゲットを検索して、適切なデータベースシャードへ並行してクエリをルーティングします。
- VTTablet: 各
mysqldプロセスと並行して動作するサイドカーデーモンです。ローカルのコネクションプーリングを管理し、実行制限を超えた暴走クエリ(10秒以上ロックを保持しているクエリなど)を強制終了し、レプリケーション状態を追跡します。 - Topology Service: タブレットのアドレス、シャード範囲、フェイルオーバー状態を保存する合意クラスタ(通常はetcdまたはConsul)です。
- VSchema: テーブル構造、プライマリVIndex(ハッシュキーまたはルックアップキー)、パーティション境界をマッピングするルーティング設定です。
インストール:Kubernetes上へのVitessクラスタのデプロイ
PlanetScaleのVitess Operatorは、自動フェイルオーバー、バックアップジョブ、設定のローリングアップデートなど、Kubernetes上のクラスタライフサイクルタスクを処理します。
まず、Helmリポジトリを追加し、Operatorコントローラーをデプロイします。
helm repo add vitess https://vitess.io/helm-charts/
helm repo update

kubectl create namespace vitess
helm install vitess-operator vitess/vitess-operator --namespace vitess次に、cluster.yamlでクラスタ仕様を定義します。このマニフェストは、etcdトポロジーバッカー、zone1という名前のセル、2つのVTGateプロキシ、そしてcommerceという名前の初期非シャードキースペースをプロビジョニングします。
apiVersion: planetscale.com/v2
kind: VitessCluster
metadata:
  name: production-db
  namespace: vitess
spec:
  cells:
    - name: zone1
      gateway:
        replicas: 2
        resources:
          limits:
            cpu: "2"
            memory: 4Gi
          requests:
            cpu: "500m"
            memory: 1Gi
  topology:
    etcd:
      replicas: 3
  keyspaces:
    - name: commerce
      turndownStrategy: Immediate
      partitionings:
        - equal:
            parts: 1
            shardTemplate:
              tabletControl:
                - tabletType: replica
                  cells: [zone1]
              tablets:
                - type: replica
                  replicas: 2
                  resources:
                    limits:
                      cpu: "4"
                      memory: 8Gi
マニフェストを適用し、Podがヘルスチェックを通過するのを待ちます。
kubectl apply -f cluster.yaml
kubectl wait --for=condition=Ready vitesscluster/production-db -n vitess --timeout=300s
設定:VSchemaの設計とシャードの分割
クラスタが稼働したら、次のマイルストーンはシャード化キースペースを定義し、大量のデータを抱えるテーブルを独立したMySQLインスタンスに分割することです。
1. VSchemaの定義
Vitessは64ビットのキースペースIDを使用して、行を物理タブレットに分散配置します。このスキーマをvschema_orders.jsonとして保存します。これには、組み込みのhash VIndexを使用し、customer_idに基づいてシャード境界全体に行を均等に分散させます。
{
  "sharded": true,
  "vindexes": {
    "hash_index": {
      "type": "hash"
    }
  },
  "tables": {
    "customers": {
      "column_vindexes": [
        {
          "column": "customer_id",
          "name": "hash_index"
        }
      ]
    },
    "orders": {
      "column_vindexes": [
        {
          "column": "customer_id",
          "name": "hash_index"
        }
      ]
    }
  }
}vtctlclientを使用して、対象のキースペース(customer_db)にVSchemaをアップロードします。
vtctlclient --server vtctld.vitess:15999 ApplyVSchema \
  --vschema-file vschema_orders.json customer_db
2. キースペースのシャード分割
Vitessは16進数の範囲を使用してシャードの間隔を表します。2シャード構成の場合、キースペースのハッシュ範囲00〜ffを-80(0x00〜0x7f)と80-(0x80〜0xff)の2つに均等分割します。
# シャード1(-80)のプライマリおよびレプリカタブレットをプロビジョニング
vtctlclient --server vtctld.vitess:15999 CreateShard customer_db/-80

# シャード2(80-)のプライマリおよびレプリカタブレットをプロビジョニング
vtctlclient --server vtctld.vitess:15999 CreateShard customer_db/80-
3. テーブルの移行とルーティングの切り替え
オンラインデータ分割は、ダウンタイムなしでMoveTablesワークフローを通じて実行されます。VTGateはデュアルライトを処理し、既存レコードを同期させ、最終的な移行フェーズでは実行中のトランザクションをバッファリングします。
# オンラインバックグラウンドでのデータコピーを開始
vtctlclient --server vtctld.vitess:15999 MoveTables \
  --workflow=order_migration customer_db/-80,customer_db/80- Create

# 移行元と移行先シャード間のレプリケーション遅延を確認
vtctlclient --server vtctld.vitess:15999 MoveTables \
  --workflow=order_migration Status

# コネクション切断なしで読み取りおよび書き込みトラフィックを切り替え
vtctlclient --server vtctld.vitess:15999 MoveTables \
  --workflow=order_migration SwitchTraffic
1億2,000万行の移行中も、レプリケーション遅延は常に150ミリ秒未満に抑えられました。最終的な書き込みトラフィックの切り替えでは、クライアントリクエストのバッファリングはわずか85ミリ秒で完了しました。
検証とモニタリング:クエリルーティングと健全性のテスト
トラフィックの切り替え後、VTGateがクライアントクエリを正しいシャードにルーティングしていること、また可能な限りスキャッターギャザーによるペナルティを回避できていることを確認する必要があります。
1. MySQL CLI経由でのVTGateルーティングのテスト
VTGateは標準のMySQLポート15306を公開しています。標準的なデータベースクライアントツールから直接接続できます。
mysql -h vtgate.vitess.svc.cluster.local -P 15306 -u vtgate_user実行計画を確認するには、対象のSQLクエリの先頭にEXPLAIN FORMAT = VITESSを付加します。
USE customer_db;

-- ハッシュ化されたcustomer_idによる単一シャードへの直接ターゲット
EXPLAIN FORMAT = VITESS
SELECT * FROM orders WHERE customer_id = 1045;

-- 全シャードにまたがるスキャッターギャザークエリ
EXPLAIN FORMAT = VITESS
SELECT COUNT(*) FROM orders WHERE created_at > '2026-01-01';1つ目のクエリは、customer_id = 1045のMD5ハッシュを検査します。このハッシュ値は-80の範囲に収まるため、VTGateはクエリをタブレットcustomer_db/-80へ直接ルーティングし、3ミリ秒未満のレイテンシで処理されます。2つ目のクエリにはシャードキーがありません。そのため、VTGateは両方のシャードへステートメントをブロードキャストし、中間集計結果を収集して合算値を返す必要があり、若干のレイテンシコスト(約11ミリ秒)が発生します。
2. Vitessの主要なPrometheusメトリクス
すべてのVitessデーモンはポート15000でPrometheusメトリクスを公開しています。本番環境では以下の4つの指標を注視してください。
vtgate_queries_total{keyspace="customer_db"}: キースペースおよびプランタイプごとのクエリレートを追跡します。ここでの急増アラートは、予期しないスキャッターギャザークエリのバーストを示します。vttablet_query_latency_seconds_bucket: 個々のシャードノードでの実行時間を監視します。レイテンシが25ミリ秒を超えた場合にP99アラートを設定してください。vttablet_pool_wait_count: コネクションの飽和を示します。1秒あたり5回を超える待機が発生している場合、VTTabletのコネクションプールを拡張する必要があります。vitess_replication_lag_seconds: リードレプリカの遅延を測定します。リードオンリーレプリカでの古いデータの読み取りを防ぐため、アラートのしきい値は5秒に設定してください。
VTGateのプロキシルーティングとKubernetesの自動化を組み合わせることで、単一ノードのボトルネックが解消されます。アプリケーション層を複雑化させることなく、MySQLクラスタは線形な書き込みスケーラビリティを獲得し、200,000超のQPSを難なく処理できるようになります。