「パイプラインのオールグリーン」という錯覚
想像してみてください。GitHub Actionsのパイプラインは眩しいほどのグリーンに輝き、全420個のユニットテストはすべてパス、自信満々で main ブランチへとマージしたとします。ところがそのわずか6分後、ステージング環境へのデプロイがクラッシュしてしまいました。昨年、私たちのチームはまさにこの壁にぶつかりました。決済サービスのコードカバレッジは92%を誇っていましたが、PostgreSQL固有の DISTINCT ON 構文を含むクエリがステージングで即座にエラーを起こしたのです。原因は何だったのでしょうか?ユニットテストをインメモリのSQLiteで実行していたため、本番データベースが弾くクエリをSQLiteが暗黙的に受け入れてしまっていたのです。
環境差異(エンバイロメンタル・ドリフト)の追跡と修正には、膨大な開発者時間が奪われました。ローカルPC上では、エンジニアがコミットされていないスキーマパッチを含む長寿命なDockerコンテナを立ち上げていたためテストが通っていました。一方CIでは、ネットワークのタイムアウト、実際の制約違反、Redisクラスタのトポロジなどを一切シミュレートできないモックに依存していました。フィードバックループは完全に破綻していたのです。
従来の結合テスト手法がCI環境で破綻する理由
結合テストにおける悩みの多くは、次の2つの典型的な落とし穴に起因しています。
1. インメモリデータベースの落とし穴
H2やSQLite、モックHTTPサーバーといった軽量な代替手段は、実際のインフラではなく「開発者の想定」に対してアプリケーションロジックを検証しているに過ぎません。SQLiteでは、PostgreSQLの JSONB パス演算子、部分インデックス、ストアドプロシージャ、行レベルロックの挙動などを正しく検証できません。モックはリポジトリが実行メソッドを呼び出したことまでは証明してくれますが、シリアライズ可能な厳格な分離レベルでデッドロックしたトランザクションのロールバック失敗を警告してくれることは決してありません。
2. 共有ステージングデータベースのボトルネック
モックの限界を感じたチームが次に陥りがちなのが、CIランナーの接続先をリモートの共有データベースに向けるアプローチです。これは即座に競合状態(レースコンディション)を引き起こします。2つのPRビルドが同時に走る場面を想像してください。ブランチAがカラムを削除するマイグレーションを実行しているまさにその瞬間、ブランチBがそのテーブルへのINSERTクエリを試みます。テストは断続的に失敗し、開発者は習慣のようにジョブを再実行し、破損した状態データのクリーンアップが日課となってしまいます。
依存関係戦略の比較
テストインフラを標準化するにあたり、私たちは50のパイプライン並列実行にわたって一般的な3つの戦略のベンチマークを実施しました。
- CI上での静的Docker Compose: モックよりは優れているものの、柔軟性に欠けます。ハードコードされたポートバインディング(
5432:5432など)は、セルフホストランナー上でジョブを並列実行した際にポートの衝突を引き起こします。さらに、強制終了されたジョブの残留コンテナが以降のビルドを汚染する原因にもなります。 - インメモリフェイク(H2、SQLite、embedded-redis): テスト1件あたり平均15ms未満と圧倒的に高速です。しかし、本番環境との再現性のギャップ(忠実性の欠如)が原因で、互換性のないSQLダイアレクトでテストをグリーンにするためだけに、不要な条件分岐コードをアプリケーションに書かざるを得なくなります。
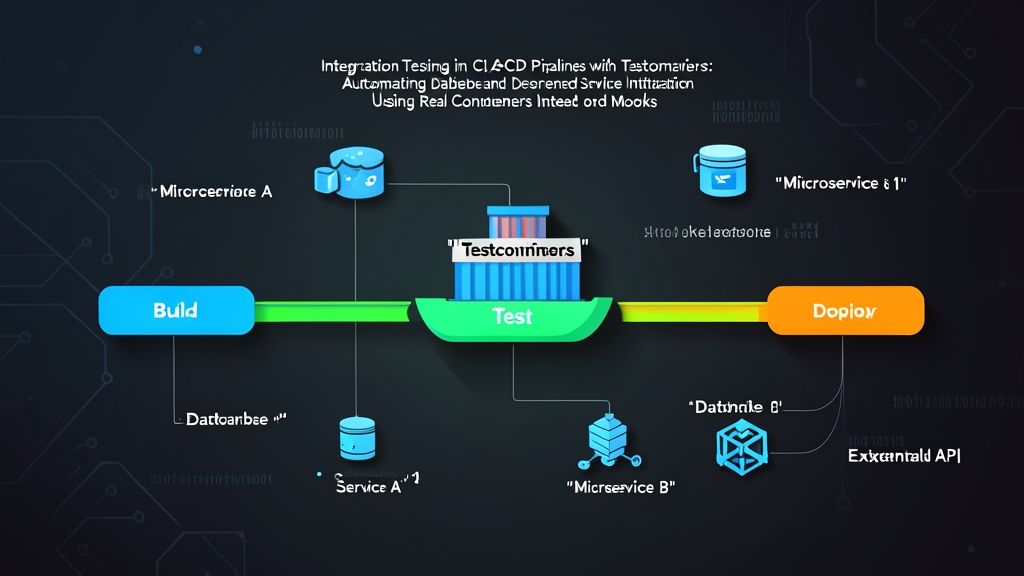
- プログラムによるエフェメラルコンテナ(Testcontainers): テストランナーが必要に応じて本物のサービスインスタンスをオンデマンドで生成、ネットワーク接続、そして破棄します。すべてのテストスイートがランダムなエフェメラルポート上で完全に分離されたインスタンスを取得できます。ランナーが突然クラッシュした場合でも、自動クリーンアップデーモンがゴミを確実に片付けてくれます。
実践ガイド:CI/CDでTestcontainersを実行する
Testcontainersは、インフラの定義をアプリケーションコード内に直接取り込みます。テスト実行前に複雑なシェルスクリプトと格闘する代わりに、プログラミング言語ネイティブのバインディングを介して依存関係を直感的に管理できます。
チェックアウトサービスにこのアプローチを導入した結果、1日300回以上のビルドにおいて、ステージング環境でのリグレッション発生率が約14%からゼロへと激減しました。
ステップ1:分離された結合テストを作成する
以下のPythonサンプルでは、pytest と testcontainers-python を使用して、本物のPostgreSQL 16.2インスタンスを起動し、マイグレーションを実行した上で、ネイティブな JSONB クエリ演算子の検証を行っています。
import pytest
import psycopg2
from testcontainers.postgres import PostgresContainer

@pytest.fixture(scope="session")
def postgres_connection_string():
    # ランダムなホストポート上に分離されたPostgreSQL 16コンテナを起動
    with PostgresContainer("postgres:16.2-alpine") as postgres:
        # psycopg2ドライバのURLフォーマットを直接使用
        yield postgres.get_connection_url(driver=None)

@pytest.fixture(scope="function")
def db_session(postgres_connection_string):
    conn = psycopg2.connect(postgres_connection_string)
    cursor = conn.cursor()
    cursor.execute("""
        CREATE TABLE IF NOT EXISTS customer_profiles (
            id SERIAL PRIMARY KEY,
            username VARCHAR(50) NOT NULL UNIQUE,
            preferences JSONB NOT NULL
        );
    """)
    conn.commit()
    yield conn
    # 各テストケース間の高速クリーンアップ
    cursor.execute("TRUNCATE TABLE customer_profiles RESTART IDENTITY CASCADE;")
    conn.commit()
    conn.close()

def test_jsonb_indexing_and_extraction(db_session):
    cursor = db_session.cursor()
    cursor.execute(
        """INSERT INTO customer_profiles (username, preferences)
           VALUES (%s, %s) RETURNING id;""",
        ("sarah_tech", '{"notifications": {"email": true, "sms": false}}')
    )
    user_id = cursor.fetchone()[0]
    db_session.commit()

    # PostgreSQLネイティブの ->> 演算子でネストされたJSONパスをクエリ
    cursor.execute(
        "SELECT preferences->'notifications'->>'email' FROM customer_profiles WHERE id = %s;",
        (user_id,)
    )
    email_enabled = cursor.fetchone()[0]
    assert email_enabled == "true"
ステップ2:GitHub Actionsの設定
Testcontainersは /var/run/docker.sock を介してローカルホストのDockerエンジンと通信します。標準のLinuxランナー(ubuntu-latest など)にはあらかじめDockerがプリインストールされているため、ワークフロー側で追加のデーモン設定を行う必要はありません。
name: Integration Tests

on:
  push:
    branches: [ main ]
  pull_request:
    branches: [ main ]

jobs:
  test:
    runs-on: ubuntu-latest
    timeout-minutes: 15

    steps:
      - name: リポジトリのチェックアウト
        uses: actions/checkout@v4

      - name: Python 3.11のセットアップ
        uses: actions/setup-python@v5
        with:
          python-version: '3.11'
          cache: 'pip'

      - name: 依存パッケージのインストール
        run: |
          python -m pip install --upgrade pip
          pip install pytest psycopg2-binary "testcontainers[postgres]"

      - name: 結合テストの実行
        run: pytest tests/integration -v --tb=short
大規模CI環境で実証されたベストプラクティス
1. テストセッション全体でコンテナを再利用する
PostgreSQLコンテナを個別に起動するには、通常2.5〜3.5秒程度かかります。テスト関数が60個ある場合、テストごとにコンテナを立ち上げ直すと、ビルド時間が3分以上も長くなってしまいます。そのため、コンテナのフィクスチャスコープは session に設定するのが得策です。テスト間のデータ初期化には高速な TRUNCATE 文やトランザクションのロールバックを活用し、コンテナの再起動はスキーマ変更を伴うマイグレーションの検証時のみに限定しましょう。
2. 具体的なイメージダイジェストを固定(Pin)する
postgres:16 や redis:alpine といったフローティングタグを使用すると、アップストリームでベースイメージが更新された際に予期せぬ破壊的変更が紛れ込む恐れがあります。postgres:16.2-alpine3.19 のように、正確なマイナーリリースやSHAダイジェストを指定して固定してください。これにより、突然の認証仕様の変更、デフォルトメモリ設定の変更、バイナリの不一致などからパイプラインを保護できます。
3. 並列プルでランナーキャッシュをウォームアップする
Kafka(約450MB)やLocalStack(約900MB)などの大容量イメージは、新規ランナーインスタンスでのダウンロードだけで2分近く浪費することがあります。テストスイートを実行する前に、明示的なウォームアップステップを追加してイメージを並列ダウンロードしましょう。
docker pull postgres:16.2-alpine &
docker pull redis:7.2-alpine &
wait
4. Ryukは有効のままにしておく
Testcontainersには、Ryuk(testcontainers/ryuk)と呼ばれる軽量なリーパー(刈り取り)コンテナが同梱されています。Ryukはランナーエンジンとのアクティブなソケット接続を常に維持しています。テストランナーがクラッシュしたり、実行途中でキャンセルされたりした場合でも、Ryukが孤立したコンテナ、ネットワーク、ボリュームを即座に破棄してくれます。わずか100msを削るためにRyukを無効化すると、セルフホストCIノードのディスク容量が数日で枯渇する原因になりがちです。
まとめ
モックがテストするのは「こう動いてほしいという期待」であり、Testcontainersがテストするのは「本番環境で実際に起きること」です。テストランナーの制御下に本物の使い捨て依存関係を直接置くことで、環境差異を完全に排除できます。パイプラインの緑のチェックマークを、本来あるべき意味――「いつでも本番リリース可能なコードであることの証」へと変えましょう。