数週間前、複数のCSVおよびParquetファイルに分散された15GBの未加工イベントログをエクスポートして集計する必要がありました。従来の方法であれば、Snowflakeのウェアハウスを立ち上げるか、ローカルのPostgreSQLインスタンスにすべてロードすることになります。しかし、どちらの方法も骨の折れる作業でした。15GBのデータをPostgresにロードするのに18分以上かかり、Snowflakeを使うと、わずか5つの簡単な分析クエリを実行するためだけにネットワークレイテンシ、データ転送料金、クラスター管理のオーバーヘッドが発生してしまいます。
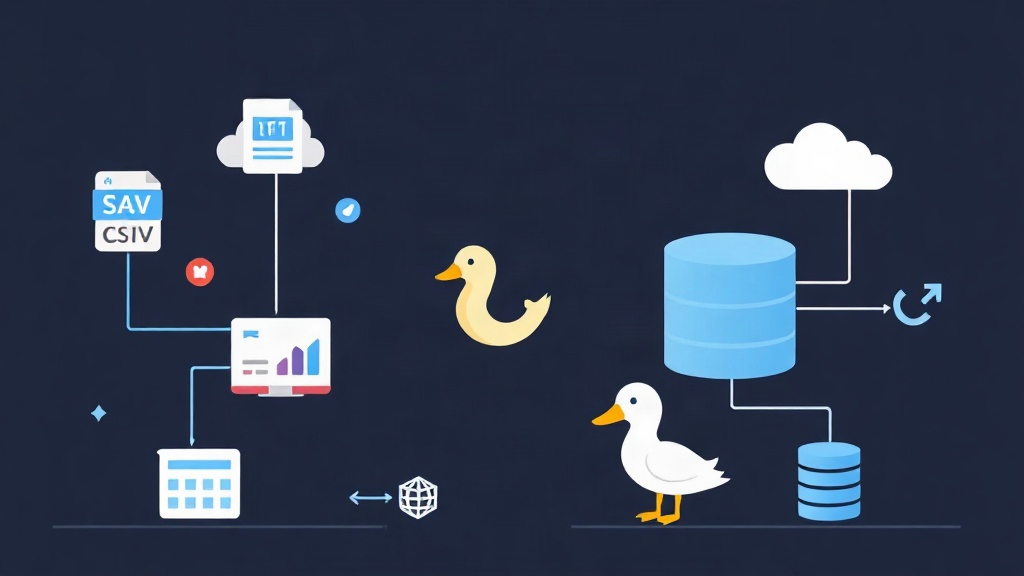
なぜ従来のツールではこのようなワークフローが非効率になるのでしょうか? トランザクション処理向けのデータベースはデータを1行ずつ読み込みます(OLTP)。そのため、50列あるうちの2列の平均値を計算したいだけの場合でも、CPUキャッシュラインを無駄に浪費してしまいます。一方、クラウドデータウェアハウスは大掛かりなセットアップや継続的なコスト、頻繁なネットワーク転送が必要です。DuckDBはこれらすべての問題を解決します。アプリケーションプロセス内に組み込みで動作し、ベクトル化された列指向(カラムナー)OLAPエンジンとして機能します。
1. アプローチの比較:従来ツール vs インプロセスOLAP
ツールごとに得意とする領域は異なります。PostgreSQLは並行トランザクションを確実に処理し、MongoDBはネストされたドキュメントの保存を容易にします。しかし、1台のノートPCでフラットファイルから8,000万行ものデータを処理しようとすると、これらのエンジンは限界に直面します。
一般的なデータ処理オプションの比較は以下の通りです:
- Pandas / Polars: スクリプト記述には便利ですが、PandasはRAMを超えるデータセットに対してメモリ不足(OOM)エラーで簡単にクラッシュします。Polarsはストリーミング処理をよりうまく処理できますが、異種ファイルにまたがる複雑な複数テーブルのSQL結合やウィンドウ関数の記述には依然として扱いにくさがあります。
- PostgreSQL / MySQL: 信頼性の高いSQLエンジンですが、最初のクエリを実行する前にスキーマ定義、テーブル作成、そして時間のかかる一括
COPYコマンドの完了を待つ必要があります。 - クラウドデータウェアハウス(Snowflake、BigQuery): ペタバイト規模のチーム向けに構築されていますが、アドホックな探索的分析には過剰です。コンピュートのアイドル料金を支払い、IAM権限を管理し、ネットワーク経由でギガバイト単位のデータをアップロードしなければなりません。
- DuckDB: ゼロコピー読み込みでフラットファイルに直接クエリを実行でき、メモリ外(out-of-core)ストリーミングによって利用可能なRAMを超えるデータセットを処理可能で、デーモンのセットアップも一切不要です。
2. DuckDBのメリットとデメリット
DuckDBは高速ですが、あらゆるデータベースの課題に対する万能薬ではありません。ここでは、DuckDBの強みと弱点を整理します。
メリット
- インフラ不要(ゼロインフラ): C++、Python、Node.jsなどのインプロセスライブラリとして動作します。パッチ適用、セキュリティ対策、監視が必要なサーバーはありません。
- ネイティブなファイル形式サポート: CSV、Parquet、JSON、Arrow、およびリモートのS3/GCSバケットをSQLクエリ内で直接読み書きできます。
- 列指向のベクトル化実行: SIMD命令を使用してデータを2,048件単位のチャンクで処理します。これによりCPUスループットが最大化され、メモリ消費を低く抑えられます。
- クロスソースクエリ: 1つの統合SQLクエリ内で、稼働中のSQLiteやPostgreSQLテーブルとローカルのParquetファイルを結合できます。
デメリット
- 単一ライターの制約: DuckDBはSQLiteと同様の並行性モデルを採用しています。複数のプロセスが同一のデータベースファイルに同時に書き込むことはできません。
- 高頻度なOLTPには不向き: 単一レコードの検索、頻繁な1行挿入、高並行性のトランザクション更新などは、引き続きPostgreSQLやMySQLを使用すべきです。
3. 推奨セットアップとアーキテクチャ
セットアップはタスクに応じて選択します。対話型の探索的分析や素早いファイル確認にはスタンドアロンのCLIバイナリを使用し、自動化されたETLパイプラインやバックエンドサービスにはPythonパッケージをインストールします。
インストール
# Linux/macOSでスタンドアロンDuckDB CLIをインストール
curl https://install.duckdb.org | sh

# またはPython経由でインストール
pip install duckdb pandas pyarrow
Pythonにインストールすると、DuckDBはシリアライズやデータの重複なしに、メモリ内のPandas DataFrameやApache Arrowテーブルに対して直接クエリを実行できます。
4. 実装ガイド:ファイルおよび複数データソースへのクエリ
ここからは実践的な例を見ていきましょう。生ファイルへのクエリ、集計パイプラインの自動化、そして異なるデータベース間のデータ結合を取り上げます。
SQLでCSVやParquetファイルに直接クエリを実行する
スキーママイグレーションの手間は不要です。DuckDBがサンプル行を検査し、列名とデータ型を自動的に推論します。
-- インプロセスインメモリモードでCLIを起動:
-- duckdb

-- globパターンを使用して複数のCSVファイルに直接SQLクエリを実行
SELECT
    category,
    COUNT(*) AS total_orders,
    ROUND(AVG(price), 2) AS avg_price,
    ROUND(SUM(price * quantity), 2) AS total_revenue
FROM 'sales_data_*.csv'
WHERE order_status = 'COMPLETED'
GROUP BY category
ORDER BY total_revenue DESC
LIMIT 5;
Parquetファイルを使用すると、パフォーマンスはさらに向上します。DuckDBは行グループのメタデータや列統計情報を読み取ることで、不要なブロックを完全にスキップ(述語プッシュダウン)し、要求された列のみをディスクから取得します:
-- データセット全体をスキャンせずにParquetデータをフィルタリング
SELECT
    customer_id,
    SUM(amount) AS total_spent
FROM 'transactions.parquet'
WHERE transaction_date >= '2026-01-01'
GROUP BY customer_id
HAVING total_spent > 5000;
Pythonでのパイプライン自動化
Pythonでは、DuckDBは結果を直接ディスクに書き戻す超高速な変換ステップとして機能します:
import duckdb

# インメモリセッションに接続
con = duckdb.connect()

# 数百万行のログを集計し、圧縮Parquetに直接エクスポート
query = """
    COPY (
        SELECT
            date_trunc('month', timestamp) AS month,
            country,
            count(DISTINCT user_id) AS active_users,
            sum(bytes_sent) / (1024 * 1024) AS total_mb
        FROM 'logs/*.parquet'
        WHERE status_code = 200
        GROUP BY 1, 2
    ) TO 'aggregated_metrics.parquet' (FORMAT PARQUET, COMPRESSION ZSTD);
"""

con.execute(query)
print("集計が完了しました: 結果は aggregated_metrics.parquet に書き込まれました")
ETL不要で複数データソースを接続する
異なるシステム間のデータを統合するためにETLパイプラインを構築する代わりに、外部データベースをオンザフライでアタッチします:
-- SQLite拡張機能をインストールしてロード
INSTALL sqlite;
LOAD sqlite;

-- アプリケーションデータベースをアタッチ
ATTACH 'app_users.db' AS sqlite_db (TYPE SQLITE);

-- トランザクションユーザーデータと分析用イベントファイルを結合
SELECT
    u.username,
    u.email,
    count(e.event_id) AS total_events
FROM sqlite_db.users u
JOIN 'events_2026.parquet' e ON u.id = e.user_id
GROUP BY u.username, u.email
ORDER BY total_events DESC
LIMIT 10;
DuckDBは、生ファイルと複雑なデータベースの間のギャップを埋める存在です。ローカルマシン上でデータウェアハウス並みのパフォーマンスが得られ、ローカル分析のためのクラウドコストはゼロ、管理すべきサーバーも存在しません。