アプローチ比較:純粋なベクトル検索 vs キーワード検索 vs ハイブリッド検索
「Garbage in, garbage out(ゴミを入れればゴミが出る)」――検索拡張生成(RAG)において、生成される回答の品質は取得されるコンテキストの精度に直結します。
エンジニアリングチームは、OpenAIのtext-embedding-3-smallなどのモデルが高レベルな意味的意図を捉えられることから、密ベクトル検索から着手することがよくあります。しかし、ベクトル検索は完全一致の処理が苦手です。例えばSKU-9921-XのようなSKU、ERR_AUTH_4019のようなエラーコード、あるいはpthread_mutex_lockのような関数名を検索した場合、純粋なベクトル検索では文脈的に関連しているものの実質的には役に立たないチャンクが頻繁にヒットしてしまいます。
語彙検索(一般的にはBM25)はその逆の仕組みで動作します。コーパス全体の単語出現頻度(TF)と逆文書頻度(IDF)を計算し、完全一致するトークンをランク付けします。高速で挙動の予測がつきやすい反面、ユーザーが類義語、自然な言い回し、あるいはドキュメントと完全に一致しない説明的な質問で検索した途端に機能しなくなります。
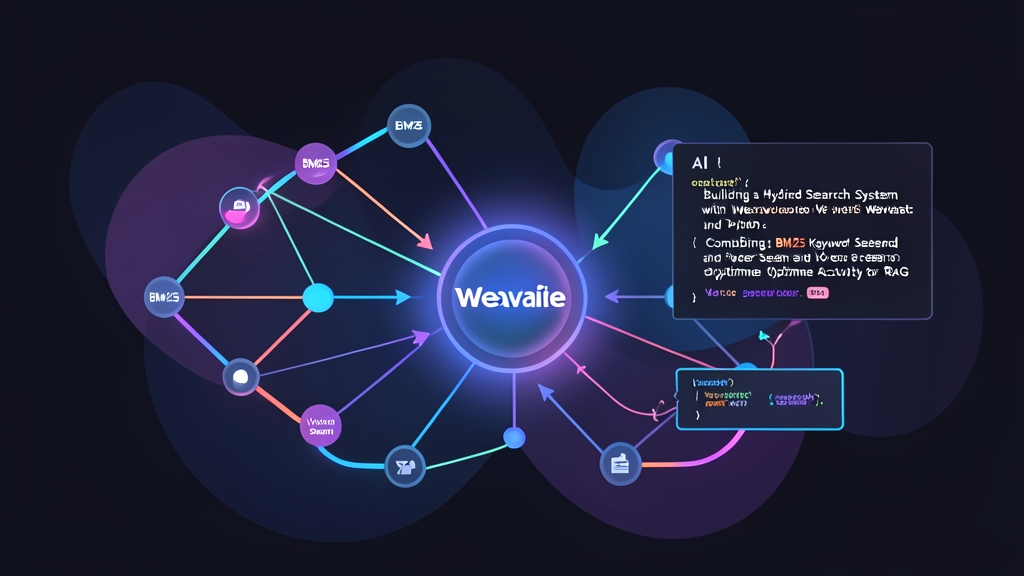
ハイブリッド検索はこのギャップを埋めるアプローチです。密ベクトル検索とスパースなBM25検索を並行して実行し、それぞれのスコアリストを統合されたランキングへとマージします。技術ドキュメントを対象としたベンチマークにおいて、ハイブリッド検索は純粋なベクトル検索と比較してRecall@10を日常的に15%〜25%向上させます。Weaviateはデフォルトの相対スコア融合(relative score fusion)や逆数順位融合(RRF: Reciprocal Rank Fusion)を用いて、このフュージョン処理をネイティブに処理します。
Weaviateにおけるハイブリッド計算式の仕組み
Weaviateでは、キーワードと埋め込みのバランスを単一の重み付けパラメータalphaで制御します。
alpha = 1.0: 100%のベクトル検索。完全一致キーワードを完全に無視し、意味的な類似度のみでランキングを決定します。alpha = 0.0: 100%のBM25キーワード検索。密ベクトル埋め込みは無視されます。alpha = 0.5: キーワード一致と意味的ベクトルスコアを50対50の均等な比率で組み合わせます。
各検索戦略のメリットとデメリット
適切な検索手法を選択するには、レイテンシ、リソースのオーバーヘッド、およびドメイン固有の要件のバランスを取る必要があります。
純粋なBM25検索
- メリット: 5ミリ秒未満のクエリレイテンシ、推論コストがゼロ、低頻度トークンや16進数ID、部品番号に対する高精度な一致。
- デメリット: 意味的な理解が完全に欠如している点。「クラッシュ」と「例外」のような直接的な同義語を取りこぼし、ファジーマッチを手動で設定しない限りタイポにも対応できません。
純粋なベクトル検索
- メリット: キーワードが一致しなくても、曖昧なユーザー入力、多言語クエリ、概念的な質問を柔軟に処理可能。
- デメリット: クエリごとに埋め込み生成が必要(p95レイテンシが30ms〜120ms増加)、語彙外(OOV)の技術的識別子の扱いに苦慮する点、およびAPIやGPUの計算コストが発生する点。
Weaviateによるハイブリッド検索
- メリット: 多様なクエリタイプにおいて高い再現率(Recall)を実現。ユーザーの意図に応じてクエリごとに
alphaを動的に調整可能。 - デメリット: WeaviateがHNSWベクトルインデックスと転置キーワードインデックスの両方をディスク上に保持するため、ストレージ使用量が約20%〜35%増加する点。
推奨アーキテクチャ
本番環境へのデプロイでは、Docker Composeで稼働するWeaviateと公式のPython v4クライアント(weaviate-client >= 4.9.0)の組み合わせを推奨します。v4クライアントはREST(ポート8080)とgRPC(ポート50051)の両方で通信します。このデュアルチャネル設計により、従来のv3(RESTのみ)クライアントと比較してバッチ取り込みやクエリ解析が劇的に高速化されます。
前提条件
- Python 3.10以降
- DockerおよびDocker Compose
text-embedding-3-smallおよびgpt-4o-miniを利用可能なOpenAI APIキー
1. Docker ComposeでWeaviateを起動
作業ディレクトリにdocker-compose.ymlファイルを作成します:
services:
  weaviate:
    image: cr.weaviate.io/semitechnologies/weaviate:1.27.0
    restart: on-failure:0
    ports:
      - "8080:8080"
      - "50051:50051"
    environment:
      QUERY_DEFAULTS_LIMIT: 25
      AUTHENTICATION_ANONYMOUS_ACCESS_ENABLED: 'true'
      PERSISTENCE_DATA_PATH: '/var/lib/weaviate'
      ENABLE_MODULES: 'text2vec-openai'
      CLUSTER_HOSTNAME: 'node1'
コンテナをバックグラウンド(デタッチモード)で起動します:
docker compose up -d2. Pythonの依存パッケージをインストール
v4クライアントとOpenAIのSDKをインストールします:
pip install "weaviate-client>=4.9.0" "openai>=1.40.0"ステップ別の実装手順
ここでは、接続の確立、ベクトル化を有効にしたコレクションの定義、サンプルの技術ドキュメントの挿入、およびハイブリッドクエリの実行手順を解説します。
ステップ1:Weaviateへの接続とコレクションの定義
hybrid_rag.pyを作成します。Weaviate v4では、ネイティブな型ヒントと明示的なスキーマ設定を備えたコレクション機能が導入されています。
import os
import weaviate
from weaviate.classes.config import Configure, Property, DataType

os.environ["OPENAI_APIKEY"] = "ここにOpenAIのAPIキーを入力"

client = weaviate.connect_to_local(
    headers={
        "X-OpenAI-Api-Key": os.environ["OPENAI_APIKEY"]
    }
)

print(f"接続状態: {client.is_ready()}")

if client.collections.exists("TechnicalDocs"):
    client.collections.delete("TechnicalDocs")

docs_collection = client.collections.create(
    name="TechnicalDocs",
    vectorizer_config=Configure.Vectorizer.text2vec_openai(
        model="text-embedding-3-small"
    ),
    properties=[
        Property(name="title", data_type=DataType.TEXT),
        Property(name="content", data_type=DataType.TEXT),
        Property(name="code_snippet", data_type=DataType.TEXT),
    ]
)

print("TechnicalDocsコレクションが正常に作成されました。")
ステップ2:サンプル技術ドキュメントの登録
実践的な3つのサポート事例スニペットをコレクションに登録します。大まかな説明文と正確なエラーストリング、コードスニペットがどのように組み合わされているかに注目してください:
documents = [
    {
        "title": "認証トークンの有効期限切れ",
        "content": "ゲートウェイセッションで自動更新が有効になっていない状態でJWTトークンが3600秒を超えると、ユーザーにERR_AUTH_4019が発生します。",
        "code_snippet": "jwt.verify(token, secret, { maxAge: '1h' });"
    },
    {
        "title": "データベース接続プールの枯渇",
        "content": "高負荷な同時アクセストラフィック下で、接続プールサイズがデフォルトの10のままの場合、PostgreSQL接続プールはERR_CONN_5003をスローします。",
        "code_snippet": "pool = new Pool({ max: 20, idleTimeoutMillis: 30000 });"
    },
    {
        "title": "キャッシュ破棄におけるメモリリーク",
        "content": "上限のないマップキャッシュにより、オーケストレーターからコンテナがOOM killシグナルを受信するまでメモリ消費が徐々に増加します。",
        "code_snippet": "const cache = new LRUCache({ max: 500 });"
    }
]

with docs_collection.batch.dynamic() as batch:
    for doc in documents:
        batch.add_object(properties=doc)

print(f"{len(documents)}件のドキュメントを挿入しました。")
ステップ3:ベクトル、BM25、およびハイブリッドモードによるクエリ実行
典型的なサポートのプロンプト例として、"ERR_AUTH_4019のセッションタイムアウトを解決するにはどうすればよいですか?"を考えてみましょう。このクエリは2つの要件を同時にテストします。ERR_AUTH_4019という正確なトークン一致と同時に、「セッションタイムアウト」に対する意味的な理解が求められます。
query = "ERR_AUTH_4019のセッションタイムアウトを解決するにはどうすればよいですか?"

# 1. 純粋なBM25検索(alpha = 0)
response_bm25 = docs_collection.query.bm25(
    query=query,
    limit=1
)

# 2. 純粋なベクトル検索
response_vector = docs_collection.query.near_text(
    query=query,
    limit=1
)

# 3. ハイブリッド検索(alpha = 0.5でキーワードと意味のバランスを調整)
response_hybrid = docs_collection.query.hybrid(
    query=query,
    alpha=0.5,
    limit=1
)

print("--- ハイブリッド検索結果 ---")
for item in response_hybrid.objects:
    print(f"タイトル: {item.properties['title']}")
    print(f"スニペット: {item.properties['content']}")
ステップ4:上位結果をLLMに入力
ハイブリッド検索の上位結果をLLMのコンテキストウィンドウに渡し、最終的な回答を生成します:
from openai import OpenAI

ai_client = OpenAI(api_key=os.environ["OPENAI_APIKEY"])

retrieved_context = "\n".join([
    f"{obj.properties['title']}: {obj.properties['content']}"
    for obj in response_hybrid.objects
])

system_prompt = f"""あなたはテクニカルサポートアシスタントです。提供されたコンテキストのみを使用してユーザーのプロンプトに答えてください。

コンテキスト:
{retrieved_context}
"""

completion = ai_client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "system", "content": system_prompt},
        {"role": "user", "content": query}
    ]
)

print("\n--- LLMの最終回答 ---")
print(completion.choices[0].message.content)

client.close()
本番環境におけるAlphaパラメータのチューニング
alphaは一度設定したら終わりというパラメータではありません。開発段階ではalpha=0.5をベースラインとして始めましょう。クエリの大半がSKUの検索、ログトレース、または正確なコードシンボルである場合は、alphaを0.3または0.4に引き下げます。これにより完全一致するBM25のヒットが優先され、表現が似ている別のエラーに対する修正方法をモデルがハルシネーション(もっともらしい嘘)で生成するのを防ぎます。逆に、ユーザーが自由形式の文章を入力する対話型の検索バーの場合は、alphaを0.7に引き上げて意味的なニュアンスを優先させます。