Vấn đề thực tế trong quá trình triển khai Production
Trước đây, mỗi đợt release vào thứ Sáu đều mang lại cảm giác bất an quen thuộc. Về lý thuyết, rolling update tiêu chuẩn nghe rất tuyệt vời, nhưng lại hoàn toàn bất lực trước các lỗi âm thầm (silent failures). Khi bạn deploy phiên bản 2.0, các pod vượt qua readiness probe cơ bản và Kubernetes lập tức định tuyến 100% traffic của người dùng tới chúng. Sau đó, hàng loạt lỗi HTTP 500 bắt đầu đổ về.
Môi trường Staging hiếm khi phát hiện được các lỗi ở trường hợp biên (edge cases). Một lỗi rò rỉ bộ nhớ (memory leak) trong worker xử lý đơn hàng của chúng tôi từng ẩn mình suốt cho đến khi chạm mốc 800 request đồng thời trên production. Chỉ trong vòng bốn phút, 30% giao dịch thanh toán đang xử lý đã bị hủy trước khi bất kỳ ai kịp phát hiện cảnh báo. Sự cố nghiêm trọng đó đã thôi thúc chúng tôi áp dụng mô hình Progressive Delivery với Flagger và Istio, loại bỏ hoàn toàn việc điều phối traffic thủ công.
Thay vì để toàn bộ người dùng tiếp xúc với đoạn code chưa được kiểm chứng đầy đủ, bạn chỉ chuyển một phần nhỏ traffic thực tế—chẳng hạn như 5%—sang phiên bản mới. Bạn theo dõi dữ liệu đo từ xa (telemetry) theo thời gian thực để phát hiện các đợt tăng đột biến về tỷ lệ lỗi hay độ trễ. Nếu bản canary hoạt động ổn định, bạn sẽ tăng dần lưu lượng. Nếu xuất hiện lỗi, hệ thống sẽ tự động rollback ngay lập tức mà không cần con người can thiệp.
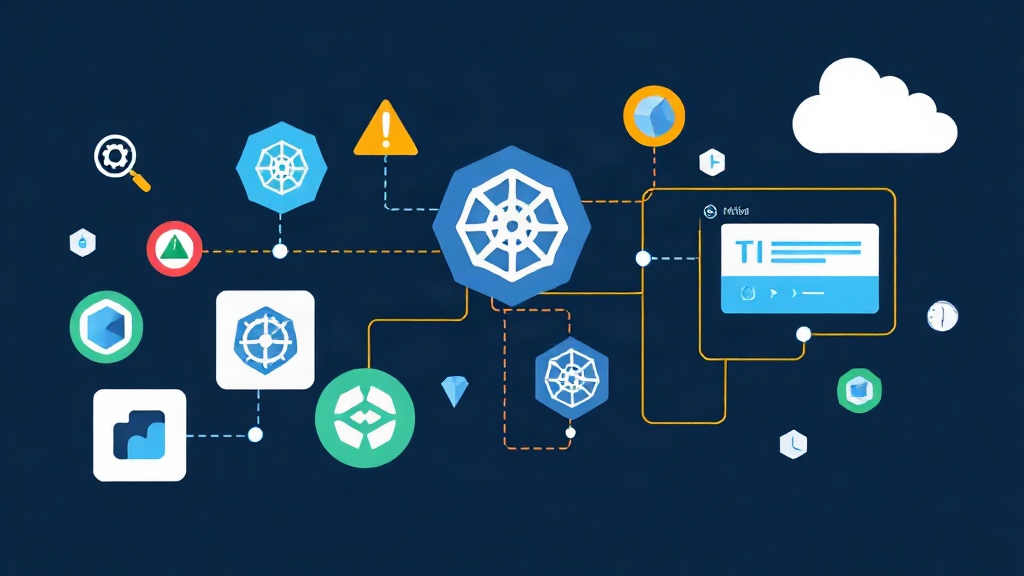
Các thành phần kết hợp với nhau như thế nào
Progressive Delivery so với Standard Rollout
Progressive Delivery kết hợp việc chuyển đổi lưu lượng traffic dần dần với các vòng lặp phân tích tự động. Một đợt rolling update thông thường chỉ dừng lại khi container bị crash hoặc fail một HTTP health check. Ngược lại, progressive rollout sẽ liên tục truy vấn các metric ứng dụng thực tế như tỷ lệ lỗi HTTP và độ trễ P99 trước khi chuyển thêm từng nhóm người dùng mới.
Flagger: Controller tự động hóa
Flagger là một Kubernetes operator có nhiệm vụ quản lý toàn bộ vòng đời của bản canary từ đầu đến cuối. Khi bạn cập nhật container image của một Deployment, Flagger sẽ đón chặn đợt release, khởi tạo một canary replica set độc lập và bắt đầu vòng lặp đánh giá:
- Định tuyến ban đầu từ 5%–10% traffic đến canary deployment.
- Truy vấn Prometheus mỗi 60 giây một lần dựa trên các ngưỡng SLO đã cấu hình.
- Tăng tỷ trọng traffic sau mỗi khoảng thời gian đánh giá thành công.
- Hoàn nguyên luồng định tuyến về các pod primary ổn định nếu vượt quá ngưỡng lỗi cho phép.
Istio: Data Plane cho Service Mesh
Các Service ClusterIP tiêu chuẩn của Kubernetes phân phối traffic ngẫu nhiên giữa các pod có cùng nhãn. Chúng không thể chia traffic theo tỷ lệ phần trăm như 90/10. Istio giải quyết vấn đề này ở Layer 7 thông qua các tài nguyên VirtualService và DestinationRule. Flagger sẽ thao tác động trên các routing rule này của Istio, giúp kỹ sư không bao giờ phải điều chỉnh trọng số traffic bằng tay.
Thiết lập hệ thống
Yêu cầu tiên quyết
Bạn cần một cụm Kubernetes chạy phiên bản 1.24 trở lên, quyền truy cập kubectl và đã cài đặt helm v3. Bạn cũng cần Prometheus để thu thập telemetry của mesh, vốn đã được tích hợp sẵn thông qua Helm chart kube-prometheus-stack tiêu chuẩn.
Cài đặt Istio
curl -L https://istio.io/downloadIstio | ISTIO_VERSION=1.20.0 sh -
cd istio-1.20.0
export PATH=$PWD/bin:$PATH

istioctl install --set profile=default -y

# Bật tính năng tự động inject Envoy sidecar cho namespace mục tiêu
kubectl label namespace default istio-injection=enabled --overwrite
Cài đặt Flagger
helm repo add flagger https://flagger.app
helm repo update

helm upgrade -i flagger flagger/flagger \
  --namespace=istio-system \
  --set meshProvider=istio \
  --set metricsServer=http://kube-prometheus-stack-prometheus.monitoring:9090
Trỏ trực tiếp metricsServer đến endpoint Prometheus trong cụm của bạn. Flagger sẽ truy vấn địa chỉ này trong mỗi khoảng thời gian phân tích để đánh giá trạng thái sức khỏe của bản canary.
Cấu hình Canary tự động
Deployment và Service cơ sở
Triển khai ứng dụng của bạn bằng một manifest Deployment thông thường. Flagger sẽ tự nhân bản tài nguyên này thành my-app-primary (phiên bản ổn định chuẩn) và quản lý các instance canary thay bạn.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: my-app
  namespace: default
spec:
  replicas: 2
  selector:
    matchLabels:
      app: my-app
  template:
    metadata:
      labels:
        app: my-app
    spec:
      containers:
      - name: my-app
        image: my-registry/my-app:1.0.0
        ports:
        - containerPort: 8080
        resources:
          requests:
            cpu: 100m
            memory: 128Mi
          limits:
            cpu: 500m
            memory: 512Mi
---
apiVersion: v1
kind: Service
metadata:
  name: my-app
  namespace: default
spec:
  selector:
    app: my-app
  ports:
  - port: 80
    targetPort: 8080
Tài nguyên tùy chỉnh Canary
Tài nguyên tùy chỉnh Canary kiểm soát các quy tắc tăng tiến lưu lượng, mức tăng traffic và tiêu chí rollback:
apiVersion: flagger.app/v1beta1
kind: Canary
metadata:
  name: my-app
  namespace: default
spec:
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  progressDeadlineSeconds: 120
  service:
    port: 80
    targetPort: 8080
    gateways:
    - istio-system/ingressgateway
    hosts:
    - my-app.example.com
  analysis:
    interval: 1m
    threshold: 5
    maxWeight: 50
    stepWeight: 10
    metrics:
    - name: request-success-rate
      thresholdRange:
        min: 99
      interval: 1m
    - name: request-duration
      thresholdRange:
        max: 500
      interval: 1m
Các chi tiết cấu hình quan trọng:
- interval (1m): Flagger thu thập và đánh giá metric mỗi phút một lần.
- threshold (5): 5 lần kiểm tra metric thất bại liên tiếp sẽ kích hoạt rollback ngay lập tức.
- maxWeight (50): Traffic chuyển sang bản canary đạt mức tối đa 50% trước khi được thăng cấp hoàn toàn lên bản primary.
- stepWeight (10): Mỗi lần kiểm tra thành công sẽ tăng thêm 10% traffic (10%, 20%, 30%, 40%, 50%).
- request-success-rate: Yêu cầu tỷ lệ HTTP thành công tối thiểu đạt 99% dựa trên telemetry của Envoy.
- request-duration: Độ trễ P99 phải duy trì dưới mức 500ms.
Kích hoạt quá trình Rollout
Áp dụng manifest Canary của bạn và đợi Flagger khởi tạo hoàn tất. Khi deployment primary đã sẵn sàng, hãy cập nhật container image để bắt đầu đợt release:
kubectl set image deployment/my-app \
  my-app=my-registry/my-app:2.0.0 \
  -n default
Theo dõi tiến trình trực tiếp trên terminal của bạn:
kubectl get canary my-app -n default -w

# NAME     STATUS        WEIGHT   LASTTRANSITIONTIME
# my-app   Progressing   10       2024-01-15T10:00:00Z
# my-app   Progressing   20       2024-01-15T10:01:00Z
# my-app   Progressing   30       2024-01-15T10:02:00Z
# my-app   Progressing   40       2024-01-15T10:03:00Z
# my-app   Progressing   50       2024-01-15T10:04:00Z
# my-app   Promoting     0        2024-01-15T10:05:00Z
# my-app   Succeeded     0        2024-01-15T10:06:00Z
Kiểm thử cơ chế Rollback
Đừng bao giờ tin tưởng một chính sách rollback nếu bạn chưa từng cố ý làm nó kích hoạt. Hãy deploy một phiên bản image được cấu hình để trả về lỗi 500 trên 10% request, sau đó theo dõi log từ controller của Flagger:
kubectl logs -n istio-system \
  -l app.kubernetes.io/name=flagger \
  --tail=100 -f | grep my-app
Khi các chỉ số lỗi được gửi về Prometheus, Flagger sẽ nhận diện sự vi phạm ngưỡng và lập tức dừng tiến trình:
Tạm dừng tiến trình my-app.default: request-success-rate 94.20 < 99
Tạm dừng tiến trình my-app.default: request-success-rate 93.80 < 99
Đang rollback my-app.default: đã chạm ngưỡng kiểm tra thất bại (5/5)
Canary thất bại! Đang scale down my-app.canary
Istio sẽ lập tức khôi phục định tuyến 100% traffic về my-app-primary. Phiên bản lỗi chỉ tác động đến 10% người dùng trong khung thời gian 5 phút thay vì làm sập toàn bộ cluster của bạn.
Viết Metric Gate tùy chỉnh theo nghiệp vụ
HTTP status code chưa thể phản ánh toàn bộ bức tranh hoạt động. Bạn có thể thiết lập gate cho đợt deployment dựa trên các metric Prometheus đặc thù của ứng dụng, chẳng hạn như tỷ lệ lỗi thanh toán hay độ trễ truy vấn cơ sở dữ liệu, bằng cách sử dụng MetricTemplate:
apiVersion: flagger.app/v1beta1
kind: MetricTemplate
metadata:
  name: checkout-error-rate
  namespace: default
spec:
  provider:
    type: prometheus
    address: http://kube-prometheus-stack-prometheus.monitoring:9090
  query: |
    sum(rate(http_requests_total{
      app="my-app",
      path="/checkout",
      status=~"5.."
    }[1m]))
    /
    sum(rate(http_requests_total{
      app="my-app",
      path="/checkout"
    }[1m])) * 100
Gắn metric template này vào định nghĩa Canary của bạn:
  analysis:
    metrics:
    - name: checkout-error-rate
      templateRef:
        name: checkout-error-rate
        namespace: default
      thresholdRange:
        max: 0.5
      interval: 1m
Nếu tỷ lệ lỗi thanh toán vượt quá 0.5% ở bất kỳ bước nào, Flagger sẽ đóng băng đợt release ngay tức khắc.
Kinh nghiệm thực chiến trên môi trường Production
Hãy đồng bộ chu kỳ scrape của Prometheus với tần suất phân tích của Flagger. Nếu Prometheus thực hiện scrape mỗi 30 giây một lần, khoảng thời gian 1 phút của Flagger sẽ đảm bảo có ít nhất hai điểm dữ liệu metric mới cho mỗi lần đánh giá. Nếu scrape 60 giây cho một lần kiểm tra 60 giây, bạn sẽ có nguy cơ truy vấn phải các phép tính cũ.
Các microservice có lượng traffic thấp cần được tạo traffic giả lập (synthetic traffic). Nếu service chỉ xử lý dưới 10 request mỗi giây, các metric của Flagger có thể dao động rất thất thường. Hãy tận dụng tính năng webhooks tích hợp sẵn của Flagger để chạy các công cụ tạo tải như ghz hoặc hey nhằm kiểm thử pod canary trong quá trình phân tích.
Những team ưa chuộng hình thức chuyển đổi dứt điểm hoàn toàn (all-or-nothing) vẫn có thể áp dụng chiến lược blue-green release. Bạn chỉ cần đặt stepWeight: 100 trong spec của Canary. Flagger sẽ chạy các bước đánh giá sức khỏe đối với ứng dụng ứng viên đang được cách ly trước khi chuyển toàn bộ 100% traffic sang cùng một lúc.
Tự động hóa phân tích canary giúp loại bỏ hoàn toàn cảm tính khỏi pipeline triển khai. Hãy xác định trước các tiêu chí độ tin cậy bằng mã nguồn, để Istio đảm nhận việc phân chia trọng số traffic và để Flagger tự động xử lý các trường hợp rollback.