Sự mong manh của các đoạn code chắp vá tích hợp AI
Sáu tháng trước, đội ngũ của chúng tôi rơi vào bế tắc trong vận hành. Mỗi ngày chúng tôi ngập trong khoảng 650 ticket gửi về—từ yêu cầu hỗ trợ thanh toán, phân loại sự cố cho đến các cảnh báo nghiêm trọng trên 14 database production. Giải pháp tạm thời ban đầu là một cụm script Python triển khai trên AWS Lambda. Chúng nhận payload từ webhook, gọi đến endpoint chat/completions của OpenAI rồi bắn bản tóm tắt cảnh báo vào Slack.
Kiến trúc đó gần như sụp đổ ngay lập tức. Một thay đổi schema không lường trước từ upstream đã làm lỗi quá trình parse JSON.
Lưu lượng tăng đột biến chạm ngưỡng rate limit của nhà cung cấp, khiến các callback webhook bị đẩy vào hàng đợi dead-letter trong im lặng. Tệ nhất là, mỗi lần team sản phẩm yêu cầu tinh chỉnh prompt, chúng tôi lại phải sửa code, chạy unit test ở local, review code và triển khai lại toàn bộ pipeline CI/CD. Chúng tôi đã cân nhắc Zapier và Make, nhưng cơ chế rẽ nhánh cứng nhắc của chúng hoàn toàn chào thua ngay khi cần đến bộ đệm bộ nhớ động (dynamic memory buffer), gọi tool đệ quy, hay truy vấn PostgreSQL có tham số.
Chúng tôi đã khai tử dàn Lambda và chuyển sang một cụm n8n self-hosted. Thay vì phải chắp vá từng đoạn script riêng lẻ, n8n coi các mô hình ngôn ngữ như những thành phần nguyên bản trong workflow. Nền tảng này tích hợp sẵn khả năng gọi tool, ngữ cảnh hội thoại ngắn hạn và các cơ chế bảo vệ khi thực thi. Trải qua sáu tháng với 110.000 workflow được xử lý, đây là những gì chúng tôi đúc kết được khi vận hành các AI pipeline ở quy mô production.
Các khái niệm cốt lõi: Cách n8n điều phối AI Agent
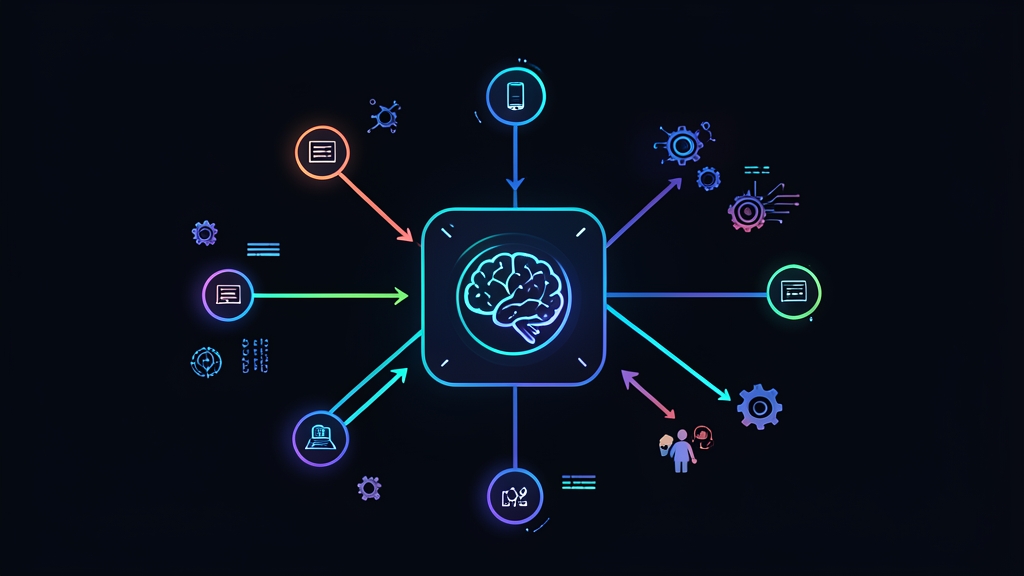
Đằng sau giao diện canvas trực quan, n8n tận dụng LangChain để quản lý trạng thái và các vòng lặp thực thi. Khác với các pipeline IF/ELSE tĩnh, một AI workflow trên n8n vận hành dựa trên một chu trình phản hồi tự chủ được hỗ trợ bởi bốn khối thành phần module hóa:
- AI Agent Node: Thành phần điều phối workflow. Node này tiếp nhận dữ liệu trigger gửi đến, đối chiếu với system instruction, chọn tool cần gọi, theo dõi output trung gian và quản lý việc retry khi thực thi.
- Language Model Connector: Engine suy luận (inference). Node này kết nối trực tiếp đến các nhà cung cấp như OpenAI, Anthropic, hoặc các endpoint Ollama nội bộ chạy Llama 3. Các siêu tham số (hyperparameter) như temperature, top_p và giới hạn token được tách biệt hoàn toàn khỏi logic nghiệp vụ của bạn.
- Memory Layer: Tầng cache ngữ cảnh. Các node như
Window Buffer Memorytheo dõi trạng thái qua nhiều lượt tương tác, tự động truy xuất lịch sử hội thoại mà không cần phải query thủ công vào bảng Redis hay Postgres riêng biệt. - Tools and Sub-workflows: Tầng thực thi. Bản thân LLM không thể tự đọc chỉ số replica lag đang chạy hay tự cập nhật ticket trên Jira. Tools đóng vai trò cầu nối bằng cách hiển thị các lệnh gọi HTTP, logic JavaScript tùy biến, hoặc toàn bộ sub-workflow của n8n dưới dạng các hàm có thể gọi được.
Việc tách bạch giữa công cụ truy xuất (retrieval tool) và logic prompt giúp tiết kiệm hàng giờ xử lý sự cố. Nếu bạn cần chuyển từ gpt-4o sang claude-3-5-sonnet, toàn bộ các tích hợp downstream phía sau vẫn hoàn toàn không bị ảnh hưởng.
Thực hành thực tế: Triển khai Agent phân loại sự cố
Hãy cùng điểm qua quy trình phân loại cảnh báo trên production của chúng tôi. Khi webhook cảnh báo kích hoạt, một AI agent sẽ parse stack trace, truy vấn microservice nội bộ để lấy metric hệ thống và quyết định xem có cần đánh thức kỹ sư đang trực on-call hay không.
Bước 1: Triển khai n8n Self-Hosted
Mô hình self-hosting giúp loại bỏ chi phí SaaS tính theo lượt thực thi và giữ toàn bộ dữ liệu payload nhạy cảm của khách hàng nằm trọn trong VPC riêng tư. Dưới đây là file docker-compose.yml rút gọn chạy trên một instance AWS EC2 t3.medium:
version: '3.8'

services:
  n8n:
    image: n8nio/n8n:latest
    restart: unless-stopped
    ports:
      - "5678:5678"
    environment:
      - N8N_HOST=n8n.internal.yourdomain.com
      - N8N_PORT=5678
      - N8N_PROTOCOL=https
      - NODE_ENV=production
      - WEBHOOK_URL=https://n8n.internal.yourdomain.com/
      - EXECUTIONS_DATA_PRUNE=true
      - EXECUTIONS_DATA_MAX_AGE=168
    volumes:
      - ./n8n_data:/home/node/.n8n
Khởi chạy container và kiểm tra xem quá trình migration database đã hoàn tất thuận lợi chưa:
docker compose up -d
docker compose logs -f n8n
Bước 2: Cấu hình AI Agent và Model Connector
Đăng nhập vào dashboard của n8n và khởi tạo một workflow canvas trống:
- Kéo thả một node trigger Webhook được cấu hình để nhận request
POSTtại/incident-alert. - Thêm một node AI Agent và đặt chế độ Agent thành Tools Agent.
- Kết nối một node OpenAI Chat Model vào cổng input model connector. Chọn
gpt-4ovà đặt temperature ở mức0.1. Mức temperature thấp là yếu tố then chốt ở đây để kết quả phân loại luôn có tính tiền định (deterministic). - Gắn một node Window Buffer Memory vào input memory. Đặt Session Key thành
{{ $json.body.incident_id }}để các cập nhật trong cùng một luồng sự cố luôn giữ được ngữ cảnh chung.
Bước 3: Trang bị Custom Tool cho Agent
Agent cần dữ liệu telemetry thời gian thực trước khi đưa ra quyết định phân loại. Hãy kết nối một node Custom n8n Tool vào cổng tool của AI Agent. Đặt tên tool là check_system_health và cấu hình một HTTP GET request đến microservice kiểm tra trạng thái nội bộ:
# Endpoint nội bộ được tool truy vấn
curl -X GET https://api.internal.local/v1/health \
  -H "Authorization: Bearer srv_token_production" \
  -H "Content-Type: application/json"
Đặt phần mô tả (description) của tool thành: “Lấy thông tin sử dụng connection pool của database hiện tại, mức tải CPU trung bình và hàng đợi tác vụ đang chờ xử lý. Gọi tool này khi phân loại payload lỗi.” Mô hình sẽ dựa vào phần mô tả này để quyết định thời điểm và lý do cần gọi endpoint. Hãy viết phần này thật rõ ràng và cụ thể.
Bước 4: Chuẩn hóa cấu trúc Output và các tác vụ Downstream
Output thô từ LLM có thể rất lộn xộn. Để tránh các câu giao đãi rườm rà như “Dưới đây là phân tích của bạn” làm crash các API downstream, hãy gắn một node Auto-fixing Output Parser với schema rõ ràng:
{
  "type": "object",
  "properties": {
    "severity": {
      "type": "string",
      "enum": ["CRITICAL", "WARNING", "INFO"]
    },
    "assigned_team": {
      "type": "string",
      "enum": ["database-infra", "frontend-core", "billing"]
    },
    "executive_summary": {
      "type": "string"
    },
    "recommended_immediate_action": {
      "type": "string"
    }
  },
  "required": ["severity", "assigned_team", "executive_summary"]
}
Truyền output vào một node Switch. Nếu severity == 'CRITICAL', pipeline sẽ kích hoạt ca trực PagerDuty và bắn thông báo vào kênh sự cố khẩn cấp trên Slack. Mọi trường hợp còn lại sẽ được điều hướng thẳng về Jira Service Desk dưới dạng ticket tồn đọng.
Quan sát và Best Practice từ môi trường Production
Nửa năm vận hành trên production đã giúp chúng tôi nhận ra những cạm bẫy hiếm khi gặp trong các bài hướng dẫn thông thường:
- Phòng chống vòng lặp gọi tool vô tận: Vào tuần thứ ba vận hành, một dòng log lỗi không rõ ràng đã khiến agent gọi API telemetry tới 24 lần liên tiếp trước khi timeout. Hãy thiết lập trường Max Iterations thành
3hoặc4để ngắt sớm các vòng lặp đệ quy. - Cắt giảm mạnh chi phí nhờ Semantic Caching: Các lượt ping kiểm tra trạng thái máy chủ lặp đi lặp lại rất tốn token. Việc đặt một node cache Redis phía trước agent đã giúp chúng tôi giảm hóa đơn OpenAI hàng tháng từ 1.840 USD xuống còn 1.065 USD—tiết kiệm 42% chi phí mà không làm giảm độ chính xác khi phân loại.
- Loại bỏ triệt để Markdown chưa được parse: Các mô hình ngôn ngữ rất hay bọc khối JSON trong ba dấu backtick. Nếu bỏ qua bước parse output, các webhook downstream của bạn sẽ bị lỗi khi nhận phải chuỗi markdown thô.
- Mạnh tay dọn dẹp Log thực thi: Dữ liệu các lượt chạy workflow của chúng tôi đã ngốn tới 38 GB dung lượng ổ đĩa chỉ trong chưa đầy ba tuần. Việc thiết lập
EXECUTIONS_DATA_PRUNE=truevà giới hạn lưu trữ ở mức 168 giờ (7 ngày) đã giúp các Docker volume không bị cạn kiệt inode.
Bước chuyển mình vượt ra khỏi các script tự viết
Từ bỏ việc bảo trì các đoạn script tự viết để chuyển sang điều phối trực quan dạng node đã giúp chúng tôi rút ngắn thời gian phản hồi sự cố trung bình từ 18 phút xuống dưới 90 giây. Khi đội ngũ kỹ thuật cần điều chỉnh ngưỡng định tuyến, các trưởng ca on-call có thể tinh chỉnh prompt và test payload trực tiếp ngay trên canvas. Đội ngũ kỹ sư nền tảng (platform engineer) có thể tập trung vào uptime, quyền hạn IAM và xoay vòng secret thay vì phải cặm cụi viết code bọc API lặp đi lặp lại.
Các model với nhiệt độ (temperature) thấp, giới hạn số lần lặp tool và schema output có cấu trúc rõ ràng sẽ mang lại năng lực suy luận phân tích của LLM, đồng thời vẫn giữ cho pipeline production của bạn luôn ổn định, dễ dự đoán và bền bỉ.