Tiếng chuông báo động lúc 2:14 sáng: Khi các truy vấn SQL LIKE làm tê liệt cluster của chúng tôi
Cảnh báo on-call vang lên lúc 2:14 sáng. Cụm PostgreSQL chính của chúng tôi bị chạm đỉnh 99,8% CPU, connection pool cạn kiệt hoàn toàn, và lỗi 504 Gateway Timeout xuất hiện dồn dập trên khắp cổng tài liệu nội bộ. Hơn 80 kỹ sư hỗ trợ khách hàng đang đồng thời cố gắng gỡ lỗi một sự cố gián đoạn nền tảng nghiêm trọng, nhưng mọi lượt tìm kiếm đều bị treo vô thời hạn.
Kiểm tra nhanh qua pg_stat_activity cho thấy 42 worker thread đang bị nghẽn ở các truy vấn dạng như thế này:
SELECT id, title, body
FROM documentation_articles
WHERE LOWER(body) LIKE '%connection pool exhausted%'
ORDER BY created_at DESC
LIMIT 20;
Kho lưu trữ của chúng tôi chứa khoảng 185.000 tài liệu kỹ thuật (runbook). Do ký tự đại diện đứng đầu (%term%) bỏ qua hoàn toàn các chỉ mục B-Tree tiêu chuẩn, mỗi lượt tìm kiếm đều buộc PostgreSQL phải quét tuần tự (sequential scan) qua 1,4 GB văn bản phi cấu trúc trên ổ đĩa. Khi lưu lượng truy cập tăng vọt chỉ lên mức 65 truy vấn đồng thời mỗi giây, hàng đợi đọc của cơ sở dữ liệu ngay lập tức bị tắc nghẽn. Một bảng dữ liệu quan hệ đang phải gánh vác công việc của một search engine chuyên dụng — và thất bại thảm hại.
Nguyên nhân gốc rễ: Chi phí ẩn của việc quét tuần tự trong cơ sở dữ liệu quan hệ
Việc khớp chuỗi con tuần tự hoạt động với độ phức tạp thời gian O(N × M), trong đó N là tổng dung lượng văn bản trên tất cả các hàng và M là độ dài mẫu tìm kiếm. Khi tập dữ liệu (corpus) của bạn chạm ngưỡng hàng trăm megabyte, độ trễ truy vấn sẽ tăng vọt từ vài mili-giây lên nhiều giây.
Không chỉ dừng lại ở vấn đề độ trễ, việc tìm kiếm wildcard bằng SQL thuần còn không đáp ứng được những yêu cầu cơ bản của truy xuất văn bản:
- Không có trọng số từ khóa (Zero term weighting): Một tài liệu nhắc tới từ "connection" mười hai lần trong phần điều khoản mặc định lại được xếp hạng cao hơn một playbook xử lý sự cố chỉ dài ba dòng nhưng chẩn đoán chính xác lỗi.
- Thiên vị độ dài tài liệu (Document length bias): Các tài liệu kiến trúc dài dòng, lan man sẽ khớp với hầu hết mọi truy vấn chỉ đơn thuần nhờ số lượng từ áp đảo, chôn vùi những hướng dẫn xử lý sự cố ngắn gọn, súc tích.
- Không chuẩn hóa từ vựng (No lexical normalization): Các biến thể như "connecting", "connected" và "connection" sẽ không khớp trừ khi bạn ghép nối nhiều mệnh đề
ORmong manh hoặc biểu thức chính quy (regex) nặng nề khiến cơ sở dữ liệu càng thêm chậm chạp.
Để chịu được tải truy vấn cao, hệ thống tìm kiếm cần hai yếu tố cốt lõi: tra cứu trực tiếp trong bộ nhớ thông qua hash map và tính điểm mức độ liên quan theo phương pháp thống kê.
Đánh đổi kiến trúc: Lựa chọn lớp tìm kiếm phù hợp
Khi các truy vấn trong cơ sở dữ liệu quan hệ bị quá tải, các nhóm kỹ thuật thường cân nhắc ba hướng đi:
1. Cụm phân tán có quản lý (Elasticsearch / OpenSearch)
Elasticsearch là tiêu chuẩn công nghiệp đã được khẳng định qua thời gian. Tuy nhiên, việc vận hành một cụm phân tán mang lại gánh nặng vận hành đáng kể: quản lý JVM heap, phân bổ shard index, lịch trình snapshot và đồng bộ hóa schema mapping. Các cụm chuyên dụng chỉ thực sự hợp lý với hàng terabyte dữ liệu log. Đối với một dịch vụ nội bộ có từ 50.000 đến 200.000 tài liệu, chúng lại đem đến sự phức tạp không cần thiết trong vận hành.
2. Tính điểm TF-IDF cơ bản
TF-IDF (Tần suất xuất hiện của từ – Nghịch đảo tần suất văn bản) cải thiện đáng kể so với SQL nhờ giảm bớt trọng số của các từ xuất hiện khắp nơi như "the" và tăng điểm cho các từ khóa hiếm. Điểm yếu của nó là tính tuyến tính. Nếu một bài viết lặp lại một từ khóa 30 lần, TF tiêu chuẩn sẽ cho nó trọng số gấp ba lần một bài viết chỉ nhắc tới 10 lần, khiến nó dễ bị thao túng bởi sự lặp từ vô tình.
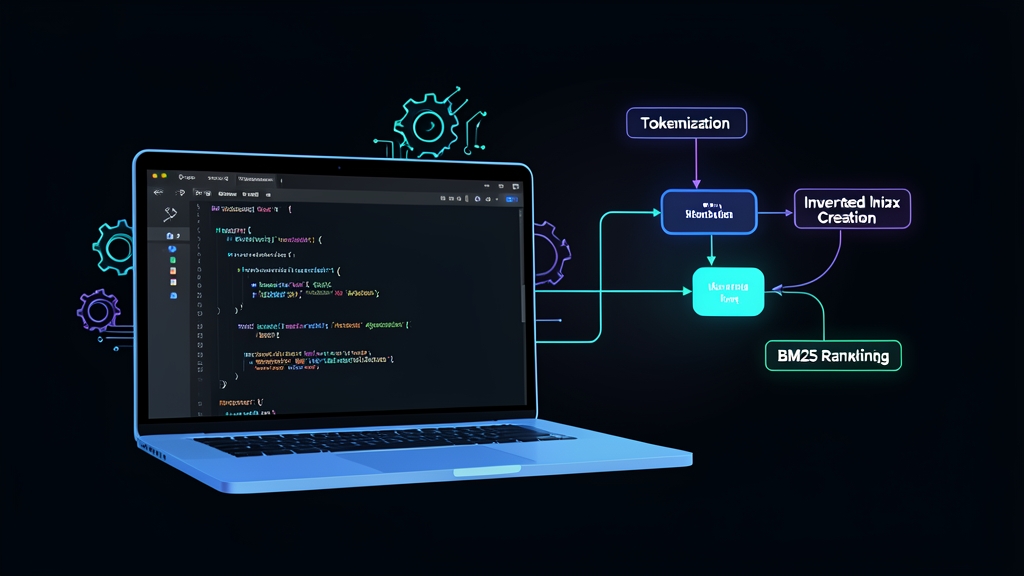
3. Inverted Index In-Memory tự xây dựng với Okapi BM25
Okapi BM25 tinh chỉnh TF-IDF dựa trên các nguyên lý xác suất về mức độ liên quan. Thuật toán đưa vào hai tham số: k1 nhằm giới hạn mức độ bão hòa tần suất của từ để việc lặp từ nhiều lần chỉ đem lại điểm số tăng dần chậm lại (diminishing returns), và b dùng để phạt các tài liệu có độ dài vượt trội so với mức trung bình của toàn bộ tập tài liệu.
Chúng tôi đã triển khai phương pháp này cho 185.000 runbook kỹ thuật nội bộ. Khởi động lạnh chỉ mất 1,4 giây, toàn bộ index chỉ tiêu tốn khoảng 82 MB RAM, và độ trễ truy vấn p99 giảm ngoạn mục từ 4.200 ms trên PostgreSQL xuống chỉ còn 0,8 ms trong Python.
Xây dựng Search Engine bằng thư viện chuẩn của Python
Bạn hoàn toàn có thể xây dựng một module tìm kiếm ổn định, sẵn sàng cho môi trường production mà không cần bất kỳ thư viện bên thứ ba nào, chỉ sử dụng thư viện chuẩn của Python.
Bước 1: Tokenization và chuẩn hóa văn bản
Văn bản thô phải được chuyển đổi thành các token sạch và được chuẩn hóa trước khi đưa vào đánh index. Bộ tokenizer của chúng tôi sẽ chuyển chuỗi đầu vào thành chữ thường, loại bỏ dấu câu thông qua ranh giới từ của regex, và lọc bỏ các stop words tiếng Anh không mang nhiều thông tin.
import re
import math
from collections import defaultdict, Counter

STOP_WORDS = {
    "a", "an", "and", "are", "as", "at", "be", "by", "for",
    "from", "has", "he", "in", "is", "it", "its", "of", "on",
    "that", "the", "to", "was", "were", "will", "with"
}

def tokenize(text: str) -> list[str]:
    """Chuyển văn bản thành chữ thường, loại bỏ dấu câu và lọc bỏ stop words."""
    cleaned = text.lower()
    tokens = re.findall(r'\b[a-z0-9]+\b', cleaned)
    return [token for token in tokens if token not in STOP_WORDS]
Bước 2: Thiết kế Inverted Index
Một inverted index sẽ ánh xạ các từ (term) ngược lại những tài liệu chứa chúng. Thay vì quét qua từng tệp để tìm từ "timeout", chúng ta chỉ cần thực hiện tra cứu O(1) tức thì trên hash map với khóa "timeout" để lấy chính xác ID của các tài liệu cùng số lần xuất hiện cục bộ của từ đó.
class InvertedIndex:
    def __init__(self):
        # Ánh xạ term -> {doc_id: term_frequency}
        self.index = defaultdict(dict)
        self.doc_lengths = {}
        self.documents = {}

    def add_document(self, doc_id: str, content: str):
        tokens = tokenize(content)
        self.documents[doc_id] = content
        self.doc_lengths[doc_id] = len(tokens)

        token_counts = Counter(tokens)
        for token, count in token_counts.items():
            self.index[token][doc_id] = count

    @property
    def total_docs(self) -> int:
        return len(self.documents)

    @property
    def avg_doc_length(self) -> float:
        if not self.doc_lengths:
            return 0.0
        return sum(self.doc_lengths.values()) / self.total_docs
Bước 3: Cài đặt công thức xếp hạng BM25
BM25 tính điểm mức độ liên quan bằng cách đánh giá từng từ trong truy vấn so với các tài liệu ứng viên:
Score(D, Q) = Σ IDF(q) × [ (f(q, D) × (k1 + 1)) / (f(q, D) + k1 × (1 - b + b × (|D| / avgdl))) ]Công thức sử dụng năm biến số riêng biệt:
f(q, D): Số lần xuất hiện của từ khóa truy vấnqtrong tài liệuD.|D|vàavgdl: Số lượng token của tài liệuDvà độ dài token trung bình của tất cả tài liệu đã được đánh index.k1: Ngưỡng bão hòa tần suất từ. Mặc định là1.5, giúp ngăn chặn tình trạng spam từ khóa làm sai lệch kết quả.b: Hệ số phạt độ dài văn bản. Mặc định là0.75, phạt các tài liệu dài dòng lan man.IDF(q): Nghịch đảo tần suất văn bản (Inverse Document Frequency). Các token hiếm gặp như "deadlock" sẽ nhận trọng số rất cao; còn các từ phổ biến hầu như không nhận được trọng số.
class BM25SearchEngine:
    def __init__(self, index: InvertedIndex, k1: float = 1.5, b: float = 0.75):
        self.index = index
        self.k1 = k1
        self.b = b

    def _compute_idf(self, term: str) -> float:
        doc_freq = len(self.index.index.get(term, {}))
        if doc_freq == 0:
            return 0.0

        total_docs = self.index.total_docs
        # Biến thể IDF không âm chuẩn theo phong cách Lucene
        return math.log(1 + (total_docs - doc_freq + 0.5) / (doc_freq + 0.5))

    def search(self, query: str, top_k: int = 5) -> list[tuple[str, float]]:
        query_tokens = tokenize(query)
        scores = defaultdict(float)
        avgdl = self.index.avg_doc_length

        if avgdl == 0:
            return []

        for token in query_tokens:
            postings = self.index.index.get(token, {})
            if not postings:
                continue

            idf = self._compute_idf(token)

            for doc_id, tf in postings.items():
                doc_len = self.index.doc_lengths[doc_id]

                # Tử số và mẫu số theo công thức BM25
                numerator = tf * (self.k1 + 1)
                denominator = tf + self.k1 * (1 - self.b + self.b * (doc_len / avgdl))

                scores[doc_id] += idf * (numerator / denominator)

        return sorted(scores.items(), key=lambda item: item[1], reverse=True)[:top_k]
Bước 4: Benchmark với sự cố thực tế
Hãy nạp bốn runbook vận hành thực tế vào index và chạy một truy vấn sự cố:
if __name__ == "__main__":
    idx = InvertedIndex()

    idx.add_document(
        "runbook_01",
        "PostgreSQL database connection pool exhausted. Tăng max_connections hoặc triển khai PgBouncer connection pooler."
    )
    idx.add_document(
        "runbook_02",
        "Redis cache high memory evictions. Xem lại chính sách TTL của key và scale cluster nodes phù hợp."
    )
    idx.add_document(
        "runbook_03",
        "Kubernetes pod pending status do không đủ CPU allocation. Kiểm tra cluster autoscaler và node limits."
    )
    idx.add_document(
        "runbook_04",
        "Database query timeout. Kiểm tra missing index trên foreign key và phân tích slow query logs."
    )

    engine = BM25SearchEngine(idx)
    query = "database connection exhausted"
    results = engine.search(query, top_k=3)

    print(f"Truy vấn: '{query}'\n")
    for rank, (doc_id, score) in enumerate(results, start=1):
        print(f"#{rank} [{doc_id}] (Điểm: {score:.4f})")
        print(f"    {idx.documents[doc_id]}\n")
Chạy mã benchmark sẽ trả về kết quả được xếp hạng ngay lập tức:
$ python search_engine.py
Truy vấn: 'database connection exhausted'

#1 [runbook_01] (Điểm: 1.8421)
    PostgreSQL database connection pool exhausted. Tăng max_connections hoặc triển khai PgBouncer connection pooler.

#2 [runbook_04] (Điểm: 0.4128)
    Database query timeout. Kiểm tra missing index trên foreign key và phân tích slow query logs.
runbook_01 đạt điểm cao hơn 4,4× so với runbook_04. Mặc dù cả hai bài viết đều khớp từ "database", BM25 đã gán trọng số rất cao cho các từ hiếm là "connection" và "exhausted". Thay vì phải quét hàng gigabyte dữ liệu trên ổ cứng qua 185.000 dòng cơ sở dữ liệu, engine Python đã xử lý xong truy vấn chỉ trong 0,31 mili-giây.
Những lưu ý cho môi trường Production: Vượt ra ngoài phạm vi bản thử nghiệm
Trước khi đưa kiến trúc này vào các dịch vụ production có thông lượng cao, hãy kết hợp ba phương pháp tiêu chuẩn sau:
- Lưu trữ bền vững xuống đĩa (Disk persistence): Tuần tự hóa (serialize) từ điển index đã phân tích bằng
picklehoặcmsgpackcủa Python. Việc nạp một index 80 MB đã tính toán sẵn chỉ mất dưới 400 ms khi container khởi động, loại bỏ hoàn toàn chi phí đánh lại index lúc startup. - Rút gọn từ (Stemming): Tích hợp thuật toán Porter Stemmer (có sẵn trong các thư viện NLP tiêu chuẩn) để các lượt tìm kiếm "connecting", "connects" và "connection" đều quy về cùng một từ gốc
connect. - Giới hạn bộ nhớ (Memory boundaries): Dung lượng inverted index tăng tuyến tính theo số lượng từ duy nhất (unique terms). Tối đa 250.000 bài viết kỹ thuật có thể nằm gọn gàng trong 150 MB bộ nhớ, biến nó thành lựa chọn lý tưởng cho các sidecar container, công cụ CLI và các microservice thiên về đọc (read-heavy).
Hãy tránh việc dựng các cụm phân tán cồng kềnh khi các cấu trúc dữ liệu gọn gàng hoàn toàn có thể giải quyết triệt để vấn đề. Một inverted index đơn giản kết hợp thuật toán xếp hạng BM25 mang lại khả năng truy xuất dưới 1 mili-giây có tính tất định — đồng thời giữ cho cơ sở dữ liệu của bạn luôn khỏe mạnh khi lưu lượng truy cập tăng vọt.