トランザクション処理と分析処理を同時に動かす際の問題
本番環境のMySQLまたはPostgreSQLデータベースがトランザクション処理で順調に動いている。そこにプロダクトマネージャーからリアルタイムの売上ダッシュボードが欲しいという依頼が来る。リードレプリカを構築する。レプリカにラグが発生する。ダッシュボードのデータが古くなる。プライマリで直接分析クエリを実行してみると、テーブルがロックされ、CPUが急騰し、アプリが500エラーを吐き始める。
標準的な解決策はデータパイプラインの構築だ:Kafka、Flink、別途ウェアハウス、また一つ増える運用負担、また一つ増える深夜2時の障害リスク。ほとんどのチームにとって、そのインフラは実際の問題に対して大げさすぎる。
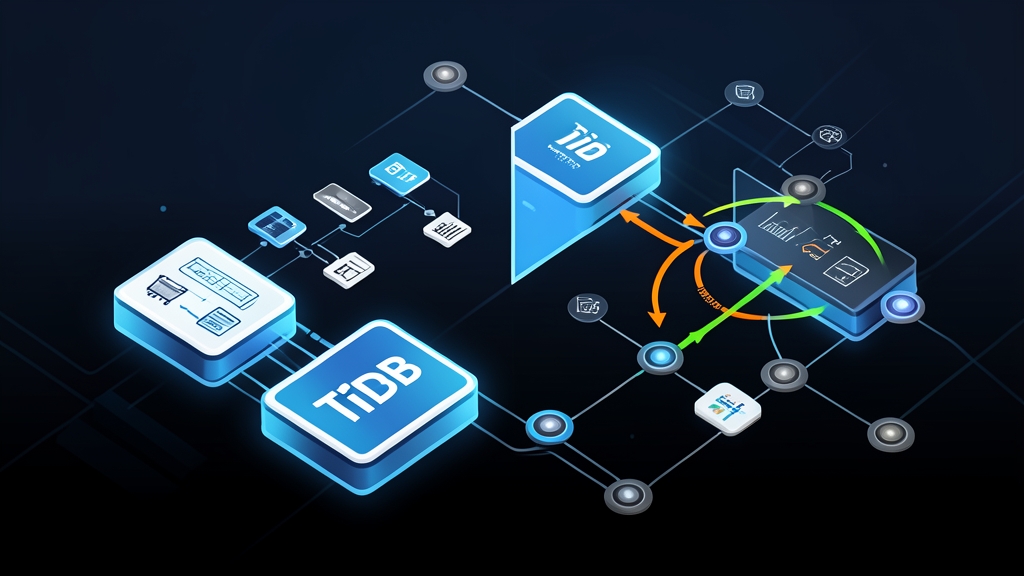
TiDBはこの問題をデータベース層そのもので解決する。同一クラスタからOLTPとOLAPを同時に実行できる — ETL不要、レプリケーションラグなし、管理が必要な別システムもなし。PingCAPはこれをHTAP(Hybrid Transactional/Analytical Processing)と呼んでいる。
TiDBが他と異なる点:コアアーキテクチャ
Composeの設定を一行書く前に、実際に何を起動しているのかを理解しておく価値がある。TiDBはMySQLのラッパーではなく、それぞれ明確な役割を持つ4つのコンポーネントからなる本格的な分散システムだ。
TiDB(SQLレイヤー)
設計上ステートレスな構造になっている。各TiDBノードはMySQLプロトコルの接続を受け付け、SQLをパースして実行計画を立て、ストレージ操作をTiKVまたはTiFlashに委ねる。ロードバランサーの後ろに複数ノードを並べることでSQLの水平スケーリングが実現できる — ノード間で調整すべき共有状態は存在しない。
TiKV(行ストレージ)
実際のデータはここに保存される。TiKVは行をRegion(デフォルトで96MBのチャンク)に分割し、各Regionの3つのRaftレプリカをノード全体に分散して保持する。これがOLTPエンジンだ:ポイントルックアップ、短いトランザクション、行レベルの更新処理を担当する。
TiFlash(列指向ストレージ)
TiFlashは行データを常に最新の状態で保持する列指向のシャドウコピーだと考えればよい。クエリプランナーが分析クエリ(フルスキャン、大量の集計、数百万行にわたるGROUP BY)を検出すると、自動的にTiFlashにルーティングされる。行ストアが書き込みを担当し、列ストアが分析を担当する。同期はRaftのラーナーレプリケーション経由で行われ、通常はサブ秒単位のラグとなる。
PD(Placement Driver)
オペレーションの頭脳と言える存在だ。PDはクラスタのメタデータを保存し、MVCC分離のためのタイムスタンプを発行し、負荷分散を維持するためにTiKVノード間でRegionをシャッフルする。読み取りか書き込みかを問わず、すべてのトランザクションはTSO(Timestamp Oracle)からタイムスタンプを取得するために最初にPDにアクセスする。
Docker ComposeでTiDBをデプロイする
ローカル環境のセットアップには2つの選択肢がある:TiUP Playground(よりシンプル)か手書きのComposeファイル(より細かい制御が可能)。今回は公式PingCAPイメージを使ったComposeを利用する — トポロジーが本番環境に十分近いため、ここで学んだことがそのまま活かせる。
前提条件
- Docker Engine 20.10以上 および Docker Compose v2
- ベースクラスタには最低8GBのRAMが必要。後でTiFlashを追加する場合は10GB以上を確保する
- ホスト上のポート4000(TiDB SQL)、2379(PD)、20160(TiKV)が空いていること
ステップ1:Docker Composeファイルの作成
mkdir tidb-docker && cd tidb-docker# docker-compose.yml
version: "3.8"
services:
pd:
image: pingcap/pd:v7.5.0
ports:
- "2379:2379"
- "2380:2380"
volumes:
- pd_data:/data
command:
- --name=pd
- --data-dir=/data
- --client-urls=http://0.0.0.0:2379
- --advertise-client-urls=http://pd:2379
- --peer-urls=http://0.0.0.0:2380
- --advertise-peer-urls=http://pd:2380
- --initial-cluster=pd=http://pd:2380
networks:
- tidb_net
tikv:
image: pingcap/tikv:v7.5.0
volumes:
- tikv_data:/data
command:
- --addr=0.0.0.0:20160
- --advertise-addr=tikv:20160
- --data-dir=/data
- --pd=pd:2379
depends_on:
- pd
networks:
- tidb_net
tidb:
image: pingcap/tidb:v7.5.0
ports:
- "4000:4000"
- "10080:10080"
command:
- --store=tikv
- --path=pd:2379
- --log-level=warn
depends_on:
- tikv
networks:
- tidb_net
volumes:
pd_data:
tikv_data:
networks:
tidb_net:ステップ2:クラスタの起動
docker compose up -d

# 起動を監視する — TiKVがPDに登録されるまで約20秒かかる
docker compose logs -f tidb接続する前に、TiDBのログにserver is running MySQL protocolが表示されるまで待つ。
ステップ3:接続と確認
# 任意のMySQLクライアントで接続する(デフォルトのrootにはパスワードなし)
mysql -h 127.0.0.1 -P 4000 -u root

# MySQLセッション内で:
SELECT tidb_version()\G
SHOW DATABASES;
-- クラスタの稼働状態を確認
SELECT * FROM information_schema.cluster_info;HTAPのテスト:同一データでのOLTPとOLAP
本当の価値は両方のパスに実際に負荷をかけたときに現れる。まずテーブルを作成してデータをロードする。
CREATE DATABASE shop;
USE shop;

CREATE TABLE orders (
  id BIGINT PRIMARY KEY AUTO_RANDOM,
  customer_id INT NOT NULL,
  product_id INT NOT NULL,
  amount DECIMAL(10,2) NOT NULL,
  status VARCHAR(20) DEFAULT 'pending',
  created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
  INDEX idx_customer (customer_id),
  INDEX idx_created (created_at)
);
-- テスト用に50万行を挿入する(一般的な開発マシンで約1分かかる)
INSERT INTO orders (customer_id, product_id, amount, status)
SELECT
FLOOR(RAND() * 10000),
FLOOR(RAND() * 500),
ROUND(RAND() * 490 + 10, 2),
ELT(FLOOR(RAND() * 3) + 1, 'pending', 'completed', 'cancelled')
FROM
(SELECT 1 UNION SELECT 2 UNION SELECT 3 UNION SELECT 4 UNION SELECT 5
UNION SELECT 6 UNION SELECT 7 UNION SELECT 8 UNION SELECT 9 UNION SELECT 10) a
CROSS JOIN
(SELECT 1 UNION SELECT 2 UNION SELECT 3 UNION SELECT 4 UNION SELECT 5
UNION SELECT 6 UNION SELECT 7 UNION SELECT 8 UNION SELECT 9 UNION SELECT 10) b
CROSS JOIN
(SELECT 1 UNION SELECT 2 UNION SELECT 3 UNION SELECT 4 UNION SELECT 5
UNION SELECT 6 UNION SELECT 7 UNION SELECT 8 UNION SELECT 9 UNION SELECT 10) c
CROSS JOIN
(SELECT 1 UNION SELECT 2 UNION SELECT 3 UNION SELECT 4 UNION SELECT 5
UNION SELECT 6 UNION SELECT 7 UNION SELECT 8 UNION SELECT 9 UNION SELECT 10) d
CROSS JOIN
(SELECT 1 UNION SELECT 2 UNION SELECT 3 UNION SELECT 4 UNION SELECT 5
UNION SELECT 6 UNION SELECT 7 UNION SELECT 8 UNION SELECT 9 UNION SELECT 10) e
CROSS JOIN
(SELECT 1 UNION SELECT 2 UNION SELECT 3 UNION SELECT 4 UNION SELECT 5) f
LIMIT 500000;現時点ではすべてのクエリがTiKVの行ストレージにアクセスしている。列指向エンジンを活用するには、ComposeファイルにTiFlashノードを追加し、テーブルの列指向レプリケーションを有効にする。
# docker-compose.ymlのservicesセクションに追記:
  tiflash:
    image: pingcap/tiflash:v7.5.0
    volumes:
      - tiflash_data:/data
    environment:
      - SERVICE_ADDR=tiflash
    command:
      - --config=/tiflash.toml
    # TiFlashの設定は通常マウントしたconfigファイルで渡す
    depends_on:
      - pd
      - tikv
    networks:
      - tidb_net
-- TiFlashノードが登録されたら、列指向レプリカを有効化する
ALTER TABLE orders SET TIFLASH REPLICA 1;
-- 同期の進捗を監視する
SELECT TABLE_NAME, REPLICA_COUNT, AVAILABLE, PROGRESS
FROM information_schema.tiflash_replica
WHERE TABLE_SCHEMA = 'shop';PROGRESS = 1.0になると、オプティマイザは集計クエリをTiFlashに自動ルーティングしながら、ポイントルックアップは引き続きTiKVにアクセスするようになる。
-- このクエリはTiFlashにルーティングされる(フルスキャン+集計)
SELECT
  status,
  COUNT(*) as count,
  SUM(amount) as revenue,
  AVG(amount) as avg_order
FROM orders
GROUP BY status;

-- EXPLAINで確認する
EXPLAIN SELECT status, COUNT(*), SUM(amount) FROM orders GROUP BY status;
-- 実行計画でcop[tiflash]上の"ExchangeSender"と"TableFullScan"を確認する
TiDBを使って学んだ実践的なヒント
スキーマ変更はMySQL互換
TiDBはオンラインDDLをサポートしている — ALTER TABLE ADD COLUMNは読み取りや書き込みをブロックしない。MySQLから移行する場合も、Flyway、Liquibase、golang-migrateといったツールが変更なしで動作する。既存のアプリケーションドライバ — pymysql、mysql-connector-java、go-sql-driver — も変更なしで接続できる。
AUTO_INCREMENTよりAUTO_RANDOMを使う
MySQLの習慣がここで落とし穴になることがある。主キーにAUTO_INCREMENTを使うと、すべての挿入が同じRegion(最大キーを格納しているRegion)に集中し、書き込みホットスポットが発生する。代わりにAUTO_RANDOMを使おう — 生成されたIDの上位ビットをランダム化することで、挿入をRegion全体に分散させる。
-- ホットスポットが発生しやすい(書き込みが多いテーブルには使わない)
CREATE TABLE events (id BIGINT AUTO_INCREMENT PRIMARY KEY, ...);

-- 書き込みをRegion全体に分散する
CREATE TABLE events (id BIGINT AUTO_RANDOM PRIMARY KEY, ...);
データインポートのワークフロー
データインポート用にCSVをJSONに素早く変換する必要があるときは、toolcraft.app/ja/tools/data/csv-to-jsonを使っている — 完全にブラウザ上で動作するため、データが外部に送信されない。CSVに顧客情報が含まれている場合はこれが重要だ。変換後は、TiDBのLOAD DATA LOCAL INFILEやtidb-lightningツールでバルクインポートを効率的に処理できる。
組み込みダッシュボードで監視する
TiDBにはhttp://localhost:2379/dashboard(PDが提供)にWebダッシュボードが搭載されている。スロークエリログ、クラスタトポロジ、Regionの分布、SQLの実行可視化ツールが確認できる — クエリがTiFlashではなくTiKVにルーティングされる原因を理解するのに役立つ。
TiDBが適している場面と適していない場面
TiDBがその複雑さに見合う価値を発揮するのは特定の条件が揃ったときだ:同一データセットに対する混合ワークロード、かつ大規模な場合。単一のPostgreSQLまたはMySQLノードが限界に達するほどのデータ量で、トランザクション書き込みと分析読み取りが同時に発生する場面がそれにあたる。容量が必要になったらTiKVノードを追加すれば、PDが自動的にRegionを再分散する。
小規模なプロジェクトであれば、適切なインデックス戦略とpg_analyticsを備えた単一のPostgresインスタンスの方がシンプルかつ低コストだ。TiDBの運用オーバーヘッド — 複数のコンポーネント、PDのクォーラム要件、TiFlashのストレージ重複 — は、本当にそれが必要な場面になって初めてコストに見合う。
このCompose構成は開発環境専用だ。本番環境への実際のデプロイはTiUP(PingCAPの公式クラスタマネージャー)を使い、ベアメタルまたはクラウドVM上で各コンポーネントに専用ノードを割り当て、PrometheusとGrafanaを可観測性のために組み込む形で行う。公式ドキュメントでは「Deploy TiDB Using TiUP」の項目でこのトポロジーを詳しく解説している。
まずDockerのセットアップから始め、実際のデータ量で実際のクエリパターンを実行し、本番クラスタに踏み切る前にEXPLAINの出力でHTAPが効果を発揮しているか確認しよう。