現実世界における課題:重複するサブネットとマルチテナントの競合
Ubuntu 22.04やDebian 12で稼働する一般的なエッジルーターやVPNコンセントレーターを想像してみてください。独立した2つの顧客、クライアントAとクライアントBの接続を終端する必要があります。両者とも専用の802.1Q VLAN(VLAN 100およびVLAN 200)を介してトラフィックを引き渡しています。しかしここで問題が発生します。両クライアントとも同一のRFC 1918プライベートサブネットである10.50.0.0/24の使用を求めており、それぞれのアップストリームゲートウェイは10.50.0.1に設定されています。
標準的なLinuxで両方のインターフェースにIPを割り当てると、即座にルーティングが破綻します。カーネルはどちらのインターフェースが10.50.0.1を保持しているのかを判別できません。クライアントB宛てのパケットがクライアントAの物理リンクに漏洩し、インバウンドの応答は暗黙的にドロップされます。また、双方のリンクからデフォルトルート(0.0.0.0/0)が提供された場合、カーネルはインターフェースのメトリックに基づいて一方のみを選択するため、もう一方のテナントは完全に通信不能に陥ります。その結果、非対称ルーティング、テナント間のセキュリティ漏洩、セッション切断といった深刻な問題に直面することになります。
根本原因の分析:モノリシックなグローバルルーティングテーブル
標準的なLinuxネットワーキングは、単一の転送情報ベース(FIB)に依存しています。アウトバウンドパケットを評価する際、カーネルはまずローカルテーブル(ID 255)を確認し、次にメインテーブル(ID 254)にフォールバックします。このモデルには、アーキテクチャ上の3つのボトルネックが存在します。
- プレフィックスの競合:2つのインターフェースが
10.50.0.0/24を宣言している場合、カーネルは競合を起こさずに別々のネクストホップを保持することができません。ルートの追加順序やメトリックの重み付けのみに基づいてルーティングが行われてしまいます。 - 単一のデフォルトゲートウェイ:ネットワークスタックは1つのプライマリエグレスパスを前提としています。複数のインターネット接続やMPLS回線を収容する場合、送信元ベースの複雑なポリシールールが必要になります。
- 広範なソケットの露出:
0.0.0.0にバインドされたデーモンは、デフォルトですべての物理ポートでリッスンするため、本来隔離されるべきネットワーク間で不正アクセスが発生するリスクがあります。
ルーティングレベルでの分離を行わなければ、単一のOSインスタンス上で重複するクライアントサブネットをホストすることは不可能です。
ソリューションの比較:ネットワーク名前空間 vs ポリシールーティング vs VRF
Linuxにおいて、ネットワークエンジニアは通常次の3つの選択肢を検討します。
- ネットワーク名前空間(netns):ネットワークサブシステム全体を複製します。インターフェース、ループバックデバイス、netfilterチェイン、ルーティングテーブルなどが多重化されます。Dockerコンテナなどには適していますが、netnsでは名前空間ごとに個別のSSHデーモン、SNMPエージェント、syslogプロセスを起動しなければなりません。10のテナントを管理する場合、各監視ツールのインスタンスを10個ずつ走らせる必要があります。
- ポリシーベースルーティング(PBR / ip rule):送信元IPやファイアウォールマークを用いてパケットをカスタムルーティングテーブルに一致させます。しかし、PBRは依然として脆弱です。動的ルーティングデーモンがカスタムテーブルを適切に更新することが難しく、複雑なiptablesマークはデバッグや運用の負担を著しく増大させます。
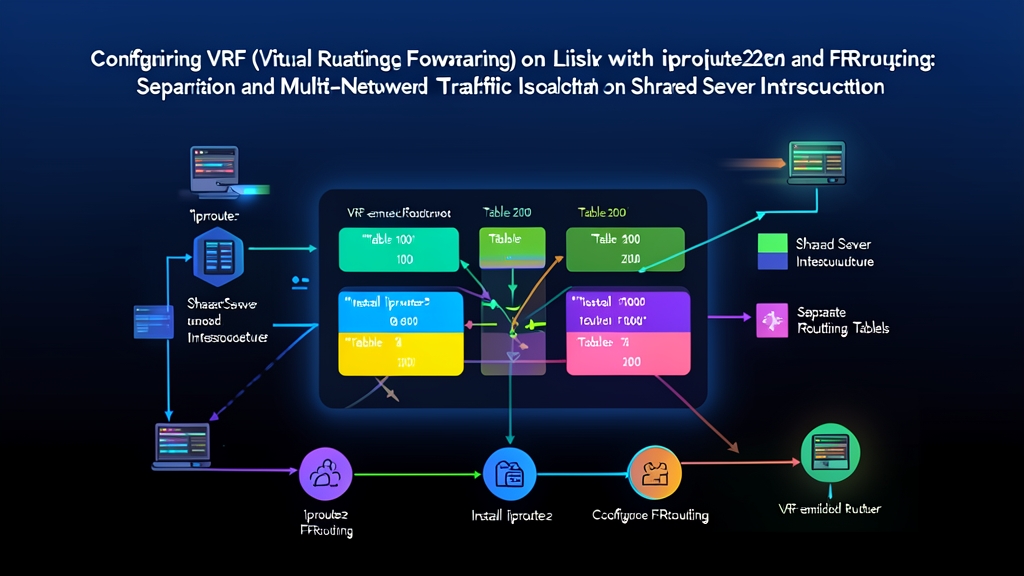
- Virtual Routing and Forwarding(VRF):メインの名前空間内で、マスターネットワークデバイスに直接紐づく仮想ルーティングテーブルを作成します。ユーザー空間は1つのまま管理可能です。サービスを個々のVRFにバインドでき、FRRouting(FRR)などのルーティングスイートもVRFテーブルをネイティブに処理できます。
本番環境向けのアプローチ:iproute2とFRRoutingによるカーネルVRF
カーネル内でVRFを直接動作させることで、標準的なx86ハードウェア上でスイッチ並みのルーティング分離を実現できます。ワイヤスピードのパケット転送性能を維持しながら、専用の仮想マシンを運用する場合と比較してテナントあたり1GB〜2GBのRAMを節約できます。
ステップ1:VRFモジュールの有効化とカーネルパラメータの設定
Linuxカーネル4.14以降では、追加設定なしで厳格なVRF分離が完全にサポートされています。まず、VRFカーネルモジュールをロードし、L3マスターデバイスの動作を設定します。
sudo modprobe vrf

# 厳格なFIBルックアップを強制し、グローバルサービス(SSHなど)がVRFポートで応答できるように設定
sudo sysctl -w net.vrf.strict_mode=1
sudo sysctl -w net.ipv4.tcp_l3mdev_accept=1
sudo sysctl -w net.ipv4.udp_l3mdev_accept=1
次に、2つのVRFマスターデバイスを作成し、それぞれを固有のルーティングテーブルIDにマッピングします。
# カスタムテーブル1001および1002にマッピングされたVRFマスターデバイスを作成
sudo ip link add dev vrf-tenant-a type vrf table 1001
sudo ip link add dev vrf-tenant-b type vrf table 1002

# マスターインターフェースを起動
sudo ip link set dev vrf-tenant-a up
sudo ip link set dev vrf-tenant-b up
ステップ2:インターフェースと重複IPサブネットのバインド
顧客側のインターフェース(ここではVLANインターフェースeth1.100およびeth1.200)をそれぞれのVRFマスターに関連付けます。両方のインターフェースに同一のIP 10.50.0.2/24を設定しても、ルーティングの競合は一切発生しません。
# VLAN 100をテナントAに所属させる
sudo ip link set dev eth1.100 master vrf-tenant-a
sudo ip addr add 10.50.0.2/24 dev eth1.100
sudo ip link set dev eth1.100 up

# VLAN 200をテナントBに所属させる
sudo ip link set dev eth1.200 master vrf-tenant-b
sudo ip addr add 10.50.0.2/24 dev eth1.200
sudo ip link set dev eth1.200 up
各テーブル内で独立したデフォルトルートを定義します。
sudo ip route add default via 10.50.0.1 dev eth1.100 vrf vrf-tenant-a
sudo ip route add default via 10.50.0.1 dev eth1.200 vrf vrf-tenant-b
ステップ3:ネットワーク分離の検証とテスト
ping、mtr、curlなどの診断ツールは、デフォルトでグローバルテーブルを参照します。テナントのルーティングコンテキスト内で操作を実行するには、ip vrf execを使用します。
# テナントAの隔離されたルートを確認
ip route show vrf vrf-tenant-a

# テナントBの隔離されたルートを確認
ip route show vrf vrf-tenant-b

# テナントA内でゲートウェイへpingを実行
sudo ip vrf exec vrf-tenant-a ping -c 3 10.50.0.1

# テナントB内でゲートウェイへpingを実行
sudo ip vrf exec vrf-tenant-b ping -c 3 10.50.0.1
各コマンドによって、ICMPプローブが適切なVLANタグを経由して送信されます。パケットカウンタは各サブインターフェースで個別に増加します。
ステップ4:FRRoutingでの動的BGPピアリング設定
本番環境では動的ルーティングが不可欠です。FRRouting(FRR)を使用すると、BGPセッションをLinuxのVRFドメインに直接バインドできます。
FRRをインストールし、BGPデーモンを有効化します。
sudo apt update && sudo apt install -y frr
sudo sed -i 's/bgpd=no/bgpd=yes/' /etc/frr/daemons
sudo systemctl restart frr
sudo vtyshでFRRのコマンドコンソールを起動し、自律システム(AS)65001配下の両テナント向けにBGPを設定します。
configure terminal

# テナントAのBGPインスタンス
router bgp 65001 vrf vrf-tenant-a
  neighbor 10.50.0.1 remote-as 65100
  neighbor 10.50.0.1 description PEERING-TENANT-A
  address-family ipv4 unicast
    redistribute connected
  exit-address-family
exit

# テナントBのBGPインスタンス
router bgp 65001 vrf vrf-tenant-b
  neighbor 10.50.0.1 remote-as 65200
  neighbor 10.50.0.1 description PEERING-TENANT-B
  address-family ipv4 unicast
    redistribute connected
  exit-address-family
exit

end
write memory
VRFごとのネイバーステータスを確認します。
vtysh -c "show bgp vrf vrf-tenant-a summary"
vtysh -c "show ip route vrf vrf-tenant-a"
vtysh -c "show ip route vrf vrf-tenant-b"
ステップ5:VRF設定の永続化
一時的なip linkコマンドによる設定は、再起動時に消失します。再起動後も設定を確実に維持するためにNetplanを使用します。以下のブロックを/etc/netplan/60-vrf.yamlに保存してください。
network:
  version: 2
  vlans:
    eth1.100:
      id: 100
      link: eth1
      dhcp4: false
    eth1.200:
      id: 200
      link: eth1
      dhcp4: false
  vrfs:
    vrf-tenant-a:
      table: 1001
      interfaces:
        - eth1.100
      routes:
        - to: default
          via: 10.50.0.1
    vrf-tenant-b:
      table: 1002
      interfaces:
        - eth1.200
      routes:
        - to: default
          via: 10.50.0.1
変更をテストして適用します。
sudo netplan applyこれにより、Linuxカーネルは独立したFIBテーブル間でルーティングの決定をクリーンに分離します。サーバー運用を単一の環境に集約したまま、安価なハードウェア上でキャリアグレードのトラフィック分離を実現できます。