Vấn đề thực tế: Trùng dải subnet và xung đột đa khách thuê
Hãy hình dung một router biên hoặc VPN concentrator điển hình chạy trên Ubuntu 22.04 hoặc Debian 12. Bạn cần tiếp nhận kết nối cho hai khách hàng độc lập: Client A và Client B. Cả hai đều chuyển lưu lượng qua các VLAN 802.1Q riêng biệt (VLAN 100 và VLAN 200). Điểm mấu chốt ở đây là gì? Cả hai khách hàng đều yêu cầu sử dụng cùng một dải subnet riêng RFC 1918: 10.50.0.0/24, với upstream gateway của họ đều đặt tại 10.50.0.1.
Việc gán cả hai interface trên Linux thông thường sẽ làm hỏng định tuyến ngay lập tức. Kernel không thể xác định interface nào sở hữu 10.50.0.1. Các gói tin gửi đến Client B bị tràn sang đường truyền vật lý của Client A. Các gói tin phản hồi chiều vào (inbound) bị drop trong âm thầm. Nếu cả hai đường truyền đều đẩy default route (0.0.0.0/0), kernel sẽ chọn một đường dựa trên metric của interface. Khách thuê còn lại sẽ hoàn toàn mất kết nối. Bạn sẽ phải đối mặt với định tuyến bất đối xứng (asymmetric routing), rò rỉ bảo mật giữa các khách thuê và đứt gãy phiên kết nối.
Phân tích nguyên nhân gốc rễ: Bảng định tuyến toàn cục nguyên khối
Hệ thống mạng Linux tiêu chuẩn dựa vào một Forwarding Information Base (FIB) duy nhất. Khi xử lý các gói tin chiều đi (outbound), kernel sẽ kiểm tra bảng local (ID 255) trước, sau đó chuyển sang bảng main (ID 254). Mô hình này tạo ra ba nút thắt cổ chai về mặt kiến trúc:
- Xung đột prefix: Nếu hai interface cùng khai báo
10.50.0.0/24, kernel không thể lưu trữ các next-hop riêng biệt mà không xảy ra xung đột. Nó chỉ định tuyến dựa trên thứ tự thêm route hoặc trọng số metric. - Chỉ có một default gateway: Network stack mặc định chỉ có một đường ra (egress) chính. Việc chạy nhiều kết nối internet hoặc MPLS đòi hỏi các quy tắc policy định tuyến dựa trên nguồn (source-based) phức tạp.
- Phơi bày socket trên diện rộng: Các daemon liên kết (bind) với
0.0.0.0mặc định sẽ lắng nghe trên mọi cổng vật lý, gây rủi ro truy cập trái phép giữa các mạng cần cô lập.
Nếu không có sự phân tách ở tầng định tuyến, việc đặt các subnet khách hàng trùng nhau trên cùng một phiên bản hệ điều hành là điều bất khả thi.
So sánh các giải pháp: Namespaces vs. Policy Routing vs. VRF
Các kỹ sư mạng thường cân nhắc ba giải pháp trên Linux:
- Network Namespaces (netns): Namespaces nhân bản toàn bộ hệ thống con mạng (networking subsystem). Chúng nhân đôi các interface, thiết bị loopback, netfilter chain và bảng định tuyến. Dù rất tuyệt vời cho Docker container, nhưng netns buộc bạn phải khởi chạy các tiến trình SSH daemon, SNMP agent và syslog riêng cho từng namespace. Quản lý 10 khách thuê riêng biệt đồng nghĩa với việc chạy 10 bản sao của từng công cụ giám sát.
- Policy-Based Routing (PBR / ip rule): Các bảng định tuyến tùy chỉnh khớp gói tin dựa trên IP nguồn hoặc đánh dấu tường lửa (firewall marks). Tuy nhiên, PBR khá mỏng manh. Các daemon định tuyến động khó có thể cập nhật bảng tùy chỉnh một cách sạch sẽ, và việc gắn nhãn iptables phức tạp khiến việc gỡ lỗi trở thành cơn ác mộng bảo trì.
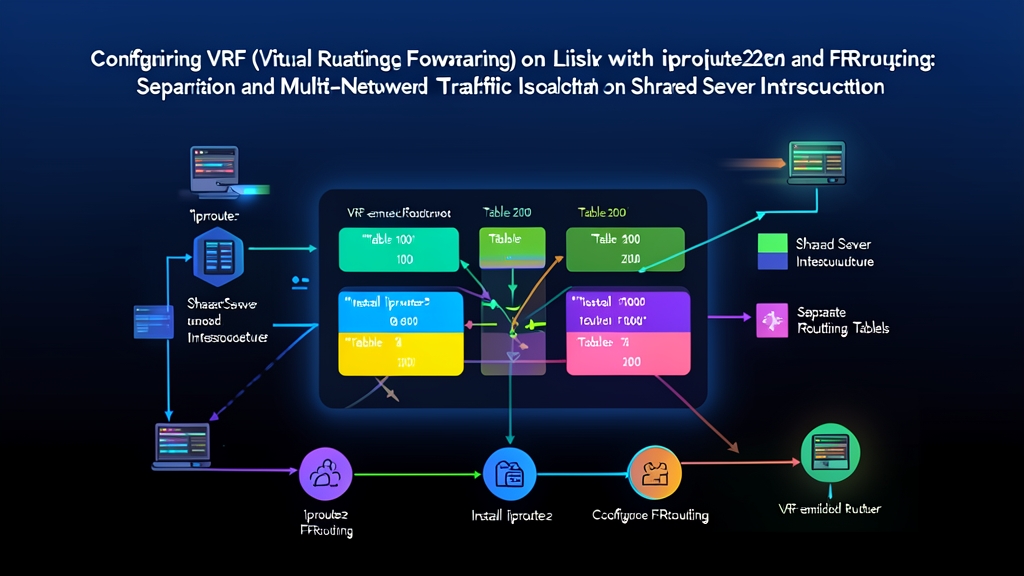
- Virtual Routing and Forwarding (VRF): VRF tạo ra các bảng định tuyến ảo được gắn trực tiếp vào các master network device bên trong namespace chính. Bạn chỉ cần quản lý một không gian người dùng (user space). Các dịch vụ có thể bind vào từng VRF riêng lẻ, và các bộ định tuyến như FRRouting (FRR) hỗ trợ xử lý bảng VRF một cách tự nhiên (natively).
Giải pháp thực tế cho môi trường Production: Kernel VRF với iproute2 và FRRouting
Việc chạy VRF trực tiếp trong kernel mang lại khả năng cô lập định tuyến chuẩn switch chuyên dụng trên phần cứng x86 tiêu chuẩn. Giải pháp này giúp tiết kiệm từ 1 GB đến 2 GB RAM cho mỗi khách thuê so với việc chạy các máy ảo chuyên dụng, trong khi vẫn duy trì tốc độ chuyển tiếp gói tin ở mức wire-speed.
Bước 1: Bật module VRF và các tham số Kernel
Linux kernel từ phiên bản 4.14 trở lên đã hỗ trợ hoàn toàn cơ chế cô lập VRF nghiêm ngặt (strict mode) ngay từ đầu. Đầu tiên, hãy nạp module VRF kernel và cấu hình hành vi cho thiết bị L3 master:
sudo modprobe vrf

# Áp dụng tra cứu FIB nghiêm ngặt và cho phép các dịch vụ toàn cục (như SSH) phản hồi trên cổng VRF
sudo sysctl -w net.vrf.strict_mode=1
sudo sysctl -w net.ipv4.tcp_l3mdev_accept=1
sudo sysctl -w net.ipv4.udp_l3mdev_accept=1
Bây giờ tạo hai thiết bị VRF master, map mỗi thiết bị với một ID bảng định tuyến riêng biệt:
# Tạo các thiết bị VRF master được map với các bảng tùy chỉnh 1001 và 1002
sudo ip link add dev vrf-tenant-a type vrf table 1001
sudo ip link add dev vrf-tenant-b type vrf table 1002

# Bật các interface master lên
sudo ip link set dev vrf-tenant-a up
sudo ip link set dev vrf-tenant-b up
Bước 2: Gắn Interface và các dải IP Subnet trùng nhau
Gắn các interface của khách hàng—ở đây là các interface VLAN eth1.100 và eth1.200—vào các VRF master tương ứng. Cả hai interface đều dùng chung IP 10.50.0.2/24 mà không gây ra bất kỳ xung đột định tuyến nào:
# Gán VLAN 100 vào Tenant A
sudo ip link set dev eth1.100 master vrf-tenant-a
sudo ip addr add 10.50.0.2/24 dev eth1.100
sudo ip link set dev eth1.100 up

# Gán VLAN 200 vào Tenant B
sudo ip link set dev eth1.200 master vrf-tenant-b
sudo ip addr add 10.50.0.2/24 dev eth1.200
sudo ip link set dev eth1.200 up
Định nghĩa các default route độc lập bên trong từng bảng:
sudo ip route add default via 10.50.0.1 dev eth1.100 vrf vrf-tenant-a
sudo ip route add default via 10.50.0.1 dev eth1.200 vrf vrf-tenant-b
Bước 3: Xác minh và kiểm tra khả năng cô lập mạng
Các công cụ chẩn đoán như ping, mtr, hoặc curl mặc định sẽ truy vấn bảng toàn cục. Hãy sử dụng ip vrf exec để thực thi các tác vụ bên trong ngữ cảnh định tuyến của từng khách thuê:
# Kiểm tra các route được cô lập cho Tenant A
ip route show vrf vrf-tenant-a

# Kiểm tra các route được cô lập cho Tenant B
ip route show vrf vrf-tenant-b

# Ping tới gateway bên trong Tenant A
sudo ip vrf exec vrf-tenant-a ping -c 3 10.50.0.1

# Ping tới gateway bên trong Tenant B
sudo ip vrf exec vrf-tenant-b ping -c 3 10.50.0.1
Mỗi lệnh sẽ gửi các gói tin ICMP probe qua thẻ VLAN tương ứng. Bộ đếm gói tin (packet counter) sẽ tăng độc lập trên từng sub-interface.
Bước 4: Cấu hình BGP Peering động trong FRRouting
Môi trường Production luôn đòi hỏi định tuyến động. FRRouting (FRR) liên kết trực tiếp các phiên BGP vào các domain VRF của Linux.
Cài đặt FRR và kích hoạt BGP daemon:
sudo apt update && sudo apt install -y frr
sudo sed -i 's/bgpd=no/bgpd=yes/' /etc/frr/daemons
sudo systemctl restart frr
Khởi chạy giao diện dòng lệnh FRR bằng sudo vtysh và cấu hình BGP cho cả hai khách thuê thuộc autonomous system 65001:
configure terminal

# BGP Instance cho Tenant A
router bgp 65001 vrf vrf-tenant-a
  neighbor 10.50.0.1 remote-as 65100
  neighbor 10.50.0.1 description PEERING-TENANT-A
  address-family ipv4 unicast
    redistribute connected
  exit-address-family
exit

# BGP Instance cho Tenant B
router bgp 65001 vrf vrf-tenant-b
  neighbor 10.50.0.1 remote-as 65200
  neighbor 10.50.0.1 description PEERING-TENANT-B
  address-family ipv4 unicast
    redistribute connected
  exit-address-family
exit

end
write memory
Kiểm tra trạng thái neighbor trên từng VRF:
vtysh -c "show bgp vrf vrf-tenant-a summary"
vtysh -c "show ip route vrf vrf-tenant-a"
vtysh -c "show ip route vrf vrf-tenant-b"
Bước 5: Lưu cấu hình VRF vĩnh viễn
Các lệnh ip link tạm thời sẽ biến mất sau khi khởi động lại hệ thống. Hãy sử dụng Netplan để đảm bảo cấu hình của bạn được giữ nguyên qua các lần reboot. Lưu khối cấu hình sau vào tệp /etc/netplan/60-vrf.yaml:
network:
  version: 2
  vlans:
    eth1.100:
      id: 100
      link: eth1
      dhcp4: false
    eth1.200:
      id: 200
      link: eth1
      dhcp4: false
  vrfs:
    vrf-tenant-a:
      table: 1001
      interfaces:
        - eth1.100
      routes:
        - to: default
          via: 10.50.0.1
    vrf-tenant-b:
      table: 1002
      interfaces:
        - eth1.200
      routes:
        - to: default
          via: 10.50.0.1
Kiểm tra và áp dụng các thay đổi:
sudo netplan applyLinux kernel cô lập hoàn toàn các quyết định định tuyến trên các bảng FIB độc lập. Bạn có được khả năng cô lập lưu lượng chuẩn cấp nhà mạng (carrier-grade) trên phần cứng tiết kiệm chi phí trong khi vẫn quản trị máy chủ tập trung tại một nơi.