アプローチの比較:フェデレーテッドクエリ vs 従来のETL
半年前、私たちのモノリシックなPostgreSQLデータベースはAWS RDS上で深刻なリソース限界に達しました。CPU使用率は常時85%前後に張り付き、ストレージIOPSも枯渇状態でした。システムの応答性を維持するため、課金およびサブスクリプション関連サービスを別のデータベースクラスタへと切り出しました。これによって差し迫った書き込みボトルネックは解消されたものの、新たな問題が発生しました。レポーティング機能の破綻です。これまで顧客プロファイルと課金履歴を簡単にJOINできていたクエリが、一夜にして物理的に分離された2つのデータベースを跨いで問い合わせる必要が生じたのです。
本番環境の設定に手を入れる前に、私たちは一般的な3つのパターンを比較・検討しました。
- 従来のETL/ELTパイプライン: Apache Airflowなどのオーケストレーターを運用するか、DebeziumとKafkaを用いた変更データキャプチャ(CDC)ストリーミングを構築し、毎晩課金テーブルを分析用レプリカへ同期する構成です。過去数年分におよぶ大規模なデータ分析には適していますが、12〜24時間の同期遅延が発生します。さらに致命的だったのは、カスタマーサポートチームがリアルタイムで請求書の問い合わせ内容を確認できなくなったことでした。
- アプリケーション層での結合: 顧客サービスAPIからアカウント情報を取得し、課金APIから請求書データを取得した上で、Node.jsやGoのメモリ上で配列同士を結合する方法です。レスポンスタイムは45msから1,200ms超へと大幅に悪化しました。ピーク時にはNode.jsのヒープ割り当てが1.5GBを超えて急増し、標準的なSQL句を用いたデータセット間の絞り込みやソートも行えなくなりました。
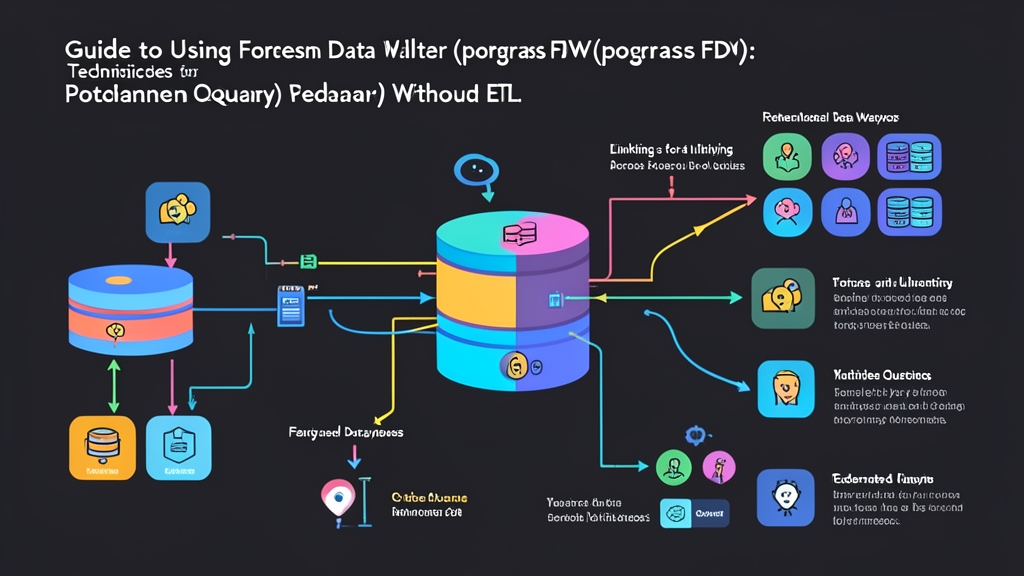
postgres_fdwによるフェデレーテッドクエリ: PostgreSQLネイティブのSQL/MED(Management of External Data)実装を活用し、リモートテーブルをローカルの仮想リレーションとしてマウントする方式です。クエリはデータベースエンジン内部で実行されます。PostgreSQLのコストベースプランナーがリモートへのプッシュダウンを処理し、安全な内部TCP接続経由でフィルタリング済みの結果セットのみをストリーミング転送します。
私たちは、運用ダッシュボードやカスタマーサポートツールの基盤としてpostgres_fdwを採用しました。壊れやすいcronワーカーや重複データの管理に悩まされることなく、社内ツールから同期遅延ゼロで課金データベースに対して直接アドホックなJOINクエリを実行できるようになりました。
メリットとデメリット:本番運用6ヶ月で判明した真実
月間1,200万件におよぶ課金レコードを対象にクエリを実行し続けたことで、Foreign Data Wrapperの真価を発揮するポイントと、監視を怠ると痛い目を見る落とし穴の両方が明らかになりました。
確かな強み・メリット
- 真のリアルタイム整合性: リモートクラスタの最新ディスク状態を直接読み取ります。顧客がクレジットカード情報を更新したりプランを解約したりした瞬間、レポーティングツール側でも即座にその変更が反映されます。
- 運用負債のゼロ化: 午前3時にAirflowのDAG停止で叩き起こされることも、Kafkaのコンシューマーラグアラートに怯えることも、数GB規模のテーブルを重複保持してEBSストレージを浪費することもありません。
- インテリジェントなプッシュダウン最適化: PostgreSQL 12以降、プランナーは集約関数(
SUM、AVG)やWHERE句、さらにはリモート同士のJOINまでターゲットノード側にプッシュダウンします。たとえば80万件の請求書テーブルにクエリを実行する場合、リモートクラスタ側で合致する12行に絞り込んでからネットワーク経由でパケットを1つだけ返送してくれます。 - 双方向の書き込みに対応: 外部テーブルは標準的な
INSERT、UPDATE、DELETEステートメントをサポートしています。専用のマイクロサービスミドルウェアを用意することなく、トランザクションを伴うデータ更新が可能です。
実運用上の課題・制限事項
- ネットワークレイテンシの増幅: データベースを跨いだ処理では、ラウンドトリップのオーバーヘッドが大きく影響します。プライマリクラスタが
us-east-1にあり、課金クラスタがeu-west-1にある場合、ネステッドループ結合によって10msのクエリが6秒のタイムアウトへと悪化しかねません。インスタンスは同一のアベイラビリティゾーン内に配置するか、専用のVPCピアリング接続内に収める必要があります。 - 古いコスト見積もりによる影響: デフォルトでは、ローカルのプランナーはリモート側のデータ分布状況を把握できません。そのため、固定された任意のテーブルサイズを前提に計算してしまいます。外部テーブルに対して定期的な
ANALYZEジョブを実行するか、use_remote_estimate 'true'を有効にしておかないと、インデックススキャンではなく破滅的なシーケンシャルスキャンが選択されるリスクがあります。 - コネクションプールの枯渇: ローカルのワーカースレッドは、外部サーバーに対して個別のクライアントセッションをオープンします。Webトラフィック急増時には、50個のローカルバックエンドプロセスがリモートクラスタに対して50本の直接接続を確立する可能性があります。PgBouncerを介さずに接続している場合、リモート側の
max_connectionsの上限にあっという間に達してしまいます。
本番環境における推奨アーキテクチャと設計ベストプラクティス
本番環境でForeign Data Wrapperを安定稼働させるには、厳格な運用上の安全策が欠かせません。
- データベースインスタンスの同一リージョン配置: 両クラスタを同一クラウドリージョンおよびVPCピアリングサブネット内に配置します。ラウンドトリップタイム(RTT)はサブミリ秒(0.8ms未満)を目標に設計してください。
- 外部スキーマの分離: 外部テーブルを
publicスキーマに配置するのは避けましょう。名前の衝突や意図しないスキーマ汚染を防ぐため、foreign_billingのような専用の名前空間に分離して整理します。 - 最小権限の原則に基づくロール運用: 外部ラッパーの接続に
postgresスーパーユーザーを絶対に使用してはいけません。ローカルユーザーは、特定のビューや運用テーブルに対するSELECT権限のみを持つ読み取り専用ロールへとマッピングします。 - 必要なカラムのみに絞り込んでインポート: 60カラムもある巨大なテーブルをそのまま取り込むのは避けてください。クエリで実際に参照する4〜5フィールドのみを取得することで、タプルのシリアライズオーバーヘッドを大幅に抑制できます。
スキーマ設計のフェーズでは、マイクロサービス間のデータスキーマの検証を頻繁に行いました。データインポート時にCSVからJSONへの迅速な変換が必要な場合は、toolcraft.app/ja/tools/data/csv-to-json を活用しています。ブラウザ上で完結するため、外部にデータが流出する心配がありません。こうした手軽なブラウザベースのツールを手元に用意しておくことで、外部DDL文を作成する前のスキーマ検証作業を格段にスピードアップできました。
postgres_fdwの実装ステップバイステップガイド
ここでは、分析用データベース(ローカル)を課金データベース(リモート)へ接続する手順を解説します。両環境ともにPostgreSQL 14以降が稼働している前提とします。
ステップ1:リモート側のソースクラスタを設定する
リモートの課金データベース(db-billing.internal)に接続します。読み取り権限のみを厳格に付与した、独立したサービス用ロールを作成します。
-- リモートクラスタ側での実行(課金DB)
CREATE ROLE fdw_reader WITH LOGIN PASSWORD 'SecureRemotePass123!';

-- スキーマのアクセス権限および読み取り専用権限の付与
GRANT USAGE ON SCHEMA billing TO fdw_reader;
GRANT SELECT ON billing.subscriptions TO fdw_reader;
GRANT SELECT ON billing.invoices TO fdw_reader;
ステップ2:拡張機能の有効化とリモートサーバーの登録
ローカルの分析用インスタンス(db-analytics.internal)に切り替えます。管理者権限を持つアカウントで以下のステートメントを実行してください。
-- ローカルクラスタ側での実行(分析DB)
CREATE EXTENSION IF NOT EXISTS postgres_fdw;

-- 外部サーバー接続の登録
CREATE SERVER billing_server
  FOREIGN DATA WRAPPER postgres_fdw
  OPTIONS (
    host 'db-billing.internal',
    port '5432',
    dbname 'billing_production',
    fetch_size '500'
  );
fetch_size '500'を設定することで、データセット全体をローカルメモリへ一括バッファリングするのではなく、500レコードずつのチャンク単位でストリーミング取得するようPostgreSQLへ指示します。
ステップ3:ローカルユーザーをリモート認証情報へマッピング
ローカルのユーザーアカウントを、先ほど作成したリモートデータベースの認証情報と紐付けます。
-- ローカルのanalystロールをリモートのfdw_readerロールへマッピング
CREATE USER MAPPING FOR analyst_user
  SERVER billing_server
  OPTIONS (
    user 'fdw_reader',
    password 'SecureRemotePass123!'
  );
ステップ4:独立したスキーマへ外部テーブルをインポートする
ローカル側に独立したスキーマを作成し、対象のテーブルを取り込みます。
-- 専用のローカル名前空間を作成
CREATE SCHEMA remote_billing;

-- 必要なテーブルのみをインポート
IMPORT FOREIGN SCHEMA billing
  LIMIT TO (subscriptions, invoices)
  FROM SERVER billing_server
  INTO remote_billing;
ネットワークペイロードのサイズをより厳密に制御したい場合は、手動で外部テーブルを定義し、利用するカラムのみを取り込むように設定します。
CREATE FOREIGN TABLE remote_billing.subscriptions (
  id BIGINT,
  customer_id BIGINT,
  plan_name VARCHAR(50),
  status VARCHAR(20),
  current_period_end TIMESTAMPTZ
)
SERVER billing_server
OPTIONS (schema_name 'billing', table_name 'subscriptions');
ステップ5:クエリ実行、JOIN結合、および性能検証
これで、標準的なSQL構文を用いてローカルの顧客アカウントとリモートテーブルを並べてクエリできるようになります。
SELECT
  c.id AS customer_id,
  c.full_name,
  c.email,
  s.plan_name,
  s.status
FROM public.customers c
JOIN remote_billing.subscriptions s ON c.id = s.customer_id
WHERE s.status = 'active'
ORDER BY s.current_period_end DESC
LIMIT 20;
述語プッシュダウン(Predicate Pushdown)が意図通りに機能しているか、必ずEXPLAIN ANALYZEで実行計画を確認してください。
EXPLAIN ANALYZE
SELECT * FROM remote_billing.subscriptions
WHERE status = 'past_due';
出力結果の中にRemote SQL: SELECT ... WHERE (status = 'past_due')のような行が含まれているか確認します。これが出力されていれば、データ転送前にリモートデータベース側でフィルタリングが処理されたことが証明され、ネットワーク帯域とローカルメモリの両方が保護されていることが確認できます。