So sánh các phương pháp tiếp cận: Federated Query và ETL truyền thống
Sáu tháng trước, cơ sở dữ liệu PostgreSQL nguyên khối (monolithic) của chúng tôi chạm ngưỡng giới hạn phần cứng trên AWS RDS. Mức sử dụng CPU luôn dao động quanh mức 85%, còn IOPS lưu trữ thì rơi vào tình trạng bão hòa. Để duy trì độ phản hồi của nền tảng, chúng tôi đã tách các dịch vụ thanh toán (billing) và gói đăng ký (subscription) sang một cụm cơ sở dữ liệu riêng biệt. Giải pháp này giải quyết được điểm nghẽn ghi dữ liệu trước mắt, nhưng lại làm gãy luồng báo cáo. Chỉ sau một đêm, các truy vấn đơn giản trước đây vốn chỉ cần join giữa hồ sơ khách hàng và lịch sử thanh toán giờ đây phải truy vấn trên hai cơ sở dữ liệu phân tách hoàn toàn về mặt vật lý.
Trước khi can thiệp vào bất kỳ cấu hình production nào, chúng tôi đã đặt ba mô hình phổ biến lên bàn cân so sánh:
- Pipeline ETL/ELT truyền thống: Sử dụng công cụ điều phối như Apache Airflow hoặc truyền dữ liệu thay đổi (CDC) qua Debezium và Kafka. Cách này sẽ đồng bộ các bảng billing sang một replica phân tích hàng đêm. Dù rất phù hợp cho các tác vụ phân tích nặng kéo dài nhiều năm, nó lại tạo ra độ trễ đồng bộ từ 12 đến 24 giờ. Tệ hơn nữa, đội ngũ hỗ trợ khách hàng không thể xác minh các khiếu nại hóa đơn theo thời gian thực.
- Join ở tầng ứng dụng (Application-level join): Gọi API dịch vụ khách hàng để lấy tài khoản, lấy hóa đơn từ API billing, rồi ghép các mảng dữ liệu trong bộ nhớ của Node.js hoặc Go. Thời gian phản hồi tụt dốc thảm hại từ 45ms lên hơn 1.200ms. Mức cấp phát bộ nhớ heap của Node.js tăng vọt vượt mốc 1,5GB vào giờ cao điểm, và chúng tôi mất đi khả năng lọc hay sắp xếp dữ liệu chéo bằng các mệnh đề SQL tiêu chuẩn.
- Federated query với
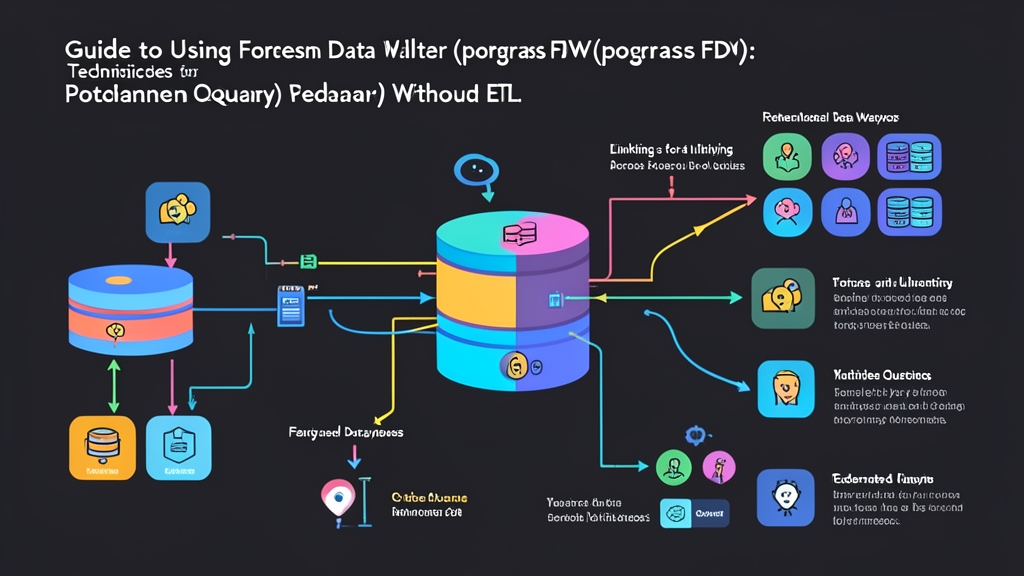
postgres_fdw: Tận dụng cơ chế chuẩn SQL/MED (Management of External Data) có sẵn của PostgreSQL để gắn kết (mount) các bảng từ xa thành các quan hệ ảo cục bộ. Các truy vấn được thực thi ngay bên trong database engine. Bộ tối ưu hóa truy vấn dựa trên chi phí (cost-based planner) của PostgreSQL sẽ xử lý việc đẩy điều kiện xuống máy chủ từ xa (remote pushdown), chỉ truyền tập kết quả đã được lọc qua kết nối TCP nội bộ bảo mật.
Chúng tôi đã chọn postgres_fdw cho các dashboard vận hành và công cụ hỗ trợ khách hàng. Thay vì phải duy trì các tiến trình cron worker mong manh cùng hai bản sao dữ liệu trùng lặp, các công cụ nội bộ của chúng tôi giờ đây có thể chạy trực tiếp các lệnh join ad-hoc với database billing mà không hề có độ trễ đồng bộ.
Ưu và nhược điểm: Những bài học sau 6 tháng chạy Production
Việc truy vấn trên 12 triệu bản ghi thanh toán mỗi tháng đã cho chúng tôi thấy rõ foreign data wrapper phát huy thế mạnh ở đâu, và những điểm nào có thể khiến bạn gặp rắc rối nếu không được giám sát chặt chẽ.
Các ưu điểm vượt trội
- Tính nhất quán thời gian thực chuẩn xác: Bạn đọc trực tiếp trạng thái dữ liệu trên đĩa của cụm máy chủ từ xa. Ngay khoảnh khắc khách hàng cập nhật thẻ tín dụng hoặc hủy gói, công cụ báo cáo của bạn sẽ ghi nhận tức thì.
- Không phát sinh nợ vận hành (zero operational debt): Không còn cảnh Airflow DAG bị lỗi lúc 3 giờ sáng, không có cảnh báo trễ tin nhắn (consumer lag) từ Kafka, và không lãng phí dung lượng ổ đĩa EBS để nhân bản các bảng dữ liệu hàng chục gigabyte.
- Tối ưu hóa pushdown thông minh: Từ PostgreSQL 12 trở lên, planner có khả năng đẩy các hàm tổng hợp (
SUM,AVG), mệnh đềWHERE, và thậm chí cả các phép join giữa hai bảng từ xa xuống node đích. Ví dụ: khi truy vấn một bảng có 800.000 hóa đơn, cluster từ xa sẽ tự lọc ra đúng 12 dòng khớp điều kiện trước khi gửi bất kỳ gói tin nào qua mạng. - Hỗ trợ ghi hai chiều (Bi-directional writes): Các foreign table hỗ trợ đầy đủ các câu lệnh
INSERT,UPDATE, vàDELETEtiêu chuẩn. Điều này cho phép thực hiện cập nhật mang tính giao dịch mà không cần xây dựng middleware microservice tùy biến.
Các hạn chế trong thực tế
- Khuếch đại độ trễ mạng (Network latency amplification): Các thao tác liên cơ sở dữ liệu khiến chi phí khứ hồi (round-trip) tăng cao. Nếu primary cluster đặt tại
us-east-1còn billing cluster lại nằm ởeu-west-1, các phép nested loop join sẽ biến một truy vấn 10ms thành một lỗi timeout dài 6 giây. Hãy luôn đặt các instance trong cùng Availability Zone hoặc liên kết qua VPC peering chuyên dụng. - Ước lượng chi phí không chính xác (Stale cost estimates): Theo mặc định, local planner không nắm được thông tin phân phối dữ liệu ở phía remote. Nó sẽ giả định kích thước bảng là một con số cố định tùy ý. Trừ khi bạn lên lịch chạy định kỳ
ANALYZEtrên các foreign table hoặc bậtuse_remote_estimate 'true', planner có thể đưa ra quyết định sai lầm khi chọn quét tuần tự (sequential scan) thay vì quét chỉ mục (index scan). - Cạn kiệt connection pool: Mỗi worker thread cục bộ sẽ mở một phiên client riêng biệt tới máy chủ từ xa. Vào thời điểm lưu lượng truy cập web tăng cao, 50 tiến trình backend cục bộ có thể mở đồng thời 50 kết nối trực tiếp đến cluster từ xa. Tình trạng này sẽ nhanh chóng làm chạm ngưỡng trần
max_connectionscủa máy chủ từ xa nếu bạn không đi qua PgBouncer.
Kiến trúc và cấu hình khuyến nghị cho môi trường Production
Để vận hành foreign data wrapper trên production một cách ổn định, cần tuân thủ các nguyên tắc an toàn vận hành nghiêm ngặt sau:
- Đặt các instance cạnh nhau: Đặt cả hai cluster trong cùng một cloud region và cùng mạng con VPC peering. Hướng tới mục tiêu thời gian khứ hồi (RTT) dưới 0,8ms.
- Cô lập các foreign schema: Tránh đặt foreign table trong schema
public. Hãy gom nhóm chúng vào các namespace riêng biệt nhưforeign_billingđể tránh xung đột tên gọi và làm rác schema chính. - Áp dụng nguyên tắc đặc quyền tối thiểu (least-privilege): Tuyệt đối không kết nối foreign wrapper bằng superuser
postgres. Hãy ánh xạ người dùng local sang một role chỉ có quyền đọc (read-only), chỉ được cấp quyềnSELECTtrên các view hoặc bảng nghiệp vụ được chỉ định. - Chỉ import các cột thực sự cần thiết: Tránh import toàn bộ các bảng cồng kềnh lên tới 60 cột. Chỉ lấy đúng 4 hoặc 5 trường mà truy vấn của bạn thực sự dùng tới để giảm thiểu chi phí tuần tự hóa (tuple serialization) dữ liệu.
Trong quá trình thiết kế schema, chúng tôi thường xuyên phải kiểm tra cấu trúc dữ liệu giữa các microservice. Mỗi khi cần chuyển đổi nhanh từ CSV sang JSON để import dữ liệu, tôi thường dùng toolcraft.app/vi/tools/data/csv-to-json — công cụ chạy hoàn toàn trên trình duyệt nên dữ liệu không bao giờ bị gửi ra ngoài máy của bạn. Việc tận dụng các công cụ tiện lợi trên trình duyệt giúp đẩy nhanh tốc độ kiểm tra schema trước khi bắt tay viết các câu lệnh DDL liên kết từ xa.
Hướng dẫn từng bước thiết lập postgres_fdw
Dưới đây là các bước kết nối cơ sở dữ liệu phân tích (analytics – local) với cơ sở dữ liệu thanh toán (billing – remote). Cả hai hệ thống đều chạy PostgreSQL 14 trở lên.
Bước 1: Cấu hình trên cụm máy chủ nguồn từ xa
Kết nối tới database billing từ xa (db-billing.internal). Tạo một service role riêng biệt với quyền đọc được giới hạn nghiêm ngặt:
-- Trên remote cluster (Billing DB)
CREATE ROLE fdw_reader WITH LOGIN PASSWORD 'SecureRemotePass123!';

-- Cấp quyền truy cập schema và quyền chỉ đọc (read-only)
GRANT USAGE ON SCHEMA billing TO fdw_reader;
GRANT SELECT ON billing.subscriptions TO fdw_reader;
GRANT SELECT ON billing.invoices TO fdw_reader;
Bước 2: Kích hoạt Extension và đăng ký Remote Server
Chuyển sang instance analytics ở local (db-analytics.internal). Chạy các câu lệnh sau với quyền quản trị:
-- Trên local cluster (Analytics DB)
CREATE EXTENSION IF NOT EXISTS postgres_fdw;

-- Đăng ký kết nối foreign server
CREATE SERVER billing_server
  FOREIGN DATA WRAPPER postgres_fdw
  OPTIONS (
    host 'db-billing.internal',
    port '5432',
    dbname 'billing_production',
    fetch_size '500'
  );
Việc đặt fetch_size '500' yêu cầu PostgreSQL stream dữ liệu về theo từng khối 500 bản ghi thay vì nạp toàn bộ tập dữ liệu vào bộ nhớ cục bộ.
Bước 3: Ánh xạ người dùng Local với thông tin xác thực Remote
Liên kết tài khoản người dùng local với thông tin đăng nhập của database từ xa:
-- Ánh xạ role analyst local sang role fdw_reader trên remote
CREATE USER MAPPING FOR analyst_user
  SERVER billing_server
  OPTIONS (
    user 'fdw_reader',
    password 'SecureRemotePass123!'
  );
Bước 4: Import các Foreign Table vào Schema riêng biệt
Tạo một schema riêng biệt ở local và import các bảng mục tiêu:
-- Tạo namespace riêng trên local
CREATE SCHEMA remote_billing;

-- Chỉ import các bảng cần thiết
IMPORT FOREIGN SCHEMA billing
  LIMIT TO (subscriptions, invoices)
  FROM SERVER billing_server
  INTO remote_billing;
Nếu bạn muốn kiểm soát chặt chẽ hơn dung lượng payload truyền tải qua mạng, hãy định nghĩa foreign table thủ công để chỉ lấy đúng các cột mà team của bạn cần đọc:
CREATE FOREIGN TABLE remote_billing.subscriptions (
  id BIGINT,
  customer_id BIGINT,
  plan_name VARCHAR(50),
  status VARCHAR(20),
  current_period_end TIMESTAMPTZ
)
SERVER billing_server
OPTIONS (schema_name 'billing', table_name 'subscriptions');
Bước 5: Truy vấn, Join và kiểm tra hiệu năng
Bây giờ bạn đã có thể truy vấn các bảng từ xa kết hợp với bảng khách hàng cục bộ bằng cú pháp SQL chuẩn:
SELECT
  c.id AS customer_id,
  c.full_name,
  c.email,
  s.plan_name,
  s.status
FROM public.customers c
JOIN remote_billing.subscriptions s ON c.id = s.customer_id
WHERE s.status = 'active'
ORDER BY s.current_period_end DESC
LIMIT 20;
Hãy luôn kiểm tra execution plan của truy vấn bằng EXPLAIN ANALYZE để đảm bảo cơ chế predicate pushdown hoạt động đúng như mong đợi:
EXPLAIN ANALYZE
SELECT * FROM remote_billing.subscriptions
WHERE status = 'past_due';
Quan sát kết quả đầu ra và tìm dòng có chứa Remote SQL: SELECT ... WHERE (status = 'past_due'). Dòng này xác nhận database từ xa đã tự lọc dữ liệu trước khi truyền tải qua mạng, giúp tiết kiệm băng thông mạng và tối ưu bộ nhớ local.